Seorang pengguna baru saja memberi tahu saya tentang ini:
Bahasa-bahasa Misaje memiliki (seperti kebanyakan bahasa di Kamerun) tanda nada pada vokal (lebih tepatnya tanda gramatikal).
Ketika Anda mengurutkan daftar kata berdasarkan kata, ini bekerja dengan sangat baik. Kata-kata diurutkan terlepas dari penandaan nada, dan ketika ada beberapa kata dengan huruf yang sama, kata-kata ini akan ditempatkan satu di bawah yang lain:
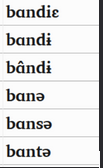
Ketika Anda mengurutkan daftar kata berdasarkan Akhir kata, vokal dengan penandaan tiba-tiba muncul bahkan di bawah huruf-huruf yang bukan bagian dari alfabet (r, x), dalam urutan penandaan (semua nada rendah terlebih dahulu, lalu semua nada tinggi, …):
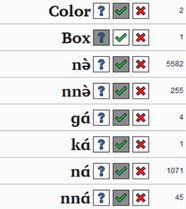
Bahasa ini menggunakan diakritik terurai, sehingga urutan di tangkapan layar kedua sangat masuk akal jika diakritik diperhitungkan. Sayangnya, “Abaikan diakritik saat memfilter daftar kata” tidak berpengaruh pada pengurutan, hanya pada pemfilteran. Sepertinya seharusnya memengaruhi pengurutan.
Beginilah konfigurasi alfabetnya:
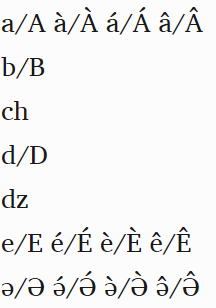
A user just alerted me to this:
The Misaje languages have (as most languages in Cameroon) tone marks on vowels (grammatical marks to be more precise).
When you sort the wordlist by word, this works very nicely. It sorts the words regardless of tone marking, and then when there are multiple words with the same letters it will put these below each other:
When you sort the wordlist by End or word, the vowels with markings suddenly appear even under the letters that are not part of the alphabet (r, x), in the order of markings (first all low tones, then all high tones, …):
The language uses decomposed diacritics, so the ordering in the second screenshot makes perfect sense if it is taking diacritics into account. Unfortunately, “Ignore diacritics when filtering wordlist” has no effect on sorting, only filtering. It seems like it should affect the sorting.
This is how the alphabet is configured:
Diterjemahkan secara otomatis dari English








