Halo, saya memiliki masalah yang sama dan ini adalah apa yang dikirimkan Doug Higby kembali di bulan Desember yang membantu saya memperbaiki masalahnya:
Data interlinear Anda disimpan di database dan diberi tag dengan bahasa glosa. Anda dapat melihat di direktori proyek Paratext Anda untuk melihat kode bahasa apa yang telah digunakan oleh interlinear Anda yang ada untuk memberi tag glosa.
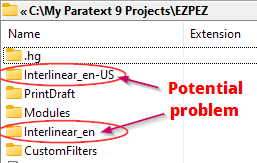
Misalkan semua glosa Anda hilang setelah upgrade ke 9.2 dan membuka kembali interlinear. Jika Anda belum bekerja di interlinear kosong yang baru, Anda hanya akan memiliki satu direktori yang ditampilkan di sini, en-US. Yang memiliki tag bahasa yang telah Anda gunakan. Untuk melihat glosa Anda lagi, Anda perlu membuat interlinear baru dengan salah satu dari dua cara:
- Membuat interlinear tanpa teks model, dan pilih en-US sebagai bahasa.
ATAU
- Membuat interlinear dengan teks model yang en-US. Anda dapat melihat bahasa teks model di dialog Open Resource:

Jika Anda memiliki dua direktori interlinear_XYZ dan tidak tahu mana kode bahasa yang telah Anda gunakan, cukup buka masing-masing direktori dan lihat mana yang memiliki lebih banyak file, dan dengan tanggal yang lebih lama. Pada tangkapan layar di atas, folder Interlinear_en hanya memiliki satu file di dalamnya yang hanya berukuran 500 byte. Yang lainnya memiliki beberapa kitab dengan ukuran file yang lebih besar. Jelas, en-US adalah bahasa yang perlu saya pilih saat mengatur interlinear jika saya ingin melihat glosa saya kembali.
Hello, I had the same problem and this was what Doug Higby sent back in December which helped me fix the problem:
Your interlinear data is stored in the database and tagged with the language of the glosses. You can look in your Paratext project directory to see what language code(s) your existing interlinear has been tagging the glosses with.
Let’s say that all your glosses went missing after upgrading to 9.2 and reopening the interlinear. If you haven’t worked yet in the new blank interlinear, you will only have one directory showing here, en-US. The one with the language tag you have been using. To see your glosses again, you will need to create a new interlinear in one of two ways:
- Create an interlinear with no model text, and select en-US as the language.
OR
- Create an interlinear with a model text that is en-US. You can see the language of the model text in the Open Resource dialog:
If you have two interlinear_XYZ directories and don’t know which is the language code you have been using, just open each directory and see which one has more files, and with past dates. In the screenshot at top, the Interlinear_en folder had only one file in it that was only 500bytes in size. The other one had multiple books with larger file sizes. Clearly, en-US is the language I need to select when setting up the interlinear if I want to see my glosses back.
Diterjemahkan secara otomatis dari English