anon570831, и любой, кто заглянет с той же проблемой:
Ваши данные интерлинеара хранятся в базе данных и помечены языком глосс. Вы можете посмотреть в каталоге вашего проекта Paratext, чтобы увидеть, с какими кодами языка ваша существующая интерлинеарная разметка помечает глоссы. Paratext создаёт подкаталог для хранения информации о разметке, который называется Interlinear_XYZ, где XYZ — это код языка. У вас может быть более одного:
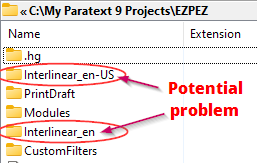
Часто бывает более одной папки. У вас могут быть глоссы на английском в одном проекте и на испанском в другом. Но когда у вас есть один или несколько вариантов английского (en-US, en-UK, en), они также хранятся отдельно, даже если это всё английский. Наличие двух баз данных на английском, как показано на изображении выше, может указывать на проблему.
Если у вас есть два каталога interlinear_XYZ и вы не знаете, какой из них является кодом языка, который вы использовали, просто откройте каждый каталог и посмотрите, в каком из них больше файлов и с более ранними датами. На скриншоте выше в папке Interlinear_en был только один файл размером всего 500 байт. В другом было несколько книг с более крупными файлами. Очевидно, en-US — это язык, который мне нужно выбрать при настройке интерлинеара, если я хочу снова увидеть свои глоссы.
Допустим, все ваши глоссы пропали после обновления до 9.2 и повторного открытия интерлинеара. Если вы ещё не работали в новом интерлинеаре, но заметили, что ваши глоссы отсутствуют, у вас, вероятно, будет показан только один каталог, допустим, en-US. Это тот, с которым вы использовали языковую метку. Чтобы снова увидеть свои глоссы, вам нужно будет создать новый интерлинеар одним из двух способов:
- Создайте интерлинеар без модельного текста и выберите en-US в качестве языка.
ИЛИ
- Создайте интерлинеар с модельным текстом, который является en-US. Вы можете увидеть язык модельного текста в диалоговом окне Open Resource (Открыть ресурс):

В любом случае, вы увидите свои пропавшие глоссы, когда снова откроете интерлинеар.








