0 votes
223 vues

Je crée des PDF pour une orthographe basée sur l'arabe. J'utilise la correspondance des chiffres pour convertir les chiffres latins de la sortie PT en chiffres arabes. Les grands nombres dans le texte biblique, contenant 4 chiffres ou plus, sont normalement écrits dans l'alphabet basé sur le latin avec un point comme séparateur de milliers. Ainsi, 120000 est écrit 120.000. En raison du point, PTXprint interprète cela comme deux nombres distincts, inversant l'ordre des éléments, alors que les chiffres arabes sont écrits dans le même ordre qu'en anglais, de gauche à droite. Ainsi, la sortie ressemble à ceci : ٠٠٠.١٢٠ (c'est-à-dire 000.120), alors qu'elle devrait lire ١٢٠.٠٠٠. Si dans PT je n'utilise pas de séparateur de milliers, ou une virgule au lieu d'un point, l'ordre est correct. Mais la virgule est utilisée avant les décimales ; j'ai besoin d'utiliser le point habituel dans les sorties en latin et en arabe. 

Donc, ma question est : y a-t-il un moyen de corriger ce problème dans PTXprint ?  

Traduit automatiquement depuis English
PTXprint par (123 points) | 223 vues

1 Réponse

+1 vote

Cela semble être un problème courant ! https://www.unicode.org/L2/L2017/17324-decimal-full-stop.pdf
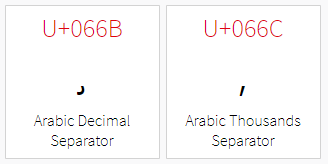
Ma suggestion serait de placer une règle dans changes.txt dans le projet de texte arabe pour changer le point en séparateur de milliers arabe approprié (\u066C) afin que toute la chaîne de chiffres et la ponctuation soient dans le même script et soient tous RTL. Elle devrait alors s'afficher comme prévu. Voici une règle qui devrait faire l'affaire :

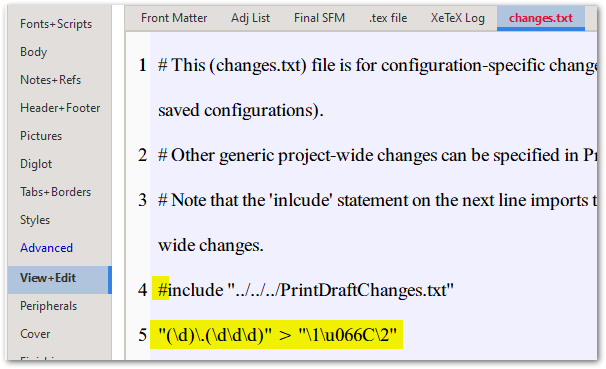
"(\d)\.(\d\d\d)" > "\1\u066C\2"

Cela signifie : trouver n'importe quel chiffre suivi d'un point suivi de 3 chiffres, et remplacer par la 1re correspondance (le chiffre unique) suivi du séparateur 066C, puis par la 2e correspondance (les 3 chiffres trouvés à gauche).

Une autre personne pourrait être en mesure d'améliorer cette expression régulière pour qu'elle fonctionne également avec des nombres beaucoup plus longs où il y a 2 séparateurs : 150.000.345.
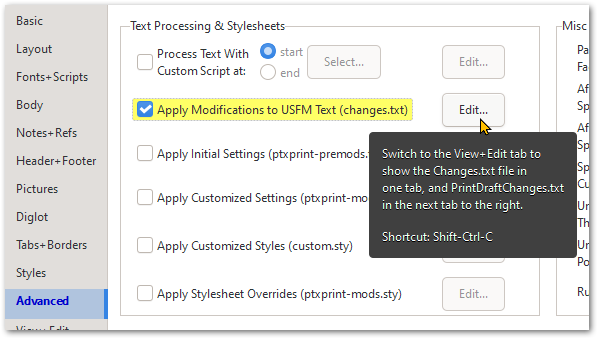
Puis, dans la fenêtre qui apparaît, collez la règle ci-dessus affichée à la ligne 5. (Notez que j'ai commenté la référence à PrintDraftChanges.txt car ce n'est probablement pas nécessaire) :
Dites-nous comment cela se passe... 

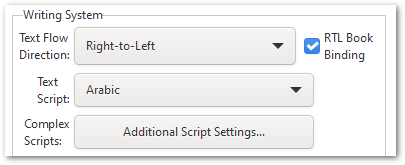
Assurez-vous que les paramètres Fonts+Scripts sont également configurés pour le RTL et l'arabe :
Traduit automatiquement depuis English

par (3,2k points)
modifié par
Merci, Mark, pour cette explication claire. Mais cela n'a pas fonctionné pour moi. J'ai copié le code ci-dessus dans changes.txt comme indiqué. La reliure RTL Book Binding est cochée. Mais la sortie est la même qu'avant. Notez que dans mon PT, le projet Ajami translittéré a également les chiffres (latins) dans le mauvais ordre : 000.120. Le problème est-il que le convertisseur d'encodage PT ne prend pas en compte de tels grands nombres ?
Traduit automatiquement depuis English

Mise à jour. J'ai corrigé une erreur dans le fichier .map/.tec du convertisseur afin que les chiffres apparaissent maintenant dans le bon ordre dans la sortie convertie dans PT : ١٢٠.٠٠٠
J'ai vérifié que le code que vous avez suggéré est correct dans changes.txt. Pourtant, dans la sortie PTXprint, l'ordre est toujours incorrect, cette fois avec les chiffres individuels inversés également :  ٠٠٠٬٠٢١ (c'est ainsi que cela a été collé, mais dans le PDF, la virgule est surélevée). Notez que la police et le script sont correctement configurés. D'autres suggestions ?
Merci.
Traduit automatiquement depuis English

Questions connexes

0 votes
1 réponse 142 vues
Lors de la configuration d'un document d'orthographe arabe, il semble que je doive appliquer la correspondance des chiffres à tous ... au document, c'est-à-dire à tous les styles ?
Kirk 123 posée août 28, 2024
0 votes
1 réponse 191 vues
Les numéros de page et les numéros de chapitre ne sont pas alignés. Comment corriger ce problème (voir la pièce jointe) ? Numéros de page et de chapitre non alignés1088×234 35.3 KB
anon441204 250 posée mai 13, 2021
0 votes
2 réponses 303 vues
J'essaie d'imprimer des Écritures en Ajami (police arabe). Mais toutes les consonnes s'impriment individuellement au lieu d' ... à ceci : Elle devrait ressembler à ceci : Merci !
Kirk 123 posée juil. 12, 2024
0 votes
5 réponses 421 vues
I have an Arabic script project which has 3 levels of quotes: These have the following Unicode ... Paratext, because down-the-road outputs will do the right thing?
jeffh 1,4k posée juil. 29, 2019
0 votes
3 réponses 703 vues
When a new PT project or book is created, verse numbers are automatically provided as arabic numerals (1,2,3,4 ... system for verse numbers. Is this possible? Thanks. Dennis
anon835853 166 posée août 5, 2015
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
For we were all baptized by one Spirit so as to form one body—whether Jews or Gentiles, slave or free—and we were all given the one Spirit to drink.
1 Corinthians 12:13
3,045 questions
6,005 réponses
5,671 commentaires
2,026 utilisateurs



