Учитывая, что команды начинают использовать Glyssen для предварительной обработки своих текстов Нового Завета, чтобы определить каждого говорящего в тексте для драматизированной записи, я задумался, стоит ли использовать эту работу для АВТОМАТИЧЕСКОЙ разметки Слов Иисуса \wj … \wj* в проекте Paratext.
Glyssen создает файл Excel с необходимыми данными, который выглядит так:
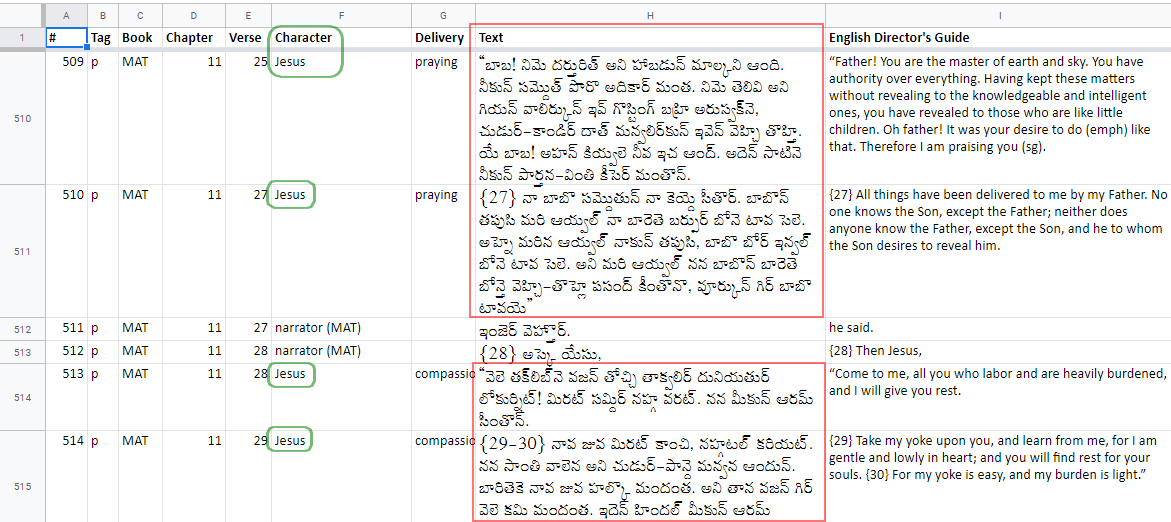
image.png1171×522 59.8 KB
Поэтому, вероятно, относительно легко будет создать скрипт для поиска этих мест в тексте и обертывания их разметкой \wj … \wj*
Я сам попробовал что-то простое с несколькими сгенерированными таблицами CC (Custom Commands) и мне удалось успешно разметить 88% из 1901 вхождения Слов Иисуса. Однако это все еще оставляет более 200 мест, где мне нужно будет вносить исправления вручную. Не удовлетворившись этим результатом и желая сэкономить время других в будущем, сделав процесс автоматизированным, полным и более надежным, я задумался о создании Custom Script (на Python), который мог бы выполнять эту задачу непосредственно из Paratext.
Большинство «неудачных» случаев с методом CC связаны с наличием другой разметки, такой как \w angel|angels\w* или \f сноски и \x перекрестные ссылки, встроенной в искомый текст. У меня есть несколько идей, как обойти это с помощью регулярных выражений (и поиска начала и конца строк, а не всей строки и т. д.), но это выходит за рамки CC и потребует использования кода на Python, чтобы сделать это возможным.
НО, прежде чем я буду пытаться создать Custom Script для этого, я想知道, не делал ли кто-нибудь уже что-то подобное. Я не хочу изобретать велосипед! Смотря на примеры скриптов, поставляемых с Paratext, ближайшим, что я вижу, является TransferParallelPassageRefs.py от DRM.
Есть ли у кого-нибудь еще что-то подобное, или есть ли кто-то более талантливый в программировании на Python с ScriptureObjects, кто мог бы собрать это лучше, чем я? Я готов написать псевдокод, если это поможет. И я готов учиться и работать с кем-то еще над этим…








