0 голосов
655 просмотров

При печати модуля для языка, использующего арабское письмо, я заметил, что ссылки на стихи печатаются неправильно. Вот запись из моего модульного файла SFM:

\s God creates the world
\r ($(GEN 1:1-27))
\ref GEN 1:1-27

Вот результат, который я получил из PTXprint 2.3.45:

Скриншот 2023-10-03 090955

(Дословно: «1:1-27 Бытие» — часть с главой/стихом печатается так же, как в LTR-языках.)

Но справа налево это должно быть: название книги, пробел, номер главы, двоеточие, начальный стих, дефис, конечный стих

Теперь, когда я ищу это, я вижу ту же ошибку в заголовках параллельных мест.

Переведено машиной с языка English
PTXprint от (131 очков) | 655 просмотров

9 Ответов

0 голосов

Есть довольно много вариантов того, где здесь может возникать ошибка:

  1. Документ действительно настроен на RTL, или \s — это то, что указано в модуле? У нас есть возможность сделать то, что я называю «серийный диглот» (переключение всех языковых настроек для соответствующих частей публикации), но это не происходит автоматически.
  2. Ссылка ($(GEN...)) может генерировать неправильный промежуточный вывод. Для проверки: Можете ли вы посмотреть на вкладку final USFM и проверить, выглядит ли она там правильно или неправильно?
  3. Возможно, подаются какие-то байты переключения направления Unicode, которые что-то путают. Для проверки: Можете ли вы ввести (не копировать и вставить) диапазон чисел в дополнительный \r и посмотреть, работает ли это?
  4. Допускаю, что по какой-то причине \r может забывать, что документ является RTL. Для проверки: можете ли вы ввести диапазон в какую-то другую строку, где форматирование выполняется правильно?
Переведено машиной с языка English
от (1,1тыс. очков)
0 голосов

Спасибо за то, что вы так быстро взялись за это.

  1. Это полностью RTL-документ. Я не помню, приходилось ли мне сообщать об этом PTXprint, или он получил это из Paratext.

  2. Можете ли вы сказать мне, как это сделать? Я не вижу этой вкладки в PTXprint.

  3. и 4. Когда я ввожу ссылку на стих в \s или \r, она выводится неправильно тем же самым образом. Но в остальном, похоже, он находится в режиме RTL. Другие слова выводятся в правильном RTL-порядке.

\s ببب پیدایش ۱:۱-۲۷ ییی
\r ($(GEN 1:1-27))
\r پیدایش ۱:۱-۲۷
\r قیرست سکند
\ref GEN 1:1-27

Скриншот 2023-10-03 113302

Переведено машиной с языка English
от (131 очков)
0 голосов
Переведено машиной с языка English
от (3,2тыс. очков)

А, вот оно где.

Да, он настроен на «Справа налево» (Right-to-Left) и с RTL-переплетом.

Переведено машиной с языка English
0 голосов

Так что, э-э… по крайней мере, это последовательно!
Очень странно!

Переведено машиной с языка English
от (1,1тыс. очков)
0 голосов

RTL-текст странный. Числа на самом деле отображаются в формате LTR. Так что, если бы вы убрали двоеточие и дефис, правильное отображение этой строки чисел было бы таким:
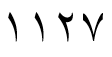
image то есть «1127», читаемое слева направо

Если я вставлю текст из вашего \s выше в Word, я получу следующее (ровно то, что вы видите в PTXprint):
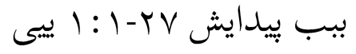
image

Однако, если я вставлю его в LibreOffice Writer, я получу следующее:
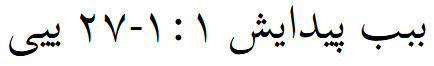
image
(то, что вы надеялись получить)

В этом случае, я думаю, Word на самом деле более правильный. Числа являются LTR, а двоеточие и дефис являются «Нейтральными» в их двунаправленности (см. Bidirectional text - Wikipedia). Это означает, что они не навязывают направление тексту, а берут его из окружающего контекста. И поскольку они находятся в контексте LTR-символов (чисел), они должны сохранять направление LTR, и вся эта строка чисел и знаков препинания должна быть представлена на строке в направлении LTR, как это делает PTXprint.

Так что с этой точки зрения то, что производит PTXprint, теоретически верно (с точки зрения алгоритма двунаправленного текста). Но на самом деле это не то, что вам нужно. Мы читаем наш текст RTL, и мы хотим, чтобы разные фрагменты (разделенные знаками препинания) появлялись один за другим с RTL, как показано в выводе LO Writer выше. (Я на самом деле не знаю, почему вывод LO Writer такой. Не похоже, что он следует алгоритму Unicode bidi…)

Но я могу получить такое поведение в Word, добавив специальные знаки, называемые знаками «Справа налево». Это Unicode-код U+200F (см. Right-to-left mark - Wikipedia). Вы можете вставлять эти знаки после знака препинания, чтобы принудительно задать направление текста RTL для этого знака препинания. Чтобы сделать это в Word, поставьте курсор после двоеточия (я рекомендую использовать стрелки, чтобы найти это место), введите «200F» и нажмите Alt+X (удерживайте клавишу Alt и нажмите клавишу X). Ваша глава один теперь должна прыгнуть справа от вашей строки чисел и знаков препинания. Сделайте то же самое после дефиса, и ваша строка будет выглядеть так же, как вывод LO Writer выше.

Но теперь трудная часть — это вставить эти RTL-знаки в текст для PTXprint. Я не тестировал это, но я думаю, что вы можете использовать Changes.txt (на вкладке Advanced), чтобы создать правила, которые будут вставлять RTL-знаки в правильных местах. Попробуйте эти правила (не тестировались):
'(\d):(\d)' > '\1:\u200f\2'
'(\d)-(\d)' > '\1-\u200f\2'

Но есть еще одна интересная проблема. Я замечаю, что вы используете восточноарабские индийские цифры, которые начинаются с U+06F0. (См. https://www.unicode.org/charts/PDF/U0600.pdf.) Я в основном использовал обычные арабские индийские цифры, которые начинаются с U+0660. Я думаю, что обозначение цифры \d должно работать и для этих цифр, но если нет, вам может понадобиться использовать что-то вроде этого: [\u06F1-\u06F9] вместо \d.

В любом случае, это дает вам что-то, что можно попробовать. И нам всем будет интересно узнать, если вы сделаете прогресс!

Джефф

Переведено машиной с языка English
от (1,4тыс. очков)

И я должен отметить, что такая манипуляция — это не то, что должен делать обычный пользователь PTXprint. Если это действительно глобальная проблема для RTL-текстов, то нам нужно найти способ, чтобы PTXprint исправил это «под капотом», чтобы пользователю не приходилось прибегать к крайним мерам, чтобы получить желаемый вывод.

Переведено машиной с языка English
0 голосов

Ну, чтобы цель была ясна, вот изображение опубликованного перевода на фарси с индикатором параллельного отрывка. Первый — это ссылка на Матфея 6:25-33, и визуальный порядок: 33-25:6 Матфея

Вы абсолютно правы в том, что цифры записываются слева направо (LTR), но когда у вас есть разделители и тому подобное, последовательность цифр работает как одно слово. Затем все слова выстраиваются в порядке справа налево (RTL).

Microsoft Word загадочен. Если я ввожу ссылку на стих, она отображается правильно (на самом деле, независимо от того, установлен ли абзац в режиме RTL или LTR). Если я копирую и вставляю из этого окна браузера, она отображается неправильно (снова, независимо от того, в режиме RTL или LTR абзац). WYSIAYG, полагаю.

Вот несколько вещей, которые я могу сделать, чтобы воспроизвести неверный результат (в Word или других GUI):

  • Разместить маркер СЛЕВА-НАПРАВО (U+200E) в начале ссылки.
  • Если я удаляю название книги, часть «глава/стих» выстраивается неправильно.

Это подсказывает мне, что часть «глава/стих» выстраивается в режиме LTR.

Вот несколько дополнительных тестов. Ссылки на стихи отображаются неправильно, когда я помещаю их в текст стиха. Я не могу точно это объяснить, если только XeLaTeX вообще не получает указания, что это контекст RTL.

\id PHM
\h سسسس
\c 1
\cl
\s1 سسسس
\p \v 1 پیدایش ۱:۱-۲۸
\s1 سسسس
\p \v 2  ۱:۱-۲۸

Переходим к XeLaTeX…

Если я использую fontspec и bidi, результат получается неправильным, независимо от того, в контексте LTR или RTL:

\documentclass{book}
\usepackage{fontspec,bidi}
\setmainfont[Script=Arabic]{Times New Roman}
\begin{document}
\setRTL
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\setLTR
۱:۱-۲۷

پیدایش ۱:۱-۲۷
\end{document}

Напротив, если я использую xepersian, я не могу заставить его отображаться неправильно. Часть «глава/стих» выстраивается правильно во всех четырех этих случаях:

\documentclass{book}
\usepackage{xepersian}
\usepackage[fontsize=16pt]{fontsize}
\settextfont{Times New Roman}
\begin{document}
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\beginL
۱:۱-۲۷
\endL

\beginL
پیدایش ۱:۱-۲۷
\endL
\end{document}

Я остановлюсь здесь. Мне кажется, что xepersian исправил недостаток в fontspec и bidi, но я не знаю, в чем именно он состоит.

Переведено машиной с языка English
от (131 очков)
0 голосов

Как я это понимаю, вывод, который вы видите от PTXprint, следует алгоритму Unicode bidi, хотя он и не дает вам того, что вы хотите. Алгоритм bidi говорит, что двоеточие и дефис — это нейтральные символы, и они будут следовать потоку окружающих символов. Когда они находятся в строке символов LTR (как цифры), они продолжают идти в LTR, давая вам тот результат, который вы видите. Пакет xepersian, по-видимому, изменяет характеристики bidi этих знаков препинания, давая вам то, что вы хотите. Интересно, что в Word, если вы поставите пробел после двоеточия и дефиса, ссылка развернется так, как вы хотите (но с лишним пробелом). Это на самом деле довольно странно, потому что пробелы также перечислены как Нейтральные в алгоритме bidi (см. ссылку выше). Я полагаю, что многие проекты с RTL-скриптами использовали этот метод в Paratext, чтобы ссылки развернулись «правильным» образом. Но добавление маркера RTL делает то же самое без добавления пробела.

Может быть, вы можете попробовать поместить эти правила в файл Changes.txt, чтобы посмотреть, что это даст?

Обратите внимание, что в вашем модуле вы вводите ссылки в обычных (арабских!) цифрах. Есть ли у вас в вашем проекте Paratext ссылки, которые уже введены с использованием арабских (хинди!) цифр? Если да, как они отображаются в Paratext? Я полагаю, что Paratext автоматически вставляет маркер RTL U+200F в таких ссылках в проекте RTL, пытаясь заставить их отображаться правильно. Я предполагаю, что PTXprint мог бы сделать то же самое. (Однако обратите внимание, что Paratext, похоже, вставляет маркер RTL перед двоеточием, что, по-моему, тоже является допустимым вариантом.)

Переведено машиной с языка English
от (1,4тыс. очков)
0 голосов

Да, если я помещаю эти команды в файл изменений, стихи действительно выводятся правильно. Спасибо за это исправление.

Если вы просто посмотрите на часть «глава/стих» (۱:۱-۲۷), она работает согласно алгоритму bidi. Но по этому алгоритму можно ожидать, что наличие названия книги (составленного из символов RTL) переключит ее в режим RTL (پیدایش ۱:۱-۲۷). (В этом текстовом редакторе и в окне предпросмотра, когда я это пишу, именно это и происходит.) Поэтому я предполагаю, что часть «глава/стих» находится в собственном \hbox или чем-то подобном и по какой-то причине не понимает, что она находится в документе RTL.

(Я не хочу уходить слишком далеко в сторону, но могут быть и другие проблемы, если документ не установлен глобально в RTL. Я замечаю, например, что маркер сноски появляется на неправильной стороне слов. Они появляются справа от слова, а не слева. Я не знаю наверняка, но это похоже на проблему LTR/RTL.)

Я не пробовал с арабско-индийскими цифрами. Однако я никогда не сталкивался с ситуацией, когда что-то работало с арабско-индийскими цифрами, но не с восточно-арабскими индийскими цифрами.

Переведено машиной с языка English
от (131 очков)

Ну, хорошо, что у вас есть временное решение. Я постараюсь обсудить это с @mjpenny, чтобы увидеть, нужно ли что-то делать в PTXprint.

Если вы снова посмотрите на алгоритм bidi (Bidirectional text - Wikipedia), обратите внимание, что цифры находятся в разделе «Слабые». Я предполагал, что они являются «Сильными» символами и определяют направление промежуточных «Нейтральных» символов. Но теперь я понимаю, что вы говорите: введение названия книги (в «Сильных» символах RTL) перевешивает «Слабые» цифры и определяет направление «Нейтральных» символов.

Переведено машиной с языка English
0 голосов

Здравствуйте,

Я не уверен, добавляю ли я какую-либо информацию в этот тред, которая еще не известна. Я участвовал в наборе текста для множества проектов RTL. Я просто хочу добавить то, что я знаю о том, как Paratext взаимодействует с текстами и ссылками RTL.

При редактировании проекта RTL в Paratext, Paratext идентифицирует строки, которые соответствуют формату ссылки на Писание или диапазона цифр, – т.е. паттерны вроде #:#, #.#, #:#-#, #:#,# и т.д. По мере того как они идентифицируются в открытой главе, которая редактируется, Paratext вставляет U+200F перед знаками препинания, заставляя их появляться слева от предшествующего числа (переопределяя направление LTR, инициированное числом/числами).

Таким образом, вместо этого:

image

вы видите это:

image

Если вы вводите ссылки в Paratext в логическом порядке, вы увидите, как происходит это визуальное обновление по мере завершения ввода.

Таким образом, в проектах, которые редактировались в Paratext, эти символы 200F могут уже присутствовать. Возможно, вам стоит учесть это в любых выражениях changes.txt, которые вы используете. Я полагаю, что Paratext выполняет эту вставку 200F только для глав, которые были открыты в редакторе (т.е. он не проходит через весь проект и не делает этого).

Причина, по которой это было сделано в Paratext, заключается в том, чтобы любой издатель или инструмент публикации downstream мог просто отобразить текст напрямую – особенно важно для некоторых цифровых приложений, где путь публикации не обязательно позволяет вмешательства, такие как changes.txt

Делюсь тем, что я понимаю, на случай, если это поможет.

Джефф

Переведено машиной с языка English
от [Expert]
(290 очков)

Похожие вопросы

0 голосов
1 ответ 56 просмотров
В проекте Paratext с поддержкой RTL я не нашёл ни одной комбинации настроек ссылок на Писание, текста стихов и ... должен же быть способ, чтобы Paratext делал это правильно?
Denny Emser 115 задал вопрос 2 дней назад
0 голосов
6 ответов 629 просмотров
Здравствуйте, все, Хотел бы попросить вашей помощи в создании справочной Библии. У нас есть текст Библии со ссылками. По ... нужны какие-то скрипты. Может ли кто-нибудь помочь?
Takashi Shimamura 102 задал вопрос янв 8, 2023
0 голосов
4 ответов 293 просмотров
Я использую PTXprint 1.9. В USFM-файле, с которым я работаю, есть сноски, но маркер \fr не включен. Похоже, что ... ссылок \fr из сносок в области примечаний. Я что-то упустил?
da4396 126 задал вопрос июл 22, 2021
0 голосов
1 ответ 59 просмотров
Когда я использую следующую ссылку в модуле Библии: \ref PSA 25:4-5,8-9,10-14 она не включает \q1, который стоит перед ... , чтобы включить \q1 перед \v 4. Мне кажется, это ошибка.
jeffh 1,4тыс. задал вопрос май 7, 2025
+1 голос
1 ответ 180 просмотров
Не уверен, является ли это ошибкой, но поскольку я только что потратил время на решение проблемы, которую, как мне ... уже нахожусь в нескольких главах и стихах от начала книги.
anon297911 424 задал вопрос фев 10, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Make every effort to keep the unity of the Spirit through the bond of peace.
Ephesians 4:3
3,049 вопросов
6,007 ответов
5,672 комментариев
2,029 пользователей





