0 votes
655 vues

Lors de l'impression d'un module pour une langue basée sur l'écriture arabe, j'ai remarqué que les références de versets sont imprimées incorrectement. Voici l'entrée de mon fichier SFM de module :

\s God creates the world
\r ($(GEN 1:1-27))
\ref GEN 1:1-27

Voici la sortie obtenue avec PTXprint 2.3.45 :

Capture d'écran 2023-10-03 090955

(Littéralement : « 1:1-27 Genèse » — la partie chapitre/verset est imprimée comme dans une langue LTR.)

Mais de droite à gauche, il devrait être : nom du livre, espace, numéro du chapitre, deux-points, verset initial, tiret, verset final

Maintenant que je cherche, je vois la même erreur dans les en-têtes des passages parallèles.

Traduit automatiquement depuis English
PTXprint par (131 points) | 655 vues

9 Réponses

0 votes

Il y a pas mal de possibilités quant à l'endroit où les choses se gâtent ici :

  1. Le document est-il réellement configuré en RTL, ou le \s est-il réellement ce que le module indique ? Nous avons la possibilité de faire ce que j'appelle un « diglot de série » (changer tous les paramètres de langue pour les parties pertinentes de la publication), mais ce n'est pas automatique.
  2. La référence ($(GEN...)) pourrait générer une sortie intermédiaire incorrecte. Pour tester : Pourriez-vous jeter un œil à l'onglet final USFM et voir si cela semble correct ou incorrect ?
  3. Il est possible que certains octets de basculement de direction Unicode soient fournis, ce qui embrouille quelque chose. Pour tester : Pourriez-vous taper (sans copier-coller) une plage de nombres dans un \r supplémentaire et voir si cela fonctionne ?
  4. Je suppose qu'il est possible que, pour une raison quelconque, \r oublie que le document est en RTL. Pour tester : pourriez-vous taper une plage dans une autre ligne où la mise en forme est correcte ?
Traduit automatiquement depuis English
par (1,1k points)
0 votes

Merci d'avoir traité cela si rapidement.

  1. C'est un document entièrement RTL. Je ne me souviens pas si j'ai dû l'indiquer à PTXprint ou s'il l'a obtenu de Paratext.

  2. Pouvez-vous me dire comment faire cela ? Je ne vois pas cet onglet dans PTXprint.

  3. et 4. Lorsque je tape la référence du verset dans \s ou \r, elle sort incorrectement de la même manière. Mais cela semble être en mode RTL par ailleurs. Les autres mots sortent dans le bon ordre RTL.

\s ببب پیدایش ۱:۱-۲۷ ییی
\r ($(GEN 1:1-27))
\r پیدایش ۱:۱-۲۷
\r قیرست سکند
\ref GEN 1:1-27

Capture d'écran 2023-10-03 113302

Traduit automatiquement depuis English
par (131 points)
0 votes
Traduit automatiquement depuis English
par (3,2k points)

Ah, le voilà.

Oui, c'est configuré en droite-à-gauche, et avec reliure de livre RTL.

Traduit automatiquement depuis English
0 votes

Donc euh… au moins c'est cohérent !
Très étrange !

Traduit automatiquement depuis English
par (1,1k points)
0 votes

Le texte RTL est bizarre. Les nombres sont en réalité affichés au format LTR. Donc, si vous supprimez les deux-points et le tiret, l'affichage correct de cette chaîne de nombres serait :
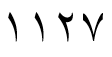
image c'est-à-dire « 1127 », lu de gauche à droite

Si je colle le texte de votre \s ci-dessus dans Word, j'obtiens le résultat suivant (exactement ce que vous voyez dans PTXprint) :
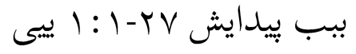
image

Cependant, si je le colle dans LibreOffice Writer, j'obtiens le résultat suivant :
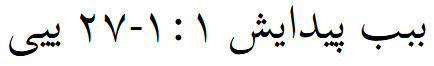
image
(ce que vous espériez obtenir)

Dans ce cas, je pense que Word est en réalité plus correct. Les nombres sont LTR, et les deux-points et le tiret sont « neutres » en termes de bidirectionnalité (voir Bidirectional text - Wikipedia). Cela signifie qu'ils n'imposent pas de direction au texte, mais la prennent du contexte environnant. Et comme ils sont dans le contexte de caractères LTR (les nombres), ils devraient conserver la direction LTR, et cette chaîne entière de nombres et de ponctuation devrait être présentée sur la ligne dans une direction LTR, comme PTXprint le fait.

Donc, de ce point de vue, ce que PTXprint produit est théoriquement correct (selon l'algorithme de texte bidirectionnel). Mais ce n'est pas en réalité ce que vous voulez. Nous lisons notre texte en RTL, et nous voulons que les différents blocs (séparés par la ponctuation) apparaissent l'un après l'autre en RTL, comme indiqué dans la sortie de LO Writer ci-dessus. (Je ne sais pas en fait pourquoi la sortie de LO Writer est comme ça. Cela ne semble pas suivre l'algorithme bidi Unicode…)

Mais je peux obtenir ce comportement dans Word en ajoutant des marques spéciales appelées marques droite-à-gauche. Ce sont des points de code Unicode U+200F (voir Right-to-left mark - Wikipedia). Vous pouvez insérer ces marques après une ponctuation pour forcer une direction de texte RTL pour cette ponctuation. Pour le faire dans Word, placez le curseur d'insertion après les deux-points (je recommande d'utiliser les touches fléchées pour trouver cet endroit), tapez « 200F » et tapez Alt+X (maintenez la touche Alt enfoncée et appuyez sur la touche X). Votre chapitre un devrait maintenant sauter à droite de votre chaîne de nombres et de ponctuation. Faites de même après le tiret, et votre chaîne ressemblera à la sortie de LO Writer ci-dessus.

Mais maintenant, la partie délicate est d'insérer ces marques RTL dans le texte pour PTXprint. Je n'ai pas testé cela, mais je pense que vous pourriez être en mesure d'utiliser Changes.txt (sur l'onglet Avancé) pour créer des règles qui inséreront les marques RTL aux endroits appropriés. Essayez ces règles (non testées) :
'(\d):(\d)' > '\1:\u200f\2'
'(\d)-(\d)' > '\1-\u200f\2'

Mais il y a un autre problème intéressant. Je remarque que vous utilisez les chiffres arabes-indic de l'Est, qui commencent à U+06F0. (Voir https://www.unicode.org/charts/PDF/U0600.pdf.) J'ai principalement utilisé les chiffres arabes-indic simples, qui commencent à U+0660. Je pense que la désignation de chiffre \d devrait fonctionner pour ces chiffres également, mais si ce n'est pas le cas, vous pourriez avoir besoin d'utiliser quelque chose comme ceci : [\u06F1-\u06F9] à la place de \d.

De toute façon, cela vous donne quelque chose à essayer. Et nous serons tous intéressés de savoir si vous faites des progrès !

Jeff

Traduit automatiquement depuis English
par (1,4k points)

Et je devrais souligner que ce type de manipulation n'est pas quelque chose que l'utilisateur moyen de PTXprint devrait avoir à faire. Si c'est effectivement un problème global pour les textes RTL, alors nous devrions trouver un moyen pour PTXprint de corriger cela « en interne », afin que l'utilisateur n'ait pas besoin de recourir à des mesures extrêmes pour obtenir la sortie souhaitée.

Traduit automatiquement depuis English
0 votes

Bon, pour que l'objectif soit clair, voici une image d'une traduction en farsi publiée avec un indicateur de passage parallèle. Le premier est une référence à Matthieu 6:25-33, et l'ordre visuel est : 33-25:6 Matthieu

Vous avez absolument raison que les chiffres sont écrits de gauche à droite (LTR), mais quand vous avez des délimiteurs et de tels, c'est comme si une séquence de chiffres était un seul mot. Ensuite, tous les mots sont disposés dans l'ordre de droite à gauche (RTL).

Microsoft Word est déroutant. Si je tape la référence du verset, elle s'affiche correctement (en fait, que j'aie défini le paragraphe en RTL ou en LTR). Si je copie et colle depuis cette fenêtre de navigateur, elle s'affiche incorrectement (encore une fois, que le paragraphe soit en RTL ou en LTR). Ce que vous voyez est ce que vous obtenez (WYSIAYG), je suppose.

Voici quelques choses que je peux faire pour reproduire le mauvais résultat (dans Word ou d'autres interfaces graphiques) :

  • Placer un marqueur DE GAUCHE À DROITE (U+200E) au début de la référence.
  • Si je supprime le nom du livre, la partie chapitre/verset est disposée incorrectement.

Cela me suggère que la partie chapitre/verset est disposée en mode LTR.

Voici quelques tests supplémentaires. Les références de versets s'affichent incorrectement quand je les mets dans le texte du verset. Je ne peux pas tout à fait l'expliquer, à moins que XeLaTeX ne soit pas du tout informé qu'il s'agit d'un contexte RTL.

\id PHM
\h سسسس
\c 1
\cl
\s1 سسسس
\p \v 1 پیدایش ۱:۱-۲۸
\s1 سسسس
\p \v 2  ۱:۱-۲۸

Passons à XeLaTeX…

Si j'utilise fontspec et bidi, le résultat est incorrect que le contexte soit LTR ou RTL :

\documentclass{book}
\usepackage{fontspec,bidi}
\setmainfont[Script=Arabic]{Times New Roman}
\begin{document}
\setRTL
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\setLTR
۱:۱-۲۷

پیدایش ۱:۱-۲۷
\end{document}

Inversement, si j'utilise xepersian, je ne parviens pas à obtenir un résultat incorrect. La partie chapitre/verset est disposée correctement dans les quatre cas suivants :

\documentclass{book}
\usepackage{xepersian}
\usepackage[fontsize=16pt]{fontsize}
\settextfont{Times New Roman}
\begin{document}
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\beginL
۱:۱-۲۷
\endL

\beginL
پیدایش ۱:۱-۲۷
\endL
\end{document}

Je m'arrête ici. Il me semble que xepersian a corrigé une lacune de fontspec et bidi, mais je ne sais pas laquelle.

Traduit automatiquement depuis English
par (131 points)
0 votes

La façon dont je le comprends, c'est que la sortie que vous voyez de PTXprint suit l'algorithme bidi Unicode, bien qu'elle ne vous donne pas ce que vous voulez. L'algorithme bidi indique que les deux-points et le tiret sont des caractères neutres, et qu'ils suivent le flux des caractères environnants. Lorsqu'ils sont dans une chaîne de caractères LTR (comme les chiffres), ils continuent en LTR, ce qui vous donne le résultat que vous voyez. Le paquet xepersian change apparemment les caractéristiques bidi de ces signes de ponctuation, ce qui vous donne ce que vous voulez. Intéressant, dans Word, si vous mettez un espace après les deux-points et le tiret, la référence se retourne de la façon dont vous voulez qu'elle s'affiche (mais avec un espace supplémentaire). C'est en fait assez étrange, car les espaces sont également répertoriés comme Neutres dans l'algorithme bidi (voir le lien ci-dessus). Je crois que de nombreux projets de scripts RTL ont utilisé cette technique dans Paratext pour faire tourner les références dans le « bon » sens. Mais l'ajout du marqueur RTL fait la même chose sans ajouter l'espace.

Peut-être pourriez-vous essayer de mettre ces règles dans le fichier Changes.txt, pour voir ce que cela donne ?

Notez que dans votre module, vous saisissez vos références en chiffres normaux (arabes !). Avez-vous des références dans votre projet Paratext qui sont déjà saisies avec des chiffres de style arabe (indiens !) ? Si oui, comment s'affichent-elles dans Paratext ? Je crois que Paratext insère automatiquement un marqueur RTL U+200F dans ce type de références dans un projet RTL, pour essayer de les faire apparaître correctement. Je suppose que PTXprint pourrait faire la même chose. (Notez, cependant, que Paratext semble insérer le marqueur RTL avant les deux-points, ce que je pense être également une option valide.)

Traduit automatiquement depuis English
par (1,4k points)
0 votes

Oui, si je mets ces commandes dans le fichier de modifications, les versets s'affichent correctement. Merci pour cette correction.

Si vous regardez juste la partie chapitre/verset (۱:۱-۲۷), elle fonctionne selon l'algorithme bidi. Mais selon cet algorithme, on s'attendrait à ce que la présence d'un nom de livre (composé de caractères RTL) le bascule en mode RTL (پیدایش ۱:۱-۲۷). (Dans cet éditeur de texte et dans la fenêtre d'aperçu pendant que je tape, c'est exactement ce qui se passe.) Donc, j'imagine que la partie chapitre/verset est dans son propre \hbox ou quelque chose comme ça, et ne se rend pas compte qu'elle est dans un document RTL pour une raison quelconque.

(Je ne veux pas trop m'éloigner du sujet, mais il pourrait y avoir d'autres problèmes latents si le document n'est pas globalement défini en RTL. Je remarque, par exemple, que le marqueur de note de bas de page apparaît du mauvais côté des mots. Ils apparaissent à droite du mot au lieu de la gauche. Je ne sais pas avec certitude, mais cela semble être un problème LTR/RTL.)

Je n'ai pas essayé avec les chiffres arabes-indiens. Je n'ai jamais rencontré de situation, cependant, où quelque chose fonctionnait avec les chiffres arabes-indiens mais pas avec les chiffres arabes-orientaux.

Traduit automatiquement depuis English
par (131 points)

Bon, c'est bien que vous ayez une solution de contournement pour le moment. J'essaierai d'en discuter avec @mjpenny pour voir si quelque chose doit être fait dans PTXprint.

Si vous consultez à nouveau l'algorithme bidi (Texte bidirectionnel - Wikipédia), notez que les chiffres sont trouvés dans la section « Faible ». J'avais supposé qu'ils étaient des caractères « Forts », et qu'ils définiraient la direction des caractères « Neutres » intercalés. Mais je comprends maintenant ce que vous dites, à savoir que l'insertion du nom du livre (en caractères RTL « Forts ») prime sur les chiffres « Faibles » pour définir la direction des caractères « Neutres ».

Traduit automatiquement depuis English
0 votes

Bonjour,

Je ne suis pas sûr d'ajouter des informations à ce fil qui ne sont pas déjà connues. J'ai participé à la mise en page de nombreux projets RTL. Je veux simplement ajouter ce que je sais sur la façon dont Paratext interagit avec les textes et les références RTL.

Lors de l'édition d'un projet RTL dans Paratext, Paratext identifie les chaînes qui suivent le format d'une référence biblique ou d'une plage de chiffres – c'est-à-dire des motifs comme #:#, #.#, #:#-#, #:#,#, etc. Lorsque ces motifs sont identifiés dans le chapitre ouvert en cours d'édition, Paratext insère un U+200F avant les caractères de ponctuation, ce qui les fait apparaître à gauche du nombre précédent (en annulant la direction LTR autrement initiée par le(s) nombre(s)).

Ainsi, au lieu de ceci :

image

vous voyez ceci :

image

Si vous saisissez des références dans Paratext, dans l'ordre logique, vous verrez cette mise à jour visuelle se produire à mesure que vous terminez leur saisie.

Ainsi, dans les projets qui ont été édités dans Paratext, ces caractères 200F peuvent déjà être présents. Vous voudrez peut-être en tenir compte dans les expressions changes.txt que vous utilisez. Je crois qu'il est vrai que Paratext n'effectue cette insertion de 200F que pour les chapitres qui ont été ouverts dans l'éditeur (c'est-à-dire qu'il ne parcourt pas tout le projet pour le faire).

Une raison pour laquelle cela a été fait dans Paratext est de permettre à tout éditeur en aval ou à tout outil de publication de simplement afficher le texte directement – ce qui est particulièrement important pour certains chemins d'applications numériques où le chemin de publication n'autorise pas nécessairement des interventions comme changes.txt

Je partage ce que je comprends au cas où cela aiderait.

Jeff

Traduit automatiquement depuis English
par [Expert]
(290 points)

Questions connexes

0 votes
1 réponse 56 vues
Dans un projet Paratext RTL, je n'ai trouvé aucune combinaison de Paramètres de référence biblique, de texte des ... moyen pour que Paratext fasse les choses correctement, non ?
Denny Emser 115 posée il y a 2 jours
0 votes
6 réponses 629 vues
Bonjour à tous, J'aimerais solliciter votre aide pour créer une Bible de référence. Nous disposons d'un texte biblique ... scripts sont nécessaires. Quelqu'un peut-il m'aider ?
Takashi Shimamura 102 posée janv. 8, 2023
0 votes
4 réponses 293 vues
J'utilise PTXprint 1.9. Le fichier USFM sur lequel je travaille contient des notes de bas de page, mais n'inclut pas ... la zone des notes. Ai-je manqué ce paramètre quelque part ?
da4396 126 posée juil. 22, 2021
0 votes
1 réponse 59 vues
Lorsque j'utilise la référence suivante dans un module de la Bible : \ref PSA 25:4-5,8-9,10-14 il n'inclut pas le \q1 ... inclure le \q1 avant \v 4. Cela me semble être un bug.
jeffh 1,4k posée mai 7, 2025
+1 vote
1 réponse 180 vues
Je ne suis pas sûr que ce soit un bug ou non, mais comme je viens de passer un certain temps à essayer de ... si j'étais déjà à plusieurs chapitres et versets dans le livre.
anon297911 424 posée févr. 10, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
If anyone destroys God’s temple, God will destroy that person; for God’s temple is sacred, and you together are that temple.
1 Corinthians 3:17
3,049 questions
6,007 réponses
5,672 commentaires
2,029 utilisateurs





