0 votos
655 visualizações

Ao imprimir um módulo para um idioma baseado em escrita árabe, notei que as referências de versículos são impressas incorretamente. Aqui está a entrada do meu arquivo SFM do módulo:

\s God creates the world
\r ($(GEN 1:1-27))
\ref GEN 1:1-27

Aqui está a saída que obtive do PTXprint 2.3.45:

Screenshot 2023-10-03 090955

(Literalmente: “1:1-27 Gênesis” — a parte do capítulo/versículo é impressa da mesma forma que em um idioma LTR.)

Mas, da direita para a esquerda, deveria ser: nome do livro, espaço, número do capítulo, dois-pontos, versículo inicial, hífen, versículo final

Agora que estou procurando, vejo o mesmo erro nos títulos de passagens paralelas.

Tradução automática de English
PTXprint por (131 pontos) | 655 visualizações

9 Respostas

0 votos

Há várias possibilidades de onde as coisas estão dando errado aqui:

  1. O documento está realmente configurado como RTL, ou o \s é realmente o que o módulo diz? Temos a possibilidade de fazer o que chamo de “diglota de série” (alternando todas as configurações de idioma para as partes relevantes da publicação), mas não é automático.
  2. A referência ($(GEN...)) pode estar gerando uma saída intermediária incorreta. Para testar: Você poderia dar uma olhada na aba final USFM e ver se parece certo ou errado lá?
  3. Pode haver alguns bytes de comutação de direção unicode sendo fornecidos que estão confundindo algo. Para testar: Você poderia digitar (não copiar e colar) um intervalo de números em um \r extra e ver se funciona?
  4. Suponho que seja possível que, por algum motivo, o \r esteja esquecendo que o documento é RTL. Para testar: você poderia digitar um intervalo em alguma outra linha onde as coisas estão formatando corretamente?
Tradução automática de English
por (1,1k pontos)
0 votos

Obrigado por chegar a isso tão rapidamente.

  1. É um documento completamente RTL. Não consigo me lembrar se tive que dizer ao PTXprint isso, ou se ele obteve isso do Paratext.

  2. Você poderia me dizer como fazer isso? Não vejo essa aba no PTXprint.

  3. e 4. Quando digito a referência do versículo em \s ou \r, sai errado da mesma forma. Mas, de outra forma, parece estar em modo RTL. As outras palavras estão saindo na ordem RTL correta.

\s ببب پیدایش ۱:۱-۲۷ ییی
\r ($(GEN 1:1-27))
\r پیدایش ۱:۱-۲۷
\r قیرست سکند
\ref GEN 1:1-27

Screenshot 2023-10-03 113302

Tradução automática de English
por (131 pontos)
0 votos
Tradução automática de English
por (3,2k pontos)

Ah, está aí.

Sim, está configurado para Da Direita para a Esquerda, e com encadernação de livro RTL.

Tradução automática de English
0 votos

Então, hm... pelo menos é consistente!
Muito estranho!

Tradução automática de English
por (1,1k pontos)
0 votos

Texto RTL é estranho. Os números são, na verdade, exibidos em formato LTR. Então, se você se livrar do dois-pontos e do hífen, a exibição correta dessa sequência de números seria:
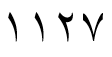
imagem ou seja, “1127”, lendo da esquerda para a direita

Se eu colar o texto do seu \s acima no Word, obtenho o seguinte (exatamente o que você está vendo no PTXprint):
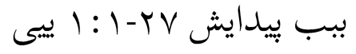
imagem

No entanto, se eu colar no LibreOffice Writer, obtenho o seguinte:
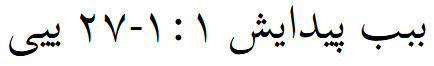
imagem
(o que você esperava obter)

Neste caso, acho que o Word está, na verdade, mais correto. Os números são LTR, e o dois-pontos e o hífen são “Neutros” em sua bidirecionalidade (veja Texto bidirecional - Wikipedia). Isso significa que eles não forçam uma direção no texto, mas a tomam do contexto circundante. E, como estão no contexto de caracteres LTR (os números), eles devem manter a direção LTR, e toda essa sequência de números e pontuação deve ser apresentada na linha em uma direção LTR, como o PTXprint está fazendo.

Então, dessa perspectiva, o que o PTXprint está produzindo é teoricamente correto (do algoritmo de texto bidirecional). Mas isso não é, na verdade, o que você quer. Estamos lendo nosso texto RTL e queremos que os diferentes blocos (separados por pontuação) apareçam um após o outro de RTL, como mostrado na saída do LO Writer acima. (Na verdade, não sei por que a saída do LO Writer é assim. Não parece que está seguindo o algoritmo bidi do Unicode...)

Mas eu posso obter esse comportamento no Word adicionando marcas especiais chamadas marcas da direita para a esquerda. Elas são o ponto de código Unicode U+200F (veja Marca da direita para a esquerda - Wikipedia). Você pode inserir essas marcas após uma pontuação para forçar uma direção de texto RTL para aquela pontuação. Para fazer isso no Word, coloque o cursor de inserção após os dois-pontos (recomendo usar as teclas de seta para encontrar aquele ponto), digite “200F” e digite Alt+X (segure a tecla Alt e toque na tecla X). Seu capítulo um deve agora pular para a direita da sua sequência de números e pontuação. Faça o mesmo após o hífen, e sua sequência parecerá a mesma que a saída do LO Writer acima.

Mas agora a parte difícil é fazer com que essas marcas RTL sejam inseridas no texto para o PTXprint. Eu não testei isso, mas acho que você pode usar o Changes.txt (na aba Avançado) para criar regras que inserirão as marcas RTL nos lugares apropriados. Tente estas regras (não testadas):
'(\d):(\d)' > '\1:\u200f\2'
'(\d)-(\d)' > '\1-\u200f\2'

Mas há mais um problema interessante. Notei que você está usando os dígitos árabes-indianos orientais, que começam em U+06F0. (Veja https://www.unicode.org/charts/PDF/U0600.pdf.) Eu usei principalmente os dígitos árabes-indianos comuns, que começam em U+0660. Acho que a designação de dígito \d deve funcionar para esses dígitos também, mas, se não funcionar, você pode precisar usar algo como [\u06F1-\u06F9] no lugar de \d.

De qualquer forma, isso lhe dá algo para tentar. E todos nós estaremos interessados em saber se você fizer progresso!

Jeff

Tradução automática de English
por (1,4k pontos)

E eu deveria apontar que esse tipo de manipulação não é algo que o usuário médio do PTXprint deveria ter que fazer. Se isso for, de fato, um problema global para textos RTL, então devemos encontrar uma maneira de o PTXprint corrigir isso “por baixo dos panos”, para que o usuário não precise tomar medidas extremas para obter a saída desejada.

Tradução automática de English
0 votos

Bem, para que o objetivo fique claro, aqui está uma imagem de uma tradução publicada em farsi com um indicador de passagem paralela. O primeiro é uma referência a Mateus 6:25-33, e a ordem visual é: 33-25:6 Mateus

Você está absolutamente certo de que os dígitos são escritos da esquerda para a direita (LTR), mas quando você tem delimitadores e coisas assim, é como se uma sequência de dígitos fosse uma única palavra. Então, todas as palavras são dispostas na ordem da direita para a esquerda (RTL).

O Microsoft Word é enigmático. Se eu digitar a referência do versículo, ela sai corretamente (na verdade, independentemente de eu ter definido o parágrafo como RTL ou LTR). Se eu copiar e colar desta janela do navegador, ela sai incorretamente (novamente, independentemente de o parágrafo ser RTL ou LTR). WYSIAYG, imagino.

Aqui estão algumas coisas que posso fazer para replicar o resultado incorreto (no Word ou em outras interfaces gráficas):

  • Colocar um marcador de ESQUERDA PARA DIREITA (U+200E) no início da referência.
  • Se eu remover o nome do livro, a parte do capítulo/versículo é disposta incorretamente.

Isso sugere a mim que a parte do capítulo/versículo está sendo disposta no modo LTR.

Aqui estão alguns testes adicionais. As referências de versículos saem incorretamente quando as coloco no texto do versículo. Não consigo explicar isso completamente, a menos que o XeLaTeX não esteja sendo informado de forma alguma de que se trata de um contexto RTL.

\id PHM
\h سسسس
\c 1
\cl
\s1 سسسس
\p \v 1 پیدایش ۱:۱-۲۸
\s1 سسسس
\p \v 2  ۱:۱-۲۸

Passando para o XeLaTeX…

Se eu usar fontspec e bidi, sai incorretamente, independentemente de o contexto ser LTR ou RTL:

\documentclass{book}
\usepackage{fontspec,bidi}
\setmainfont[Script=Arabic]{Times New Roman}
\begin{document}
\setRTL
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\setLTR
۱:۱-۲۷

پیدایش ۱:۱-۲۷
\end{document}

Por outro lado, se eu usar xepersian, não consigo fazer com que saia incorretamente. A parte do capítulo/versículo é disposta corretamente em todos os quatro casos:

\documentclass{book}
\usepackage{xepersian}
\usepackage[fontsize=16pt]{fontsize}
\settextfont{Times New Roman}
\begin{document}
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\beginL
۱:۱-۲۷
\endL

\beginL
پیدایش ۱:۱-۲۷
\endL
\end{document}

Vou parar por aqui. Parece-me que o xepersian corrigiu uma deficiência no fontspec e no bidi, mas não sei qual é essa deficiência.

Tradução automática de English
por (131 pontos)
0 votos

A forma como eu interpreto é que a saída que você está vendo do PTXprint segue o algoritmo bidi do Unicode, embora não lhe dê o que você deseja. O algoritmo bidi diz que o dois-pontos e o hífen são caracteres neutros e seguirão o fluxo dos caracteres circundantes. Quando em uma sequência de caracteres LTR (como números), eles continuarão em LTR, dando-lhe o resultado que você vê. O pacote xepersian aparentemente altera as características bidi desses sinais de pontuação, dando-lhe o que você deseja. Curiosamente, no Word, se você colocar um espaço após o dois-pontos e o hífen, ele inverterá a referência para a forma como você deseja que ela apareça (mas com espaço extra). Isso é na verdade bastante estranho, porque os espaços também estão listados como Neutros no algoritmo bidi (veja o link acima). Acredito que vários projetos de scripts RTL tenham usado essa técnica no Paratext para fazer as referências se voltarem para o lado “certo”. Mas a adição do marcador RTL faz a mesma coisa sem adicionar o espaço.

Você poderia tentar colocar essas regras no arquivo Changes.txt para ver o que isso faz?

Note que, no seu módulo, você está inserindo suas referências em numerais normais (árabes!). Você tem alguma referência no seu projeto do Paratext que já tenha sido inserida com numerais de estilo árabe (híndis!)? Se sim, como elas aparecem no Paratext? Acredito que o Paratext insere automaticamente um marcador RTL U+200F nesses tipos de referências em um projeto RTL, para tentar fazê-las aparecer corretamente. Suponho que o PTXprint poderia fazer algo semelhante. (Note, no entanto, que o Paratext parece inserir o marcador RTL antes do dois-pontos, o que acho que também é uma opção válida.)

Tradução automática de English
por (1,4k pontos)
0 votos

Sim, se eu colocar esses comandos no arquivo de alterações, os versículos saem corretamente. Obrigado por essa correção.

Se você olhar apenas para a parte do capítulo/versículo (۱:۱-۲۷), ela está operando de acordo com o algoritmo bidi. Mas, por esse algoritmo, você esperaria que a presença de um nome de livro (composto por caracteres RTL) a mudasse para o modo RTL (پیدایش ۱:۱-۲۷). (Neste editor de texto e na janela de pré-visualização enquanto digito isso, é exatamente o que acontece.) Então, estou imaginando que a parte do capítulo/versículo está em seu próprio \hbox ou algo assim, e não percebe que está em um documento RTL por alguma razão.

(Não quero levar isso para muito longe, mas pode haver outros problemas latentes se o documento não estiver definido globalmente para RTL. Notei, por exemplo, que o marcador de nota de rodapé aparece no lado errado das palavras. Eles aparecem no lado direito da palavra em vez do lado esquerdo. Não tenho certeza, mas parece ser uma questão de LTR/RTL.)

Não tentei com dígitos árabe-índicos. No entanto, nunca me deparei com uma situação em que algo funcionasse com dígitos árabe-índicos, mas não com dígitos árabe-orientais.

Tradução automática de English
por (131 pontos)

Bem, é bom que você tenha uma solução temporária. Vou tentar discutir isso com @mjpenny para ver se algo deve ser feito no PTXprint.

Se você verificar novamente o algoritmo bidi (Bidirectional text - Wikipedia), note que os dígitos são encontrados na seção “Fraca”. Eu assumi que eles eram caracteres “Fortes” e definiriam a direção dos caracteres “Neutros” intermediários. Mas agora entendo o que você está dizendo, que colocar o nome do livro (em caracteres RTL “Fortes”) anula os dígitos “Fracos” para definir a direção dos caracteres “Neutros”.

Tradução automática de English
0 votos

Olá,

Não tenho certeza se estou adicionando alguma informação a este tópico que não seja já conhecida. Tenho participado da composição tipográfica de vários projetos RTL. Quero simplesmente acrescentar o que sei sobre como o Paratext interage com textos e referências RTL.

Ao editar um projeto RTL no Paratext, o Paratext identifica strings que seguem o formato de uma referência bíblica ou de um intervalo de dígitos – ou seja, padrões como #:#, #.#, #:#-#, #:#,#, etc. À medida que esses são identificados no capítulo aberto em edição, o Paratext insere um U+200F antes dos caracteres de pontuação, fazendo com que eles apareçam no lado esquerdo do número anterior (sobrescrevendo a direção LTR iniciada pelos números).

Então, em vez de:

image

você vê isso:

image

Se você inserir referências no Paratext, em ordem lógica, verá essa atualização visual ocorrer à medida que você completa a inserção delas.

Portanto, em projetos que foram editados no Paratext, esses caracteres 200F podem já estar presentes. Você pode querer levar isso em conta em qualquer expressão changes.txt que usar. Acredito que seja verdade que o Paratext só realiza essa inserção de 200F para capítulos que tenham sido abertos no editor (ou seja, ele não percorre todo o projeto para fazer isso).

Uma razão pela qual isso foi feito no Paratext é para que qualquer editor ou ferramenta de publicação a jusante pudesse simplesmente renderizar o texto diretamente – especialmente importante para alguns caminhos de aplicativos digitais onde o caminho de publicação não permite necessariamente intervenções como changes.txt

Compartilhando o que entendo, caso ajude de alguma forma aqui.

Jeff

Tradução automática de English
por [Expert]
(290 pontos)

Perguntas relacionadas

0 votos
1 resposta 56 visualizações
Em um projeto Paratext RTL, não encontrei nenhuma combinação de Configurações de Referências Bíblicas, texto dos versículos e ... de o Paratext fazer isso corretamente, não é?
Denny Emser 115 perguntada 2 dias atrás
0 votos
6 respostas 629 visualizações
Olá a todos, Gostaria de pedir ajuda para criar uma Bíblia de Referência. Temos um texto bíblico com referências ... Acho que alguns scripts são necessários. Alguém pode ajudar?
Takashi Shimamura 102 perguntada Jan 8, 2023
0 votos
4 respostas 293 visualizações
Estou usando o PTXprint 1.9. O arquivo USFM com o qual estou trabalhando tem notas de rodapé, mas não inclui o ... na área de notas. Eu perdi essa configuração em algum lugar?
da4396 126 perguntada Jul 22, 2021
0 votos
1 resposta 59 visualizações
Quando uso a seguinte referência em um módulo da Bíblia: \ref PSA 25:4-5,8-9,10-14 ele não inclui o \q1 que aparece antes ... o \q1 antes de \v 4. Isso parece um bug para mim.
jeffh 1,4k perguntada Mai 7, 2025
+1 voto
1 resposta 180 visualizações
Não tenho certeza se isso é um bug ou não, mas como acabei de passar um tempo tentando resolver um problema que ... que eu já estivesse em vários capítulos e versículos do livro.
anon297911 424 perguntada Fev 10, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
And I tell you that you are Peter, and on this rock I will build my church, and the gates of Hades will not overcome it.
Matthew 16:18
3,049 perguntas
6,007 respostas
5,672 comentários
2,029 usuários





