0 votos
655 vistas

Al imprimir un módulo para un idioma basado en escritura árabe, noté que las referencias de versículos se imprimen incorrectamente. Esta es la entrada de mi archivo SFM del módulo:

\s God creates the world
\r ($(GEN 1:1-27))
\ref GEN 1:1-27

Este es el resultado que obtuve con PTXprint 2.3.45:

Captura de pantalla 2023-10-03 090955

(Literalmente: “1:1-27 Génesis” — la parte del capítulo/versículo se imprime igual que en un idioma LTR).

Pero de derecha a izquierda, debería ser: nombre del libro, espacio, número de capítulo, dos puntos, versículo inicial, guion, versículo final

Ahora que lo busco, veo el mismo error en los encabezados de pasajes paralelos.

Traducción automática desde English
PTXprint por (131 puntos) | 655 vistas

9 Respuestas

0 votos

There are quite a few possibilities of where things are going wrong here:

  1. Is the document actually set RTL, or is the \s actually what the module says? We do have the possibility to do what I call a “series diglot” (switching all the language settings for relevant parts of the publication) but it’s not automatic.
  2. The ($(GEN...)) reference might be generating incorrect intermediate output. To Test: Could you have a look at the final USFM tab and see if it looks right or wrong there?
  3. There might be some unicode direction switching bytes getting supplied which are confusing something. To Test: Could you type (not copy and paste) a number range into an extra \r and see if that works?
  4. I suppose it’s possible that for some reason \r might be forgetting that the document is RTL. To Test: could you type a range into some other line where things are formatting correctly?
por (1,1k puntos)
0 votos

Gracias por ocuparse de esto tan rápidamente.

  1. Es un documento completamente RTL. No recuerdo si tuve que indicarle a PTXprint eso, o si lo obtuvo de Paratext.

  2. ¿Podría decirme cómo hacer esto? No veo esa pestaña en PTXprint.

  3. y 4. Cuando escribo la referencia del versículo en \s o \r, sale mal de la misma manera. Pero de lo contrario parece estar en modo RTL. Las otras palabras salen en el orden RTL correcto.

\s ببب پیدایش ۱:۱-۲۷ ییی
\r ($(GEN 1:1-27))
\r پیدایش ۱:۱-۲۷
\r قیرست سکند
\ref GEN 1:1-27

Captura de pantalla 2023-10-03 113302

Traducción automática desde English
por (131 puntos)
0 votos
Traducción automática desde English
por (3,2k puntos)

Ah, ahí está.

Sí, está configurado de derecha a izquierda, y con encuadernación de libro RTL.

Traducción automática desde English
0 votos

Entonces, bueno… ¡al menos es consistente!
¡Muy extraño!

Traducción automática desde English
por (1,1k puntos)
0 votos

El texto RTL es extraño. Los números se muestran en realidad en formato LTR. Así que si se elimina los dos puntos y el guion, la visualización correcta de esa cadena de números sería:
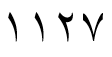
imagen es decir, “1127”, leyendo de izquierda a derecha

Si pego el texto de su \s anterior en Word, obtengo lo siguiente (exactamente lo que está viendo en PTXprint):
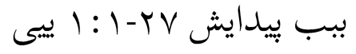
imagen

Sin embargo, si lo pego en LibreOffice Writer, obtengo lo siguiente:
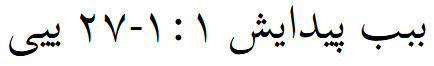
imagen
(lo que esperaba obtener)

En este caso, creo que Word es en realidad más correcto. Los números son LTR, y los dos puntos y el guion son “Neutros” en su bidireccionalidad (ver Texto bidireccional - Wikipedia). Eso significa que no fuerzan una dirección en el texto, sino que la toman del contexto circundante. Y como están en el contexto de caracteres LTR (los números), deberían mantener la dirección LTR, y toda esa cadena de números y puntuación debería presentarse en la línea en una dirección LTR, como lo está haciendo PTXprint.

Así que, desde esa perspectiva, lo que PTXprint está produciendo es teóricamente correcto (desde el algoritmo de texto bidireccional). Pero eso no es realmente lo que usted quiere. Estamos leyendo nuestro texto en RTL, y queremos que los diferentes fragmentos (separados por puntuación) aparezcan uno tras otro desde RTL, como se muestra en la salida de LO Writer anterior. (En realidad, no sé por qué la salida de LO Writer es así. No parece que esté siguiendo el algoritmo bidi de Unicode…)

Pero puedo obtener ese comportamiento en Word agregando marcas especiales llamadas marcas de derecha a izquierda. Son puntos de código Unicode U+200F (ver Marca de derecha a izquierda - Wikipedia). Puede insertar estas marcas después de una puntuación para forzar una dirección de texto RTL para esa puntuación. Para hacerlo en Word, coloque el cursor de inserción después de los dos puntos (recomiendo usar las teclas de flecha para encontrar ese lugar), escriba “200F” y presione Alt+X (mantenga presionada la tecla Alt y presione la tecla X). Su capítulo uno debería saltar ahora a la derecha de su cadena de números y puntuación. Haga lo mismo después del guion, y su cadena se verá igual que la salida de LO Writer anterior.

Pero ahora la parte difícil es hacer que esas marcas RTL se inserten en el texto para PTXprint. No he probado esto, pero creo que podría ser posible usar Changes.txt (en la pestaña Avanzada) para crear reglas que inserten las marcas RTL en los lugares adecuados. Pruebe estas reglas (no probadas):
'(\d):(\d)' > '\1:\u200f\2'
'(\d)-(\d)' > '\1-\u200f\2'

Pero hay un problema más interesante. Me doy cuenta de que está usando los dígitos árabes orientales, que comienzan en U+06F0. (Ver https://www.unicode.org/charts/PDF/U0600.pdf.) He usado principalmente los dígitos árabes indicos planos, que comienzan en U+0660. Creo que la designación de dígito \d debería funcionar para esos dígitos también, pero si no lo hace, es posible que necesite usar algo como esto: [\u06F1-\u06F9] en lugar de \d.

De todos modos, eso le da algo para probar. ¡Y todos estaremos interesados en saber si avanza!

Jeff

Traducción automática desde English
por (1,4k puntos)

Y debo señalar que este tipo de manipulación no es algo que el usuario promedio de PTXprint deba hacer. Si este es realmente un problema global para los textos RTL, entonces deberíamos encontrar una manera de que PTXprint lo solucione “internamente”, para que el usuario no tenga que tomar medidas extremas para obtener la salida deseada.

Traducción automática desde English
0 votos

Bueno, para que el objetivo quede claro, aquí hay una imagen de una traducción al farsi publicada con un indicador de pasaje paralelo. El primero es una referencia a Mateo 6:25-33, y el orden visual es: 33-25:6 Mateo

Tienes toda la razón en que los dígitos se escriben de izquierda a derecha (LTR), pero cuando tienes delimitadores y cosas así, es como si una secuencia de dígitos fuera una sola palabra. Entonces, todas las palabras se disponen en orden de derecha a izquierda (RTL).

Microsoft Word es desconcertante. Si escribo la referencia del versículo, sale correctamente (de hecho, sin importar si he configurado el párrafo como RTL o LTR). Si copio y pego desde esta ventana del navegador, sale incorrectamente (nuevamente, sin importar si el párrafo es RTL o LTR). Lo que ves es lo que obtienes (WYSIAYG), supongo.

Estas son algunas cosas que puedo hacer para replicar el resultado incorrecto (en Word u otras interfaces gráficas):

  • Colocar un marcador de IZQUIERDA A DERECHA (U+200E) al principio de la referencia.
  • Si elimino el nombre del libro, la parte de capítulo/versículo se dispone incorrectamente.

Esto me sugiere que la parte de capítulo/versículo se está disponiendo en modo LTR.

Aquí hay algunas pruebas más. Las referencias de versículos salen mal cuando las pongo en el texto del versículo. No puedo explicarlo del todo, a menos que a XeLaTeX no se le esté indicando en absoluto que se trata de un contexto RTL.

\id PHM
\h سسسس
\c 1
\cl
\s1 سسسس
\p \v 1 پیدایش ۱:۱-۲۸
\s1 سسسس
\p \v 2  ۱:۱-۲۸

Pasemos a XeLaTeX…

Si uso fontspec y bidi, sale mal sin importar si el contexto es LTR o RTL:

\documentclass{book}
\usepackage{fontspec,bidi}
\setmainfont[Script=Arabic]{Times New Roman}
\begin{document}
\setRTL
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\setLTR
۱:۱-۲۷

پیدایش ۱:۱-۲۷
\end{document}

Por el contrario, si uso xepersian, no consigo que salga mal. La parte de capítulo/versículo se dispone correctamente en los cuatro casos siguientes:

\documentclass{book}
\usepackage{xepersian}
\usepackage[fontsize=16pt]{fontsize}
\settextfont{Times New Roman}
\begin{document}
۱:۱-۲۷

پیدایش ۱:۱-۲۷

\beginL
۱:۱-۲۷
\endL

\beginL
پیدایش ۱:۱-۲۷
\endL
\end{document}

Me detengo aquí. A mí me parece que xepersian ha corregido una deficiencia de fontspec y bidi, pero no sé cuál es.

Traducción automática desde English
por (131 puntos)
0 votos

La forma en que lo leo es que la salida que estás viendo de PTXprint sigue el algoritmo bidi de Unicode, aunque no te da lo que quieres. El algoritmo bidi dice que los dos puntos y el guion son caracteres neutros, y seguirán el flujo de los caracteres circundantes. Cuando están en una cadena de caracteres LTR (como los números), continuarán en LTR, dándote el resultado que ves. El paquete xepersian aparentemente cambia las características bidi de esos signos de puntuación, dándote lo que quieres. Curiosamente, en Word, si pones un espacio después de los dos puntos y el guion, la referencia se invertirá de la forma en que quieres que se vea (pero con un espacio extra). Esto es en realidad bastante extraño, porque los espacios también están listados como Neutros en el algoritmo bidi (ver enlace anterior). Creo que muchos proyectos de escritura RTL han utilizado esta técnica en Paratext para que las referencias se orienten de la forma “correcta”. Pero la adición de la marca RTL hace lo mismo sin añadir el espacio.

¿Podrías intentar poner esas reglas en el archivo Changes.txt para ver qué hace?

Ten en cuenta que en tu módulo estás introduciendo tus referencias con números normales (¡árabes!). ¿Tienes alguna referencia en tu proyecto de Paratext que ya esté introducida con números de estilo árabe (¡hindi!)? Si es así, ¿cómo se muestran en Paratext? Creo que Paratext inserta automáticamente una marca RTL U+200F en ese tipo de referencias en un proyecto RTL, para intentar que aparezcan correctamente. Asumo que PTXprint podría hacer algo similar. (Ten en cuenta, sin embargo, que Paratext parece insertar la marca RTL antes de los dos puntos, lo que creo que también es una opción válida.)

Traducción automática desde English
por (1,4k puntos)
0 votos

Sí, si pongo esos comandos en el archivo de cambios, los versículos salen correctamente. Gracias por esa solución.

Si solo miras la parte de capítulo/versículo (۱:۱-۲۷), está operando según el algoritmo bidi. Pero según ese algoritmo, esperarías que la presencia de un nombre de libro (compuesto por caracteres RTL) lo cambiara al modo RTL (پیدایش ۱:۱-۲۷). (En este editor de texto y en la ventana de vista previa mientras escribo esto, es exactamente lo que sucede.) Así que me imagino que la parte de capítulo/versículo está en su propio \hbox o algo así, y no se da cuenta de que está en un documento RTL por alguna razón.

(No quiero desviarme demasiado, pero podría haber otros problemas latentes si el documento no está configurado globalmente como RTL. Por ejemplo, noto que el marcador de nota al pie aparece en el lado equivocado de las palabras. Aparecen en el lado derecho de la palabra en lugar del lado izquierdo. No lo sé con certeza, pero parece un problema de LTR/RTL.)

No he probado con dígitos árabes-indios. Sin embargo, nunca me he encontrado con una situación en la que algo funcionara con dígitos árabes-indios pero no con dígitos árabes-orientales.

Traducción automática desde English
por (131 puntos)

Bueno, es bueno que tengas una solución temporal. Intentaré discutir esto con @mjpenny para ver si se debe hacer algo en PTXprint.

Si vuelves a consultar el algoritmo bidi (Texto bidireccional - Wikipedia), ten en cuenta que los dígitos se encuentran en la sección “Débil”. Yo había asumido que eran caracteres “Fuertes” y definirían la dirección de los caracteres “Neutros” intermedios. Pero ahora entiendo lo que dices, que poner el nombre del libro (en caracteres RTL “Fuertes”) anula los dígitos “Débiles” para definir la dirección de los caracteres “Neutros”.

Traducción automática desde English
0 votos

Hola,

No estoy seguro de si estoy añadiendo alguna información a este hilo que no se sepa ya. He participado en la composición tipográfica de numerosos proyectos RTL. Quiero simplemente añadir lo que sé sobre cómo Paratext interactúa con los textos y referencias RTL.

Cuando se edita un proyecto RTL en Paratext, Paratext identifica las cadenas que siguen el formato de una referencia bíblica o un rango de dígitos, es decir, patrones como #:#, #.#, #:#-#, #:#,#, etc. A medida que se identifican en el capítulo abierto que se está editando, Paratext inserta un U+200F antes de los caracteres de puntuación, haciendo que aparezcan en el lado izquierdo del número anterior (anulando la dirección LTR iniciada de lo contrario por el/los número/s).

Así, en lugar de esto:

imagen

ves esto:

imagen

Si introduces referencias en Paratext, en orden lógico, verás que esta actualización visual ocurre a medida que terminas de introducirlas.

Por lo tanto, en los proyectos que se editaron en Paratext, es posible que estos caracteres 200F ya estén ahí. Quizás quieras tenerlo en cuenta en las expresiones de changes.txt que uses. Creo que es cierto que Paratext solo realiza esta inserción de 200F para los capítulos que se han abierto en el editor (es decir, no recorre todo el proyecto para hacer esto).

Una razón por la que se hizo esto en Paratext es para que cualquier editor o herramienta de publicación aguas abajo pudiera renderizar el texto directamente, especialmente importante para algunas rutas de aplicaciones digitales donde la ruta de publicación no permite necesariamente intervenciones como changes.txt

Comparto lo que entiendo por si ayuda en algo aquí.

Jeff

Traducción automática desde English
por [Expert]
(290 puntos)

Preguntas relacionadas

0 votos
1 respuesta 56 vistas
En un proyecto de Paratext RTL, no he encontrado ninguna combinación de Configuración de referencias bíblicas, texto de versículos ... forma de que Paratext lo haga bien, verdad?
Denny Emser 115 preguntada hace 2 días
0 votos
6 respuestas 629 vistas
Hola a todos, Me gustaría pedir ayuda para crear una Biblia de Referencia. Tenemos un texto bíblico con referencias ... que se necesitan algunos scripts. Alguien puede ayudar?
Takashi Shimamura 102 preguntada ene 8, 2023
0 votos
4 respuestas 293 vistas
Estoy usando PTXprint 1.9. El archivo USFM con el que estoy trabajando tiene notas al pie, pero no incluye el ... notas. He pasado por alto esa configuración en algún lugar?
da4396 126 preguntada jul 22, 2021
0 votos
1 respuesta 59 vistas
Cuando uso la siguiente referencia en un módulo de la Biblia: \ref PSA 25:4-5,8-9,10-14 no incluye el \q1 que aparece ... q1 antes de \v 4. Esto parece un error (bug) para mí.
jeffh 1,4k preguntada may 7, 2025
+1 voto
1 respuesta 180 vistas
No estoy seguro de si se trata de un error o no, pero como acabo de pasar un buen rato intentando resolver ... , aunque ya estuviera en varios capítulos y versículos del libro.
anon297911 424 preguntada feb 10, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
All the believers were one in heart and mind. No one claimed that any of their possessions was their own, but they shared everything they had.
Acts 4:32
3,049 preguntas
6,007 respuestas
5,672 comentarios
2,029 usuarios





