Лексические категории используются для группировки слов. Группировка может быть очень широкой, например глаголы, или очень конкретной, например местоимения с женскими суффиксами. Категории используются в системе сопоставления шаблонов в правилах переноса.
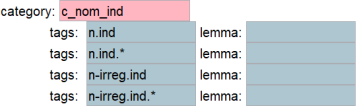
Приведенное выше изображение является примером лексической категории для неопределенных именных слов. Точка указывает, где начинается новый тег. Звездочка — это индикатор подстановочного символа. Это означает, что на этом месте может находиться что угодно. Звездочка в конце элемента соответствует одному или нескольким конечным тегам. Например, если у меня есть лексическая единица book1.1 n f sg, она может быть точно сопоставлена с элементом tags, содержащим n.f.sg. Более общо, мы могли бы сопоставить book с элементом tags, содержащим n.f.*. Это будет относиться ко всем словам, которые имеют грамматическую категорию n, за которой следует тег f, а затем что-либо еще, то есть женские существительные. Категория выше определяет множество всех неопределенных существительных — слов, которые имеют грамматическую категорию n или n-irreg, за которой следует ind и, при необходимости, что-то еще. Обратите внимание, что n.ind и n.ind.* необходимы оба, потому что n.ind.* потребовало бы наличие аффикса после ind и не сопоставилось бы с неопределенным существительным, таким как car1.1 n ind, у которого нет дополнительных суффиксов.
Вы можете использовать элемент lemma для идентификации конкретного значения слова. На изображении ниже показано, как категория dem_this может быть определена как слово, имеющее грамматическую категорию dem и лемму this1.1 (в FLEx: headword this1, sense 1). Это может быть полезно, когда вы хотите сопоставлять фразы, содержащие слово ‘this’.
Lexical categories are used to group words together. The grouping can be very broad such as verbs or very specific such as pronouns with feminine suffixes. The categories are used in the pattern matching system of transfer rules.
The above image is an example of a lexical category for indefinite nominals. The period indicates where a new tag begins. The asterisk is a wildcard indicator. It means that anything can fill that position. An asterisk at the end of the item matches one or more final tags. For example, if I have the lexical unit book1.1 n f sg, it could be precisely matched by a tags element containing n.f.sg. More generally we could match book with the tags element containing n.f.*. This would refer to all words that have the grammatical category n followed by the tag f followed by anything else, i.e. feminine nouns. The category above defines the set of all indefinite nouns — words that have the grammatical category n or n-irreg followed by ind and optionally something else afterward. Note that n.ind and n.ind.* are both necessary because n.ind.* would require some affix after ind and not match an indefinite noun like car1.1 n ind that has no additional suffixes.
You can use the lemma element to identify a specific word-sense. The image below shows how the category dem_this can be defined as a word that has a grammatical category of dem and lemma this1.1 (in FLEx: headword this1 , sense 1). This might be useful when you want to match phrases containing the word ‘this’.








