Les catégories lexicales sont utilisées pour regrouper des mots. Le regroupement peut être très large, comme les verbes, ou très spécifique, comme les pronoms avec des suffixes féminins. Les catégories sont utilisées dans le système d'analyse de motifs des règles de transfert.
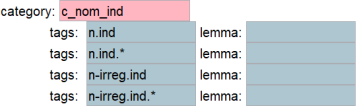
L'image ci-dessus est un exemple de catégorie lexicale pour les nominaux indéfinis. Le point indique où commence une nouvelle étiquette. L'astérisque est un indicateur de joker. Cela signifie que n'importe quoi peut occuper cette position. Un astérisque à la fin de l'élément correspond à une ou plusieurs étiquettes finales. Par exemple, si j'ai l'unité lexicale book1.1 n f sg, elle pourrait être correspondre exactement à un élément d'étiquettes contenant n.f.sg. Plus généralement, nous pourrions correspondre à book avec l'élément d'étiquettes contenant n.f.*. Cela ferait référence à tous les mots qui ont la catégorie grammaticale n suivie de l'étiquette f puis de n'importe quoi d'autre, c'est-à-dire les noms féminins. La catégorie ci-dessus définit l'ensemble de tous les noms indéfinis — des mots qui ont la catégorie grammaticale n ou n-irreg suivie de ind et éventuellement d'autre chose ensuite. Notez que n.ind et n.ind.* sont tous deux nécessaires, car n.ind.* exigerait un affixe après ind et ne correspondrait pas à un nom indéfini comme car1.1 n ind qui n'a pas de suffixes supplémentaires.
Vous pouvez utiliser l'élément lemme pour identifier un sens de mot spécifique. L'image ci-dessous montre comment la catégorie dem_this peut être définie comme un mot ayant une catégorie grammaticale dem et le lemme this1.1 (dans FLEx : mot de tête this1, sens 1). Cela peut être utile lorsque vous souhaitez correspondre à des phrases contenant le mot « this ».
Lexical categories are used to group words together. The grouping can be very broad such as verbs or very specific such as pronouns with feminine suffixes. The categories are used in the pattern matching system of transfer rules.
The above image is an example of a lexical category for indefinite nominals. The period indicates where a new tag begins. The asterisk is a wildcard indicator. It means that anything can fill that position. An asterisk at the end of the item matches one or more final tags. For example, if I have the lexical unit book1.1 n f sg, it could be precisely matched by a tags element containing n.f.sg. More generally we could match book with the tags element containing n.f.*. This would refer to all words that have the grammatical category n followed by the tag f followed by anything else, i.e. feminine nouns. The category above defines the set of all indefinite nouns — words that have the grammatical category n or n-irreg followed by ind and optionally something else afterward. Note that n.ind and n.ind.* are both necessary because n.ind.* would require some affix after ind and not match an indefinite noun like car1.1 n ind that has no additional suffixes.
You can use the lemma element to identify a specific word-sense. The image below shows how the category dem_this can be defined as a word that has a grammatical category of dem and lemma this1.1 (in FLEx: headword this1 , sense 1). This might be useful when you want to match phrases containing the word ‘this’.
Traduit automatiquement depuis English








