+2 голосов
2,0тыс. просмотров

Всем привет, я хотел бы обсудить неразрывные (no-break) пробелы (U+00A0) в эпоху цифровых изданий.

Я работаю в стране, где официально двуязычие между французским и английским. В англоязычных странах неразрывные и половинные пробелы редки. Вы можете найти неразрывный пробел между частями 1·Паралипоменон.

В отличие от этого, большинство наших переводчиков из франкоязычных регионов хотят следовать правилам французского набора. В франкоязычном мире пробелы обязательны перед/вокруг знаков препинания с 2 знаками (; ! : ? « »). Неразрывные пробелы часто используются в качестве разделителя тысяч в больших числах, например 1·000 (Настройки чисел - Разделитель тысяч сбрасывается - #3 от jeffh). Стандарты публикации варьируются, но идеальными кандидатами для этого случая являются обычный неразрывный пробел (U+00A0) и узкий неразрывный пробел (U202F). Это предотвращает перенос закрывающего знака препинания на следующую строку, особенно в многостолбичных макетах. Эти пробелы обеспечивают непрерывность текста на компьютерах всего мира. Стандартный пробел (U+0020), тонкий пробел (U+2009) и волосный пробел (U+022A) имеют разную ширину, но не обеспечивают необходимой защиты от «сирот».

Некоторые инструменты выбирают визуально отображать неразрывные пробелы в виде бледной точки или серого квадрата. Paratext автоматически заменяет неразрывный пробел (U+00A0) на огромную тильду (~, U+007E). В текущих версиях ввод 00A0 и нажатие ALT-X заменяет то, что должно быть неразрывным пробелом, на обычный (0020) пробел, что является прямой ошибкой. Эта гигантская тильда очень отвлекает наших переводчиков, и поэтому в большинстве случаев франкоязычным переводчикам указывали использовать либо обычные пробелы, либо вообще не использовать пробелы перед знаками препинания, с пониманием того, что наборщик стандартизирует пробелы в последнюю минуту в соответствии с их решениями перед печатью. Я полностью осознаю, что огромные тильды заменяются неразрывными пробелами в режиме предпросмотра и могут быть заменены через изменения Print Draft или ptxPrint. Креативный технарь мог бы настроить PTX print для вставки пробелов перед такими символами, но тогда они вообще не были бы видны в Paratext.

Из документации Paratext:

По этой причине Paratext больше не поддерживает использование неразрывных пробелов. Если вы хотите использовать неразрывные пробелы в вашем тексте, вы должны вводить тильду вместо неразрывного пробела. Их можно преобразовать в неразрывные пробелы при наборе. Тильды, введенные в текст, отображаются как неразрывные пробелы в виде Предпросмотра.

Если бы это было чем-то редким (как в английском), я бы не беспокоился, но это встречается почти в каждом абзаце франкоязычного текста. Моя озабоченность заключается в том, что 1) тильды отвлекают переводчиков, которые проводят свое время в стандартном виде, и тех, кто читает через плечо, и 2) что это ограничение не выдерживает испытания в эту эпоху цифровых публикаций и обмена.

Технически,~можно~обойтись~и~опубликовать~через~промежуточные~тильды. Реакция полевых сотрудников на тильды — игнорировать неразрывные пробелы до набора — больше не жизнеспособна, поскольку тексты готовятся не только для печати наборщиками. Отдельные книги публикуются локально, цифровые версии помещаются в DBL и становятся доступными, и создаются приложения Scripture Apps. Это означает, что наличие «финального» пробеления в версии Paratext становится все более важным, и Paratext по-прежнему не «по-настоящему» поддерживает это. (Я только что обнаружил сегодня, что узкий неразрывный пробел (U202F) не имеет визуального индикатора, но, к счастью, не превращается в тильду.) Непоследовательное отображение/обработка U+202F, который должен быть уже, обсуждается здесь (Удаление Unicode 202F ("узкий неразрывный пробел") в проекте)

LibreOffice использует серый квадрат, чтобы отличать неразрывные пробелы от обычных пробелов. Функция Show/Hide в Word использует открытый круг для неразрывных пробелов и центрированную точку для обычных пробелов.

Рассмотрят ли разработчики Paratext отказ от тильды в интерфейсе и использование чего-то более читаемого и менее отвлекающего? Потребуется ли для этого изменение USFM или только Paratext? Переводчики уже привыкли к серым метаданным в их тексте, таким как маркеры USFM. Бледная серая точка · в стандартном виде была бы полезна для различения специальных пробелов и обычных пробелов, верно? Использование серых квадратов вместо этого показало бы и неразрывность, и длину, что, я полагаю, и есть причина, по которой LibreOffice выбрал их. Это было бы большой победой для межкультурной совместимости, надеюсь, кто-то другой, работающий во франкоязычном мире, сможет высказаться. @jeffh @dhigby @anon023887 ?

Я понимаю из этого поста (Проблемы с неразрывными пробелами), что превращение в тильду было введено для борьбы с проблемой чередования в Internet Explorer. Даже сейчас два последовательных пробела в веб-странице требуют, чтобы хотя бы один был преобразован в NBSP. Да, визуально различить пробелы трудно, но команды все еще должны их стандартизировать.
~ Matthew_Lee
Консультант по языковым технологиям
SIL Камерун

Что делает ситуацию еще хуже, так это то, что справка Paratext рассматривает неразрывные пробелы как бич, который нужно искоренить (см. ниже).

Почему я вижу тильды вместо пробелов в моем тексте?
Неразрывные пробелы — это символы, которые выглядят как пробел, но которые не позв…
Неразрывные пробелы — это символы, которые выглядят как пробел, но которые не позволяют переносить строку в этом месте. При открытии текста с неразрывными пробелами, если вы обнаружите, что эти пробелы, похоже, были заменены символами тильды (~), это сделано намеренно. Paratext делает неразрывные пробелы видимыми, отображая их как тильды.
Что мне нужно знать об этом в минимальном объеме?
Ранние версии Paratext иногда и ошибочно вставляли неразрывные пробелы там, где требовался обычный пробел. Поэтому, если вы видите случайную тильду в месте текста, где вы уверены, что неразрывный пробел не требуется, вы можете просто заменить тильду на пробел.
Что, если я хотел бы решить проблему разом?
Если вы НЕ намеренно вставляли какие-либо неразрывные пробелы или тильды в свой текст и, следовательно, хотите удалить все неразрывные пробелы и тильды, следуйте инструкциям в Варианте 1. Если вы не абсолютно уверены, были ли тильды или неразрывные пробелы вставлены намеренно, проконсультируйтесь с вашим лицом поддержки CAP перед удалением всех них, иначе вам может потребоваться вручную ввести их заново.

             Option 1 (To get rid of all no-break spaces and tildes):
             
                Click the tab of your project to make it the active tab.
                From the Tools menu, point to Advanced and then select Replace No-Break Spaces With Normal Spaces.
                Read the warning message and click Yes if you are sure you wish to continue.

        If your project has been following the USFM manual and so has been manually inserting tildes either to represent no-break spaces or for some other function, follow the instructions in Option 2. Doing this sooner rather than later prevents Paratext from inserting any more occasional unwanted tildes.

             Option 2 (To get rid of no-break spaces, but keep all tildes):
             
                Click the tab of your project to make it the active tab.
                From the Tools menu, point to Advanced and then select Replace No-Break Spaces With Normal Spaces But Keep Tildes.
                Read the warning message and click Yes if you are sure you wish to continue.
        
         See also:
        
          Important information about no-break spaces and tildes
Переведено машиной с языка English
Paratext от (231 очков)
снова показан | 2,0тыс. просмотров

11 Ответов

+1 голос
Лучший ответ

Да, я согласен с Matthew_Lee в том, что это важный вопрос, особенно во франкоязычном мире. В моём анализе есть ряд моментов, которые я хотел бы упомянуть, но я постараюсь дать краткое резюме (TLDR) в конце этого поста.

Небольшой поиск в интернете показывает некоторые интересные вещи, которые не являются «отвлечением от темы»:
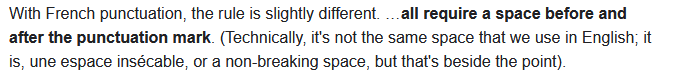
изображение

И некоторые забавные ошибки (где явно использовался обычный пробел, что в данном случае привело к разрыву строки):
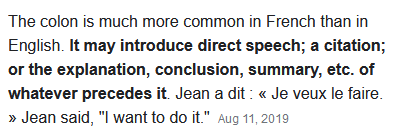
изображение

Именно этого мы хотим избежать — ситуаций, когда знаки препинания не связаны с соответствующим текстом. Поэтому, если мы собираемся использовать какой-либо символ пробела для отделения знаков препинания, мы ВСЕГДА должны использовать неразрывный пробел какого-либо типа.

Два основных варианта — это полный неразрывный пробел (NBSP, U+00A0) или узкий неразрывный пробел (NNBSP, U+202F), определения которых можно найти в стандарте Unicode по адресам https://unicode.org/charts/PDF/U0090.pdf и https://unicode.org/charts/PDF/U2000.pdf соответственно:
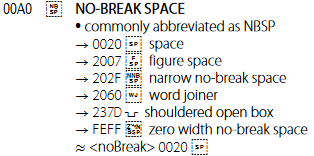
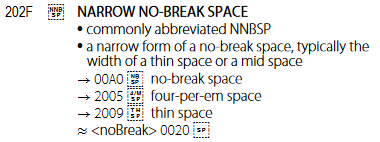
изображение
изображение

Как вы можете видеть, в определении NNBSP указано, что он обычно имеет ширину тонкого пробела, который определён в той же таблице как :
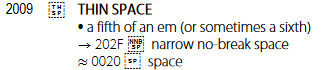
изображение

Таким образом, NNBSP обычно составляет одну пятую эм-квадрата (0.2em). Какова ширина обычного пробела или NBSP? Эти метрики зависят от шрифта, но приблизительный расчёт с использованием шрифта Charis SIL показывает, что символы пробела и NBSP имеют ширину около 0.34em. NNBSP составляет около 0.22em. Это значительная разница, и если вы используете NBSP (или, как временную меру, обычный пробел, который имеет недостаток в виде разрыва между строками) вокруг знаков препинания, верстальщики, которых я знаю, скажут, что этот пробел слишком велик. Использование NNBSP значительно помогает, и это можно довольно легко сделать в PTXprint с помощью изменений, подобных следующим строкам в файле PrintDraftChanges.txt:

' *:'  >    '\u202f:'     # Place non-breaking thin space before colon
'« *' >    '«\u202f'     # Place non-breaking thin space after opening guillemets
' *»' >    '\u202f»'     # Place non-breaking thin space before closing guillemets
'‹ *' >    '‹\u202f'     # Place non-breaking thin space after opening guillemets
' *›' >    '\u202f›'     # Place non-breaking thin space before closing guillemets

Это вставляет NNBSP перед или после (по необходимости) знаков препинания и также удаляет любые пробелы, которые там есть (если они есть). Это означает, что независимо от того, вставляет ли команда пробелы или нет, они будут нормализованы в символы NNBSP. Например, в этом проекте команда непоследовательна и использует (обычные) пробелы вокруг вопросительных знаков и двоеточий, но не вокруг кавычек (французских кавычек-«ёлочек»):
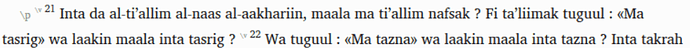
Обратите внимание, что вы можете увидеть, что это просто обычные пробелы, если правильно отрегулировать масштаб и/или размер панели, так как они позволяют разрыв между строками, как здесь:
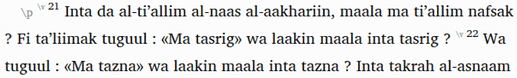
Но изменения, описанные выше, должны уметь корректно обрабатывать оба этих случая и вставлять NNBSP для верстки.

Аналогичным образом, вы хотели бы добавить правила изменений в ваши проекты SAB, чтобы убедиться, что ваши библейские приложения правильно обрабатывают пробелы. Ознакомьтесь с этим постом, чтобы увидеть примеры правил: https://community.scripture.software.sil.org/t/suggestions-for-changes-gallery/590/3.

Обратите внимание, что правила в этом посте не так элегантно обрабатывают наличие или отсутствие пробела, как правила выше, но вы можете отрегулировать их с помощью трюков, таких как " *", использованных выше.

И ещё один момент, прежде чем мы перейдём к Paratext… В недавних работах по верстке мы на самом деле использовали одну десятую эм-квадрата (0.1em) в качестве пробела вокруг знаков препинания, то есть меньше, чем NNBSP. Вот определение знаков препинания, которое мы использовали:

\catcode`\:=\active \def:{\unskip\kern0.1em\char`\:{}} % colon

Примечание: это было сделано в XeTeX, но то же самое можно сделать с PTXprint. Я полагаю, что вы хотели бы определить это в файле конфигурации ptxprint-mods.tex, доступном на вкладке инструментов Advanced. Это даёт довольно минимальный пробел вокруг знаков препинания, как видно в этом образце:
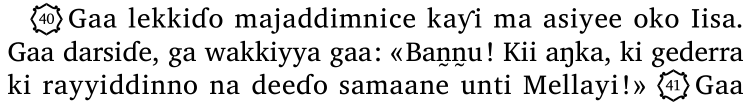
Но команды считают, что этого пробела достаточно, чтобы удовлетворить их ощущаемую потребность в пробелах вокруг знаков препинания, которая требуется во французском языке. (Конечно, французы могут не согласиться, но это не их язык!)

Вывод (TLDR): Что это значит для Paratext?

Если команда использует обычные пробелы в тексте для отделения своих знаков препинания, то иногда это будет отображаться неправильно на их экране в Paratext (т.е. знаки препинания не будут правильно прикреплены к тексту, как показано выше), что отвлекает, но не является концом света. В этом случае ответственность лежит на верстальщике или создателе приложения, чтобы правильно изменить эти обычные пробелы. К сожалению, если именно в таком виде текст будет помещён в DBL (что очень вероятно), то такие приложения, как YouVersion, будут иметь проблемы, потому что они, как известно, НЕ обрабатывают эти пробелы должным образом.

Учитывая эту тенденцию к всё более и более мелким неразрывным пробелам для отделения знаков препинания (сначала NNBSP в 0.2em, а затем ручная верстка в 0.1em с помощью PTXprint), которую я наблюдал в своих проектах по верстке, я почти всегда рекомендую командам НЕ ставить пробелы вокруг знаков препинания в Paratext, а просто доверять верстке или созданию приложения сделать правильные вещи вокруг этих знаков препинания. Это означает, что когда текст будет помещён в DBL, у YouVersion не будет «висящих» знаков препинания. (У них также не будет пробелов вокруг знаков препинания, но, по моему мнению, это меньшая проблема.)

Таким образом, с этим конкретным планом действий изменения в Paratext не требуются. Если бы вы хотели, как предложил Matthew_Lee, способ отображать символы NNBSP или NBSP, я думаю, что это была бы хорошая идея, но нашим клавиатурам также потребовался бы способ вводить эти символы (чего они не всегда могут делать), и Paratext должен был бы знать, что не нужно вмешиваться в эти символы. (И инвентари знаков препинания должны были бы показывать все комбинации с этими пробелами, чтобы убедиться, что они используются последовательно, например, всегда с NNBSP.)

Этот пост предлагает не столько решения, сколько предоставляет больше контекста и информации. Мне действительно не нравится то, как сейчас работает эта штука с тильдой / NBSP в Paratext, и я согласен, что это должно измениться. Кажется, Paratext должен предполагать, что он должен принимать каждый символ в тексте буквально, будь то тильда, NBSP или NNBSP. И было бы хорошо иметь способ видеть их (незаметно). Должны ли два или более пробела автоматически объединяться (в ответ на @anon942452)? Может быть, если они являются идентичными символами? Это всё ещё позволило бы автоматическую коррекцию пробелов в Paratext, но также предоставило бы некоторые варианты для обхода этого. И также нужно было бы придумать способ справиться со всеми устаревшими проектами, в которых используются тильды для неразрывных пробелов, возможно, просто конвертация, чтобы преобразовать их все в NBSP, как только это будет правильно обработано в Paratext.

В любом случае, ещё немного пищи для размышлений…

Переведено машиной с языка English
от (1,4тыс. очков)

Некоторые национальные языки Юго-Восточной Азии используют пробел между фразами, а не между словами. Некоторые меньшинственные языки, использующие эти системы письма, выбрали использование обычного пробела между каждым словом и более широкого пробела на границах фраз. Если в Paratext для этих широких пробелов на границах фраз используется EM SPACE (\u2003), то Инвентари символов и знаков препинания рассматривают EM SPACE как символ, образующий слово, а не как знак препинания, что делает невозможным проверку правильных последовательностей. Я сообщил об этом как о PTXS-31753.

Когда jeffh рекомендует переводчикам полностью исключить французские пробелы из Paratext, он помогает обеспечить однозначное обозначение структуры/значения в тексте Paratext ценой менее привлекательного представления. Я делаю то же самое, когда рекомендую использовать запятую вместо EM SPACE внутри Paratext. Но пользователи правы, возражая против обоих предложений; я тоже гораздо больше предпочитаю WYSIWYG в Microsoft Word командам с точками WordStar, которые я использовал на своём первом компьютере.

Я бы с удовольствием увидел, как Paratext добавляет опцию «Показать невидимые символы», которая, например, отображала бы символы пробела как серые квадраты. Эта опция «Показать невидимые символы» была бы чрезвычайно полезна для языков, которые вводят Zero Width Space (\u0200b) между каждым словом. В настоящее время Paratext рекомендует вводить слэш (/) между каждым словом. Этот слэш затем (ужасно) виден во всех представлениях, кроме Preview.

Я задумываюсь, могли бы франкоязычные регионы найти шрифт, который либо (1) делает ~ гораздо менее заметным, либо (2) автоматически регулирует пробел вокруг знаков препинания в зависимости от контекста.

Благословений,
LivingField

Переведено машиной с языка English

Иногда Paratext может навредить, удовлетворяя запросы на кастомизацию. Это особенно верно, когда кастомизация не поддерживается в другом программном обеспечении или когда она позволяет делать выбор, который противоречит направлению, в котором движется коммерческое программное обеспечение. Языковые сообщества затем делают выбор, который становится тупиком для их будущего развития за пределами Paratext. (Конечно, в других ситуациях это было очень полезно, проблемы просто сложны и требуют тщательного обдумывания.)

Но в этом разговоре мы говорим об адаптации к вариантам, которые в настоящее время доступны в коммерческом программном обеспечении, а также об инструменте, который уже широко доступен. Если представить это таким образом в запросе на функцию, я думаю, что мы могли бы продвинуться. Возможно, те, кто лучше всего в этом разбирается, могли бы провести отдельный разговор вне списка рассылки о лучшем способе представить запрос на функцию и о том, что на самом деле наиболее необходимо.

Благословений,

Переведено машиной с языка English
0 голосов

Спасибо, Matthew_Lee, за ваше полезное и информативное письмо. У меня нет никаких решений, которые я мог бы предложить, но я очень заинтересован в этой теме и узнал больше благодаря вашей тщательности. Я особенно борюсь с невидимыми символами RTL и LTR, которые влияют на наши сложные письменности. Если бы был способ сделать все невидимые символы слегка видимыми (или включать/выключать видимость с помощью клавиши ctrl, возможно), это могло бы помочь более легко решить некоторые сложные ситуации, в которых мы ourselves находимся. Этот подход также мог бы сделать обычный неразрывный пробел жизнеспособным для использования в Paratext, хотя я не имею понятия о других возможных препятствиях для его использования на стороне программирования.

Благословений,

Переведено машиной с языка English
от (1,3тыс. очков)
снова показан
+1 голос

Дорогой Matthew_Lee, спасибо, что подняли этот вопрос. Я работаю с языками первых наций Северной Америки, которые используют нелатиницу (Канадские слоговые письменности), и несколько основных орфографий, использующих эту письменность, используют различные ширины (три ширины) пробела для обозначения границ морфем и слов. Обычный пробел между словами 0020 значительно шире в предпочтительном шрифте слоговой письменности, который работает нормально в Paratext. Но узкий неразрывный пробел (U+202F) составляет 1/3 ширины обычного пробела между словами. Использование этого пробела критически важно и в нашем языке — его нужно использовать внутри слов как границу морфемы, а также (как это делается во французском) для отделения знаков препинания от конца предложений. Наконец, во многих ситуациях необходима третья ширина неразрывного пробела. На протяжении многих лет языковые сообщества, с которыми мы работали, использовали два узких неразрывных пробела (U+202F U+202F) последовательно, чтобы обеспечить неразрывный пробел между префиксами и основами слов, предотвращая «сироты» в конце строк и предоставляя визуальную подсказку о начале основы. Ширина этих составляет 2/3 стандартного пробела между словами.

К сожалению, начиная с Paratext 7, существует алгоритм paratext, который удаляет любые два идентичных символа пробела, идущих последовательно, и заменяет их одним. Нам пришлось придумать хитрое обходное решение, создав клавиатуру keyman, которая вставляет неразрывный пробел нулевой ширины (U+200D), чтобы предотвратить замену Paratext нашего намеренного двойного тонкого пробела (U+202F U+202F) на один.

При экспорте наших Писаний в DBL эта последовательность была неприемлема, поэтому нам сначала нужно запустить программу преобразования, которая заменяет все последовательности (U+202F U+200D U+202F) на «стандартный» неразрывный пробел (в Paratext, «тильда», который становится U+00A0).

В любом случае, все это для того, чтобы сказать, что я поддерживаю вашу тему о пересмотре тильды как неразрывного пробела, по причинам, которые вы указываете, и я хотел высказаться с точки зрения письменности, которая использует три различных ширины пробела.

С уважением, anon942452 J

Переведено машиной с языка English
от (106 очков)

Современные веб-технологии склонны сжимать повторяющиеся пробелы без предупреждения, но ОБЫЧНО позволяют чередовать несколько типов пробелов. По этой причине веб-дизайнеры давно злоупотребляют пробелами, чередуя обычный пробел и неразрывный пробел (nbsp) вместо установки отступов. @anon942452 нашел метод, который позволяет обходить автоматическую очистку мусора аналогичным образом.

Если я правильно понял, я согласен с @Shegnada в том, что предоставление пользователям возможности делать в Paratext то, что уже работает в корпоративных инструментах, несет низкий риск, но создание новых пользовательских рабочих процессов, которые будут работать только в Paratext, ставит сообщество перед проблемами грамотности и публикации в будущем. Я видел, как люди загоняют себя в угол, используя взломанные шрифты и старые макросы.

Я надеюсь, что Paratext научится поддерживать все виды пробелов, чтобы проект Paratext стал золотым стандартом.

Первая задача — принять эти пробелы и позволить им проходить через DBL и цифровую/печатную публикацию. Возможно, я оптимист, но мобильные приложения, inDesign и HTML не должны вызывать проблем, поскольку это символы Unicode в рекомендуемых шрифтах. TeX (PTXPrint) потребует небольшой предварительной обработки, но в TeX существуют инструменты для управления этим. Если нижестоящим инструментам, таким как YouVersion, нужно научиться использовать расширенные пробелы/разрывы, это обсуждение стоит провести.

Вторая задача — сделать работу с расширенными пробелами в Paratext более удобной. Я БЫ ОЧЕНЬ РАД видеть серые квадраты для неразрывных пробелов. Инструмент пунктуации может просто работать, так как он уже показывает значения Unicode для комбинаций.

Переведено машиной с языка English
0 голосов

Я думаю, что в качестве начального предложения мы могли бы попросить Paratext добавить в меню Project View (Представление проекта) опцию «Показать скрытое форматирование». Когда вы делаете это в Word, вы получаете следующее для серии из трех пробелов, трех NBSP и трех NNBSP (202F):
image
В LibreOffice Writer вы получаете:
image

LO Writer не показывает NBSP, и ни один из них не показывает NNBSP. Чтобы стать золотым стандартом, нам нужно было бы это исправить. Но вы также не хотите иметь разные символы для каждого возможного скрытого форматирования, поэтому, возможно, мы перейдем к отображению кода символа, за исключением нескольких основных символов, таких как пробел и NBSP (у которых будет символ), возможно, в виде небольшого диагонального узора? Как насчет чего-то вроде этого:

Я думаю, что полезно показывать скрытое форматирование другим цветом. Matthew_Lee предлагает серый, LO Writer использует синий, Word просто продолжает использовать черный. Мне тоже нравится идея с серым, но хитрость будет в том, чтобы подобрать правильный оттенок серого, чтобы он был заметным, но ненавязчивым.

Очевидно, если мы отображаем код символа, то все ставки сняты относительно фактической ширины символа. То же самое относится и к скрытому форматированию, отображаемому в Word или LO Writer.

Что касается «упрощения» пробелов в Paratext, я бы предложил, чтобы Paratext продолжал сжимать несколько пробелов в один, но ТОЛЬКО для фактических пробелов U+0020. Любые другие пробелы или символы скрытого форматирования должны сохраняться.

В конечном итоге, вероятно, нам захотелось бы иметь некоторые сочетания клавиш для ВВОДА этих символов скрытого форматирования непосредственно в Paratext, но пока мы можем полагаться на AUTOCORRECT.TXT и/или клавиатуры Keyman для ввода этих символов.

Хорошо, так что это одна идея, брошенная на арену… Каковы плюсы и минусы? Какие у вас есть другие идеи?

Переведено машиной с языка English
от (1,4тыс. очков)

Вот что я имел в виду, когда говорил, что LibreOffice (6) показывает NBSP, как я помнил: это даже не режим показа всех символов, а просто обычный вид. Я полагаю, что это значение по умолчанию. Не так ли в LO 7?

image

Вы правы в том, что он не показывает NNBSP (даже в режиме показа всех символов), но мы получаем удобные подсчитываемые точки для NBSP и пробела.

image

Диагональное предложение jeffh элегантно, но нам понадобится шрифт с этими буквами. Существуют существующие шрифты, которые используют алфавитно-цифровой квадрат для отображения значений Unicode шрифтов.

image

Я действительно боюсь, что разрешение на использование дублированных нестандартных пробелов приведет к отступам с несколькими пробелами, так же как люди уже злоупотребляют этой возможностью в Word, но это будет соответствовать другим веб-стандартам потока текста.

У меня на клавиатуре есть NBSP уже много лет, но у меня также есть такие символы, как крестик (dagger), знак копирайта и пустой круг.

Переведено машиной с языка English

В моей конфигурации LO Writer 7 была отключена опция в Tools - Options - LibreOffice Writer - Formatting Aids (Инструменты - Параметры - LibreOffice Writer - Вспомогательные средства форматирования), опция Non-breaking spaces (Неразрывные пробелы) была отключена. При включенной опции я действительно получаю серый квадрат, о котором вы говорили:
image
Но не точку…

Переведено машиной с языка English
+1 голос

Это очень ободряющий разговор. Приятно слышать о потребностях и потенциальных решениях в контексте Paratext и других инструментов. Я ожидаю, что это будет «полезно для многих» и, следовательно, вероятно, будет рассмотрено в приоритете перед менее полезными функциями.

(Кстати - потому что я думаю, что видел несколько упоминаний о том, как набирать некоторые символы, которые не отображаются на стандартных клавиатурах … Для тех, кто еще не знает, ввод необычных символов без стороннего приложения можно упростить, используя приложение Character Map (Таблица символов) в Windows. Когда вы щелкаете по символу в таблице символов, в правом нижнем углу приложения для многих символов отображается сочетание клавиш «Keystroke». Это сочетание можно набрать, удерживая Alt и вводя четыре цифры с numpad (цифровая клавиатура, а не цифры над буквами). Например: Alt+0160 вводит неразрывный пробел (U+00A0), Alt+0169 генерирует символ ©, en-dash (короткое тире) — это Alt+0150 –, а em-dash (длинное тире) — это Alt+0151 —.)

Переведено машиной с языка English
от [Moderator]
(1,2тыс. очков)

снова показан
0 голосов

Вот только один комментарий в отношении цифровой публикации через DBL. Загрузчик Paratext удаляет неразрывные пробелы при создании пакета USX, который мы делим с издателем. К сожалению, когда текст распространяется в цифровом виде, неразрывные пробелы исторически вызывали проблемы.

Переведено машиной с языка English
от (192 очков)

А что насчет НЕ использования неразрывных пробелов?! Вот случайная страница из Parole de Vie, уважаемого французского перевода, как она отображается в YouVersion, уважаемом библейском приложении:

Обратите внимание на разорванные (проблемные) разрывы пунктуации, которые выделены. Я вздрагиваю каждый раз, когда вижу это, и я вижу это ЧАСТО в текстах, извлеченных из DBL, именно (я предполагаю) потому, что допустимые неразрывные пробелы были преобразованы в обычные пробелы.

Если мы хорошо обработаем неразрывные пробелы в Paratext, то, я думаю, загрузчик не должен удалять их при загрузке в DBL. Так что давайте сделаем это!

Переведено машиной с языка English

Я согласен с тем, что они «исторически» вызывали проблемы. Это было бы верно повсеместно до Unicode, но если создатели контента и нижестоящие издатели до сих пор не научились поддерживать специальные пробелы, пришло время это сделать.

Удаление NBSP в наши дни — это ошибка, поскольку технологии отображения, которые мы используем, все имеют процесс для обработки правильно закодированных пробелов (HTML, XML, TeX, inDesign), и эти пробелы являются частью стилистических руководств для многих основных и меньшинственных языков мира. Любой код, который находится под управлением Paratext, может быть изменен, включая внутреннее отображение и экспорт USX. TeX и SAB уже обрабатывают все эти пробелы, иначе взлом print-draft-changes не работал бы в печатном черновике или ptxPrint (возможно, кто-то из PTXPrint может высказаться). Если стандарты USFM и USX в настоящее время запрещают неразрывные пробелы, их необходимо будет изменить.

Я знал, что это изменение нужно будет внести во всю цепочку, но это не делает его менее важным. Paratext, Chorus, USFM, USX и другие должны перестать удалять их и начать поддерживать и отображать их. Я подозреваю, что основные граничные случаи возникнут, если кто-то решит заменить КАЖДЫЙ пробел на NBSP и переполнит строку.

Здесь, в Камеруне, я все еще говорю о символах IPA в языке как о «специальных символах», но с широкой поддержкой, которую мы имеем, один из лингвистов здесь недавно напомнил мне, что нам следует просто называть их «символами». Инструменты, которые не могут поддерживать широкий спектр символов в тексте, становятся все реже и реже. Последним рубежом кажется поддержка специальных символов в именах папок для командной строки Windows. Windows поддерживает это уже много лет, но вещи все еще ломаются.

~Matthew_Lee

Переведено машиной с языка English

Привет, jeffh,

Я отправил ваше беспокойство нашим друзьям в YouVersion… хотя я полагаю, что процесс преобразования неразрывных пробелов в обычные пробелы выполняется в загрузчике Paratext, а не на стороне YouVersion (или любого другого издателя).

Переведено машиной с языка English

Спасибо за связь с людьми из YouVersion, @anon175865. Да, как вы упомянули, я предполагаю, что любые неразрывные пробелы уже исчезли в DBL, удаленные загрузчиком Paratext. Так что это не их вина. Но то, что говорят @Matthew_Lee и я, заключается в том, что нам нужно исправить нашу цепочку, чтобы Paratext был удобен для работы с этими специальными пробелами и мог легко их обрабатывать, а загрузчик не удалял бы их. Тогда они будут в DBL, и когда YouVersion использует эти тексты, они будут правильно отображаться на экране.

Переведено машиной с языка English
+1 голос

WSTech обсудил некоторые из проблем в этой теме, и я хотел отправить резюме:

  • Я подозреваю, что очень большая тильда, которая отображается (для NBSP), исходит из шрифта Charis SIL. Если используется другой шрифт латиницы, меняется ли размер тильды?
  • Существуют шрифты, которые автоматически регулируют пробелы вокруг знаков препинания (что необходимо во франкоязычных регионах), но они, кажется, редки. Поэтому добавление необходимых пробелов, похоже, лучший подход.
  • Использование отдельного шрифта для отображения значений Unicode пробелов (то есть не основного шрифта, используемого для текста) должно сработать.
  • PTXprint может обрабатывать все различные символы пробелов.
Переведено машиной с языка English
от (185 очков)

WSTech также недавно отрегулировал ширину пробелов в наших шрифтах. Для обратной совместимости шрифты латиницы (и, возможно, некоторые другие) не следуют нашим новым рекомендациям для всех пробелов, только для некоторых.

Переведено машиной с языка English

Меня радует, что я получил столько откликов, в том числе от WSTech и Paratext. Как нам двигаться дальше? Нужно ли оформить это как запрос на новую функцию и пройти стандартный процесс приоритизации?

Основные проблемы (которые можно решать отдельно) следующие:

  1. Позволить существование NBSP и аналогичных символов, упомянутых в этой теме, на всех этапах конвейера PTX/USFM/USX/DBL (и по мере необходимости решать возникающие проблемы отображения). Это первый и самый важный барьер. Затем мы сможем «исправлять» пробелы в отдельных проектах по мере продвижения.
  • Эти символы должны корректно отображаться в стандартном режиме PTX и в предпросмотре.
  • Они должны распознаваться индивидуально в проверках «Пунктуация» и «Символы» (Punctuation and Character checks).
  • Они должны приниматься в настройках «Кавычки» и «Числа» (Quotation and Number settings) (обратите внимание, что FLEx использует точки для отображения пробелов в Configure Dictionary).
  1. Предоставить способ визуализации этих символов непосредственно в Paratext.
  • В качестве возможного решения предлагались специальные временные шрифты.
  • Предлагалось постоянное отображение серых квадратов.
  • Функция показа всех символов, аналогичная той, что есть в Word/LibreOffice.
    • Один из моих пользователей предложил, чтобы функция Show/hide открывала диалоговое окно (похожее на диалог Basic Checks), позволяющее указать, какие специальные символы нужно показывать (обычные пробелы, неразрывные пробелы, соединители, неразрывные дефисы, маркеры двунаправленного текста, мягкие и жёсткие переносы). Я могу представить случаи, когда технический специалист хочет подсветить все маркеры (что я часто делаю во внешних инструментах), а также ситуации, когда команде нужно подсвечивать только «специальные» маркеры.
    • изображение

~Matthew_Lee

Переведено машиной с языка English

Да, это был бы лучший вариант. Также было бы полезно сослаться на эту тему в любом запросе на новую функцию.

Для тех, кто не знаком с процессом создания запроса на новую функцию — он доступен всем пользователям Paratext. В главном меню Paratext выберите Help > Give feedback и в появившейся форме выберите опцию Make a suggestion....

Если кому-то кажется, что запрос на новую функцию особенно важен или полезен, стоит сообщить об этом вашему региональному или организационному представителю Paratext. Они могут решить представить его на ежеквартальных совещаниях по приоритизации Paratext.

Переведено машиной с языка English
+1 голос

Это уже было отправлено как запрос на новую функцию. На эту тему была дана ссылка в отчете.

Соответствующие отчеты:
https://paratext.myjetbrains.com/youtrack/issue/PTX-22626
https://paratext.myjetbrains.com/youtrack/issue/PTUX-1318
https://paratext.myjetbrains.com/youtrack/issue/PTX-22623

Переведено машиной с языка English
от (231 очков)
снова показан

Ещё один комментарий, который я добавил в YouTrack:

Невидимые символы должны быть перечислены в списках символов и пунктуации (Character and Punctuation inventories), что будет лучшим показателем их существования и контекстов, в которых они используются. Также они должны быть разрешены как допустимые разделители в настройках «Кавычки» (Quotation settings) ([NBSP]»), настройках ссылок на Писание (Scripture reference settings) (1[NBSP]Царств) и настройках «Числа» (Number settings) (10[NBSP]000). Это покрыло бы многие сценарии использования.

Переведено машиной с языка English
0 голосов

Я присоединяюсь к обсуждению с опозданием, только что обнаружил эту тему.

Я ставлю свой +1, или даже +100000, за эти предложенные функции. Я работаю с другим языком, где по историческим и сосуществующим причинам орфография стремится быть максимально близкой к французской.

Я хотел бы напомнить всем ознакомиться с французской типографикой, прежде чем вносить какие-либо технические изменения. Французская типографика даже сложнее, чем знают обыватели. Да, вокруг определенных знаков препинания есть пробелы, но они не одинаковы. Например, пробел перед (слева от) двоеточия должен быть полного размера.

У меня есть документ, собранный из нескольких источников, и, к сожалению, основной источник больше не доступен в сети.

Также доступны полезные бумажные книги, такие как «Lexique des règles typographiques» en usage à l’imprimerie nationale" от imprimerie nationale (Франции) и «Règles de l’écriture typographique du français à l’usage des personnes qui exercent une activité sur MAC ou PC» от Yves Perrousseaux.

Переведено машиной с языка English
от (934 очков)
снова показан
0 голосов

Пока что мы полностью используем и принимаем тильду в PT, как другие люди справляются с XeTeX, и я восхищаюсь ими, — но не желаю быть похожим на них.

Логика частой публикации через приложение и по частям Писания также актуальна для нашего контекста. И тильду нужно убрать как можно скорее.

Также больше шрифтов должны предоставлять узкий неразрывный пробел. Кажется, даже не все шрифты SIL это делают. Пожалуйста, кричите на меня, если они это делают; для меня это была бы хорошая новость, вполне заслуживающая крика.

Для ввода тильды сейчас (и, надеюсь, скоро NNBSP) я придумал удобную функцию для PT, где я использую встроенную функцию autocorrect.txt. Например, чтобы получить тильду плюс восклицательный знак, я трижды нажимаю восклицательный знак, и PT делает остальное правильным образом. Я настроил это для всех тех знаков препинания, которые требуют особого внимания.

(И я также использую это для ввода частых слов, таких как Авраам, Иисус или Иерусалим.)

Переведено машиной с языка English
от (934 очков)
снова показан

Похожие вопросы

0 голосов
4 ответов 532 просмотров
Tildes (used in USFMs as non-breaking spaces) disappear when the view is changed in Preview view, as expected. ... . Am I missing some step that would make these disappear?
Alex W. 191 задал вопрос июл 13, 2018
0 голосов
0 ответов 171 просмотров
(anon451647 writes) This line (in PrintDraftChanges.txt) will change a plus sign to a thin space if it has a non- ... not match them (especially if they are non-Roman letters).
аноним задал вопрос апр 10, 2015
0 голосов
1 ответ 64 просмотров
Давно не смотрел в Wordlist, и я был удивлён, увидев большой красный блок с упоминанием непоследовательной кодировки ... с этим справляться, будут более чем приветствоваться. Барт.
goodgoan 347 задал вопрос ноя 13, 2024
0 голосов
0 ответов 156 просмотров
We are having difficulties in parts of Paratext 8 with non-roman front rendering. The Karenni Unicode font we are ... KB Paratext 8 Conflicts Display Problem.jpg1298 866 178 KB
anon281504 144 задал вопрос фев 22, 2018
0 голосов
2 ответов 47 просмотров
В нашем проекте используется арабское письмо, и язык является агглютинативным. Из-за орфографических требований нашего языка ... предвижу, что это станет огромной помощью! Спасибо!
Nathaniel Shaver 102 задал вопрос апр 16, 2025
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
I appeal to you, brothers and sisters, in the name of our Lord Jesus Christ, that all of you agree with one another in what you say and that there be no divisions among you, but that you be perfectly united in mind and thought.
1 Corinthians 1:10
3,045 вопросов
6,005 ответов
5,671 комментариев
2,026 пользователей





