Ya, saya setuju dengan Matthew_Lee bahwa ini adalah masalah penting, terutama di dunia berbahasa Prancis. Ada beberapa hal yang ingin saya sebutkan dalam analisis saya, tetapi saya akan mencoba merangkumnya (TLDR) di bagian bawah posting ini.
Penelitian online singkat menunjukkan beberapa hal menarik, yang sebenarnya bukan “di luar topik”:
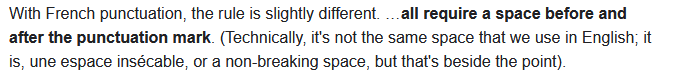
Dan beberapa kegagalan yang lucu (di mana mereka jelas-jelas menggunakan spasi biasa - yang dalam kasus ini menyebabkan pemutusan baris):
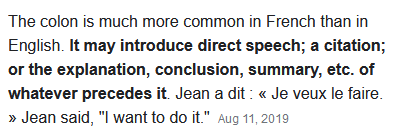
Itulah yang persis ingin kita hindari - bagian tanda baca yang tidak terhubung dengan teks terkaitnya. Jadi, jika kita akan menggunakan semacam karakter spasi untuk memisahkan tanda baca, kita HARUS SELALU menggunakan spasi non-breaking (non-breaking space) dari jenis tertentu.
Dua opsi utama adalah Full No-Break Space (NBSP, U+00A0), atau Narrow No-Break Space (NNBSP, U+202F), yang definisinya dapat ditemukan dalam standar Unicode, di https://unicode.org/charts/PDF/U0090.pdf dan https://unicode.org/charts/PDF/U2000.pdf, masing-masing:
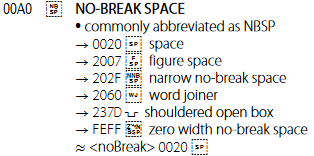
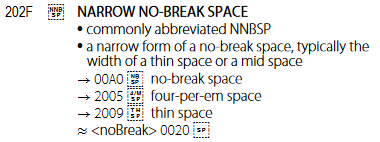
Sebagaimana Anda lihat, definisi NNBSP menyatakan bahwa lebarnya biasanya sama dengan lebar spasi tipis (thin space), yang didefinisikan dalam grafik yang sama sebagai :
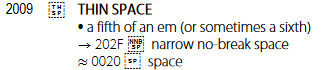
Jadi, NNBSP biasanya berukuran seperlima em (0.2em). Seberapa besar spasi biasa atau NBSP? Metrik ini bergantung pada font, tetapi perhitungan kasar dengan font Charis SIL menunjukkan bahwa karakter spasi dan NBSP berukuran sekitar 0.34em. NNBSP berukuran sekitar 0.22em. Ini adalah perbedaan yang signifikan, dan jika Anda menggunakan NBSP (atau sebagai langkah sementara, spasi biasa, yang memiliki kelemahan berupa pemutusan baris) di sekitar tanda baca, para typesetter yang saya kenal akan mengatakan bahwa spasi itu terlalu besar. Penggunaan NNBSP sangat membantu, dan dapat dilakukan dengan cukup mudah di PTXprint dengan perubahan seperti baris-baris berikut di PrintDraftChanges.txt:
' *:'  >    '\u202f:'     # Place non-breaking thin space before colon
'« *' >    '«\u202f'     # Place non-breaking thin space after opening guillemets
' *»' >    '\u202f»'     # Place non-breaking thin space before closing guillemets
'‹ *' >    '‹\u202f'     # Place non-breaking thin space after opening guillemets
' *›' >    '\u202f›'     # Place non-breaking thin space before closing guillemets
Ini menempatkan NNBSP sebelum atau sesudah (sesuai kebutuhan) tanda baca, dan juga menghapus spasi apa pun yang ada (jika ada). Artinya, terlepas dari apakah tim memasukkan spasi atau tidak, spasi tersebut akan dinormalisasi menjadi karakter NNBSP. Misalnya, dalam proyek ini, tim tidak konsisten dan menggunakan (spasi) biasa di sekitar tanda tanya dan titik dua, tetapi tidak di sekitar tanda kutip (guillemets):
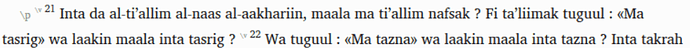
image945×67 35 KB
Perhatikan bahwa Anda dapat melihat bahwa ini hanyalah spasi biasa jika Anda menyesuaikan zoom dan/atau ukuran panel dengan tepat, karena spasi tersebut akan memungkinkan pemutusan baris, seperti ini:
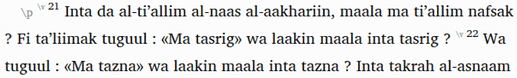
image755×114 48.8 KB
Tetapi perubahan di atas seharusnya dapat menangani kedua kasus tersebut dengan baik, dan menyisipkan NNBSP untuk typesetting.
Dengan cara yang serupa, Anda akan ingin menempatkan aturan perubahan dalam proyek SAB Anda, untuk memastikan bahwa aplikasi Alkitab Anda menangani spasi dengan benar. Periksa posting ini untuk contoh aturan: https://community.scripture.software.sil.org/t/suggestions-for-changes-gallery/590/3.
Perhatikan bahwa aturan dalam posting ini tidak menangani spasi atau tanpa spasi seanggun aturan di atas, tetapi Anda dapat menyesuaikannya dengan trik seperti " *" yang digunakan di atas.
Dan satu poin tambahan sebelum kita masuk ke Paratext… Dalam pekerjaan typesetting baru-baru ini, kami sebenarnya telah menggunakan sepersepuluh em (0.1em) sebagai spasi di sekitar tanda baca, yaitu lebih kecil dari NNBSP. Berikut adalah definisi tanda baca yang kami gunakan:
\catcode`\:=\active \def:{\unskip\kern0.1em\char`\:{}} % colon
Catatan: ini dilakukan dalam XeTeX, tetapi hal yang sama dapat dilakukan dengan PTXprint. Saya percaya Anda akan ingin mendefinisikannya dalam file konfigurasi ptxprint-mods.tex yang tersedia di tab tool Advanced. Ini memberikan spasi yang cukup minimal di sekitar tanda baca, seperti yang terlihat dalam contoh ini:
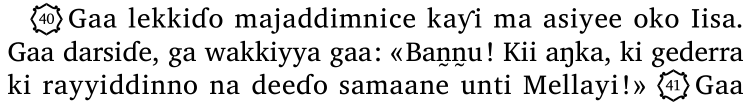
image752×102 11.5 KB
Tetapi tim-tim tersebut merasa bahwa itu adalah spasi yang cukup untuk memenuhi kebutuhan mereka akan spasi di sekitar tanda baca yang diperlukan dalam bahasa Prancis. (Tentu saja, orang Prancis mungkin tidak setuju, tetapi itu bukan bahasa mereka!)
Kesimpulan (TLDR): Jadi, apa artinya ini untuk Paratext?
Jika tim menggunakan spasi biasa dalam teks untuk menggeser tanda baca mereka, maka kadang-kadang itu akan muncul dengan tidak benar di layar mereka di Paratext (yaitu, dengan tanda baca yang tidak terikat dengan benar pada teksnya, seperti yang ditunjukkan di atas), yang mengganggu tetapi bukan akhir dari dunia. Dalam kasus ini, tanggung jawab ada pada typesetter atau pembangun aplikasi untuk mengubah spasi biasa tersebut secara tepat. Sayangnya, jika ini adalah bentuk yang dimasukkan ke dalam DBL (sangat mungkin), maka aplikasi seperti YouVersion akan mengalami masalah, karena mereka terkenal TIDAK menangani spasi tersebut dengan tepat.
Dengan kecenderungan ini menuju spasi non-breaking yang semakin kecil untuk memisahkan tanda baca (pertama NNBSP pada 0.2em, kemudian typesetting manual pada 0.1em dengan PTXprint) yang telah saya lihat dalam proyek typesetting saya, saya hampir selalu merekomendasikan agar tim TIDAK menempatkan spasi di sekitar tanda baca mereka di Paratext, dan kemudian hanya mempercayakan typesetting atau pembangunan aplikasi untuk melakukan hal yang benar di sekitar tanda baca tersebut. Ini berarti bahwa ketika teks dimasukkan ke dalam DBL, YouVersion tidak akan memiliki tanda baca yang menggantung. (Tidak akan ada spasi di sekitar tanda baca juga, tetapi itu adalah masalah yang lebih kecil menurut saya.)
Jadi, dengan rencana tindakan spesifik ini, tidak diperlukan perubahan di Paratext. Jika Anda menginginkan, seperti yang disarankan Matthew_Lee, cara untuk menampilkan karakter NNBSP atau NBSP, saya pikir itu akan menjadi ide yang bagus, tetapi keyboard kami juga perlu memiliki cara untuk mengetik karakter-karakter tersebut (yang tidak selalu tersedia), dan Paratext perlu tahu untuk tidak mengutak-atik karakter-karakter tersebut. (Dan inventaris tanda baca perlu menunjukkan semua kombinasi dengan spasi-spasi tersebut, untuk memastikan bahwa mereka digunakan secara konsisten, misalnya, selalu dengan NNBSP.)
Posting ini tidak begitu banyak mengusulkan solusi, melainkan menyediakan lebih banyak latar belakang dan informasi. Saya benar-benar tidak suka cara kerja tilde / NBSP ini di Paratext sekarang, dan setuju bahwa itu harus berubah. Sepertinya Paratext harus mengasumsikan bahwa ia harus mengambil setiap karakter dalam teks secara apa adanya, baik itu tilde, NBSP, atau NNBSP. Dan cara untuk melihatnya (secara halus) akan menjadi hal yang bagus. Apakah dua atau lebih spasi harus digabungkan secara otomatis (menanggapi @anon942452)? Mungkin jika mereka adalah karakter yang identik? Itu masih akan memungkinkan perbaikan spasi otomatis Paratext, tetapi juga menyediakan beberapa opsi untuk menghindarinya. Dan seseorang juga perlu memikirkan cara untuk menangani semua proyek legacy yang memiliki tilde untuk spasi non-breaking, mungkin hanya konversi, untuk mengubah semuanya menjadi NBSP, setelah itu ditangani dengan benar di Paratext.
Nah, beberapa bahan pemikiran lagi…








