Bonjour, j'avais le même problème et voici ce que Doug Higby m'a envoyé en décembre, ce qui m'a aidé à résoudre le problème :
Vos données interlinéaires sont stockées dans la base de données et étiquetées avec la langue des gloses. Vous pouvez consulter votre répertoire de projet Paratext pour voir avec quel(s) code(s) de langue vos interlinéaires existants ont étiqueté les gloses.
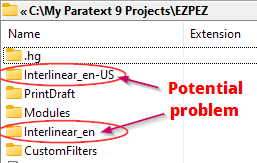
Disons que toutes vos gloses ont disparu après la mise à niveau vers 9.2 et la réouverture de l'interlinéaire. Si vous n'avez pas encore travaillé dans le nouvel interlinéaire vierge, vous n'aurez qu'un seul répertoire affiché ici, en-US. Celui avec l'étiquette de langue que vous avez utilisée. Pour voir à nouveau vos gloses, vous devrez créer un nouvel interlinéaire de l'une des deux manières suivantes :
- Créer un interlinéaire sans texte modèle et sélectionner en-US comme langue.
OU
- Créer un interlinéaire avec un texte modèle qui est en-US. Vous pouvez voir la langue du texte modèle dans la boîte de dialogue Open Resource :

Si vous avez deux répertoires interlinear_XYZ et que vous ne savez pas lequel est le code de langue que vous avez utilisé, ouvrez simplement chaque répertoire et voyez lequel contient plus de fichiers et avec des dates antérieures. Dans la capture d'écran en haut, le dossier Interlinear_en ne contenait qu'un seul fichier de 500 octets. L'autre contenait plusieurs livres avec des tailles de fichiers plus importantes. Évidemment, en-US est la langue que je dois sélectionner lors de la configuration de l'interlinéaire si je veux revoir mes gloses.
Hello, I had the same problem and this was what Doug Higby sent back in December which helped me fix the problem:
Your interlinear data is stored in the database and tagged with the language of the glosses. You can look in your Paratext project directory to see what language code(s) your existing interlinear has been tagging the glosses with.
Let’s say that all your glosses went missing after upgrading to 9.2 and reopening the interlinear. If you haven’t worked yet in the new blank interlinear, you will only have one directory showing here, en-US. The one with the language tag you have been using. To see your glosses again, you will need to create a new interlinear in one of two ways:
- Create an interlinear with no model text, and select en-US as the language.
OR
- Create an interlinear with a model text that is en-US. You can see the language of the model text in the Open Resource dialog:
If you have two interlinear_XYZ directories and don’t know which is the language code you have been using, just open each directory and see which one has more files, and with past dates. In the screenshot at top, the Interlinear_en folder had only one file in it that was only 500bytes in size. The other one had multiple books with larger file sizes. Clearly, en-US is the language I need to select when setting up the interlinear if I want to see my glosses back.
Traduit automatiquement depuis English