+3 голосов
672 просмотров

В моём списке слов (Wordlist) в Paratext есть ряд иностранных слов, которые берутся с титульной страницы (например, «Иллюстрации», «разрешение» или имена художников) или из текста между \tl…\tl*.
Есть ли способ исключить такие слова, чтобы они не появлялись в списке слов, или каким-то образом пометить их как не относящиеся к данному языку?
Спасибо!

Переведено машиной с языка English
Paratext от (245 очков) | 672 просмотров

8 Ответов

0 голосов
Лучший ответ

This issue has been on our minds for a long time (I think I say that a lot on this forum) and it relates to approval of not just words, but also characters and punctuation.

As you all have noted, the Wordlist and Inventories currently only let teams approve words “everywhere” or “nowhere”, but things are rarely that simple. The solution we have planned shows the status of words (or characters) in scripture and non scripture locations in separate columns in the Wordlist and inventories.

Specifying approval according to location will be available to those who want it. It will not be required for those who do not need it.

The early signs of these changes can be seen in Find in PT9.2. This allows users to search in “Verse text” or “All text” (‘non-verse text’ coming "soon"™️). Also, the Wordlist no longer has three buttons in every row for setting approval of words. Instead, status is set in the column header according to the active row. This is because when we add a column for non-verse text (and in Study Bible projects, another column shows for study bible material), the “wall” of 6-9 buttons per row becomes a bit overwhelming. A mockup of the Characters Inventory below gives a good idea of how this would look in Wordlist. By default, approving a word in verse text will also approve it in non-verse text; approving a word in non-verse text does not approve that word in verse text.
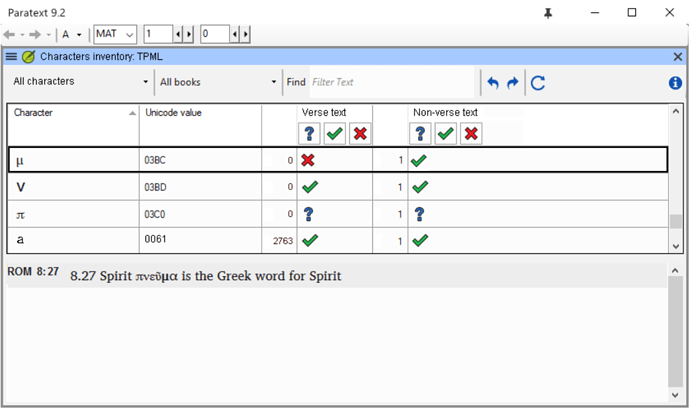
We hadn’t thought of there being a need for a separate hyphenation list. That’s something for us to bear in mind.

You’re probably all wondering when this will be implemented. It may be in 9.4 (no guarantees).

от [Moderator]
(1,2тыс. очков)
0 голосов

В настоящее время нет способа исключить эти слова из списка слов. Список слов — это не просто перечень слов на данном языке, а список слов, встречающихся в тексте проекта. Важно проверить все эти слова, поскольку в написании иностранных слов может быть допущена ошибка.

Переведено машиной с языка English
от (9,9тыс. очков)
+1 голос

Paratext на самом деле исключает неподлежащие публикации (nonpublishable) слова из списка слов. Например, слова в примечаниях не отображаются в списке слов. Чтобы исключить справочный текст из таблиц текста карт, я создал пользовательский стиль символов \zrm …\zrm* с параметром \TextProperties nonpublishable и добавил его в файл frtbak.sty моего проекта:

# Map Table Reference text
# Reference text in Map tables marked with \zrm ...\zrm* do not appear in the Wordlist or other checks 
\Marker zrm
\Endmarker zrm*
\Name zrm...zrm* - Remark span
\Description For Comments and remarks
\OccursUnder ip im ipi imi ipq imq ipr iq iq1 iq2 iq3 io io1 io2 io3 io4 ms ms1 ms2 s s1 s2 s3 s4 cd sp d lh li li1 li2 li3 li4 lf lim lim1 lim2 lim3 lim4 ili ili1 ili2 ili3 ili4 m mi nb p pc ph phi pi pi1 pi2 pi3 pr pmo pm pmc pmr po q q1 q2 q3 q4 qc qr qd qm qm1 qm2 qm3 cls tr th1 th2 th3 th4 thr1 thr2 thr3 thr4 tc1 tc2 tc3 tc4 tcr1 tcr2 tcr3 tcr4 f fe ef rem NEST
\TextType Other
\TextProperties nonpublishable 
\StyleType Character
\FontSize 12
\Color 16711680 # Same color as \rem

Вот пример того, как это используется в книге BAK проекта

\periph Map 02_03 The World of the Patriarchs

\tr \thc1 \zrm The world of the Patriarchs \zrm* \thc2 পিতৃপুৰুষদেৰ জগৎ
\tr \th1 \zrm Legend \zrm* \th2 ~
\tr \tc1 \zrm km\zrm* \tc2 কিমি
\tr \tc1 \zrm Journeys of Abraham\zrm* \tc2 অব্ৰাহামেৰ যাত্ৰা

Слова в первом столбце исключаются из списка слов, но слова во втором столбце проверяются на орфографию.

Хочу добавить, что я не рекомендую исключать из списка слов какие-либо слова, которые будут опубликованы. Имена и слова в заявлении об авторских правах также следует проверять на орфографию.

Переведено машиной с языка English
от (1,8тыс. очков)
снова показан

Учитывая оговорки, которые делает @CrazyRocky, я тоже довольно часто использую маркер nonpublishable по тем же причинам, что перечислены здесь.

Один недостаток состоит в том, что PT также игнорирует символы nonpublishable при выполнении определенных поисков и выдаче результатов. Например, при поиске скобок и некоторых других проверках я часто получаю странные результаты, например, то, что выглядит как набор знаков скобок с пустым содержимым, но на самом деле содержит только символы nonpublishable. В результате я время от времени редактирую свой файл custom.sty, чтобы PT обрабатывал иностранные слова так, как я хочу в данный момент.

Я добавляю «nonpublishable» в файл стилей custom.sty, а затем возвращаю его обратно в «publishable» в файле PrintDraft-mods.sty и/или в соответствующих файлах ptxprint.sty.

Переведено машиной с языка English
+1 голос

Я сталкивался с этим много раз. Я поддерживаю команды переводчиков, которые готовятся к публикации, проходя через их финальные проверки, включая список слов. Наша цель для списка слов всегда «0 неизвестных или неправильных слов в НЗ», но наш подсчет всегда включает эти 100–200 французских слов (потому что эти команды находятся в ЦАР, франкоязычной стране), которые они решили включить в свой текст. Неразумно ожидать, что они будут использовать ТОЛЬКО свой родной язык (MT), поскольку многие члены их общин говорят и читают хотя бы немного по-французски. Обычно это одно слово здесь или там, часто курсивом: Вот как вы пишете «X французское слово» на нашем языке.

Поэтому я хочу сделать предложение разработчикам: можно ли создать способ исключить иностранные слова из списка слов или предоставить способ удалить их из подсчета «неизвестных слов»? У меня есть две идеи о том, как это можно сделать.

  1. Добавить необязательный четвертый флажок в списке слов? Например, синий вопросительный знак, зеленая галочка, красный крестик и… скажем, оранжевая звезда? (Или какой-то четвертый значок + другой цвет, означающий «иностранное слово»?) Проблема в том, что глобальная валидация, происходящая в списке слов, не подходит для «иностранных слов», поскольку каждый случай использования иностранного слова должен быть рассмотрен и проверен отдельно. Так что, я думаю, этот четвертый флажок будет означать «это слово не является орфографией родного языка, но оно не является «неизвестным», его можно игнорировать для целей списка слов, но каждый случай должен быть проверен перед публикацией, чтобы убедиться, что оно все еще корректно».

  2. Другой вариант — изменить \tl или какой-либо другой маркер, чтобы он стал маркером «иностранных слов». Это не изменит никакого форматирования, только то, как PTX обрабатывает его: «это слово можно игнорировать в списке слов». В отличие от идей «nonpublishable», описанных выше, оно все равно должно быть подлежащим публикации. Это решит проблему «проверки каждого случая», о которой я упомянул выше, но потребует специальных маркеров для каждого и каждого случая каждого слова.

Скорее всего, для любого из вариантов потребуется какой-то инвентарь + базовая проверка для обеспечения валидации, но я не уверен, как это можно сделать в каждом отдельном случае.

Так что вы думаете? Было бы полезно попросить разработчиков об этом?

Спасибо,
~anon550568

Переведено машиной с языка English
от (114 очков)

У варианта 2 будет дополнительное преимущество. В некоторых случаях определенная последовательность символов может быть как (правильно написанным) иностранным словом, так и словом на родном языке (правильно или неправильно написанным). Возможно, хотелось бы оценивать такие случаи индивидуально.

В таких случаях идеальным решением было бы иметь возможность указывать PT игнорировать отдельные вхождения слов — так же, как мы можем отклонять отдельные ошибки в базовых проверках (и PT запомнит этот выбор). Если это слишком сложно для реализации, игнорирование определенного маркера при проверке орфографии может быть хорошим альтернативным решением.

Кстати, когда речь идет о финальной проверке орфографии, я обычно определяю фильтр, включающий все библейские книги (и, возможно, глоссарий и введение) и исключающий титульные листы. Но это не решает проблему, если книга INT содержит как введение на родном языке, так и введение на литературном языке (LWC).

Paulus+Kieviet

Переведено машиной с языка English

P.S. Еще один пример, где я хотел бы исключить отдельные вхождения, — это: в нескольких книгах Оглавление содержит элементы второго уровня, которые помечаются буквами алфавита. Алфавит родного языка — «a e f» и т.д. Теперь «a» и «e» также являются опечатками слов на родном языке (должно быть ꞌ****a и ꞌ****e, соответственно), поэтому было бы хорошо иметь возможность игнорировать эти вхождения. Я знаю, это мелочь, но это просто не позволяет нам достичь того очень удовлетворительного уровня, когда количество неправильных или неопределенных слов равно нулю.

Paulus+Kieviet

Переведено машиной с языка English

Описания изображений на английском языке часто остаются в подписях к рисункам вместе с подписями на родном языке (хотя и не отображаются в выводе). Это был бы еще один раздел, который можно было бы выборочно игнорировать.

Переведено машиной с языка English
0 голосов

Пока я сегодня работал с другой командой над их списком слов, мне пришло в голову еще одно преимущество, которое принесло бы это изменение, особенно идея маркера «игнорировать это слово»… французские слова были бы удалены из списка слов, поэтому пользователю не пришлось бы постоянно пропускать их. В настоящее время все проверки орфографии — и даже ручная проверка — должны мысленно пропускать любые иностранные слова, поскольку в настоящее время нет способа исключить их, часто много раз за одну сессию, потому что они повсюду! Их удаление сэкономило бы нам всем много ментальной работы.

Переведено машиной с языка English
от (114 очков)

\tl … \tl* был бы хорошим кандидатом для слов, которые нужно игнорировать. По умолчанию он выводит слова курсивом, но это можно переопределить.

Paulus+Kieviet

Переведено машиной с языка English
0 голосов

Не знаю. Маркер \tl уже имеет определенное назначение — на самом деле помечать иностранные слова в тексте, поэтому, возможно, им придется создать новый маркер специально для этого, который не изменяет форматирование, а только выполняет функцию «игнорирования в списке слов»… хотя не было бы плохой идеей ТАКЖЕ исключить слова \tl из списка слов.

Переведено машиной с языка English
от (114 очков)
снова показан
0 голосов

На случай, если кто-то планирует использовать nonpublishable … Будьте предупреждены, что вторая часть комментария mnjames выше действительно важна (сделать их publishable в локальном файле стилей): nonpublishable используется PTXprint для обозначения «это комментарий, не выводить ничего на страницу здесь». То есть он будет молча пропущен.

Paratext на самом деле уже имеет \tl с \TextProperties nonvernacular, то есть он должен обрабатываться иначе, чем другие слова.

В переводе, над которым мы работаем, у нас довольно много слов на национальном языке в качестве синонимов / переводов в нашем глоссарии и сносках. Будучи на национальном языке, они нарушают всевозможные правила для родного языка, но являются частыми опечатками/ошибками, когда люди устают. Было бы очень хорошо иметь возможность исключить их из инвентарей символов и т.д.

Я бы предложил, чтобы текст в любом стиле «nonvernacular»:

  1. Был доступен для поиска
  2. Полностью игнорировался для инвентарей символов и пунктуации (если только кто-то не захочет реализовать второй набор инвентарей для не-родного языка).
  3. Имел отдельную и отдельную запись в списке переносов, чтобы они могли переноситься и проверяться на орфографию по-разному. (То есть правильная орфография в контекстах nonvernacular не должна влиять на контексты non-vernacular, и наоборот).
Переведено машиной с языка English
от (294 очков)

Для проектов, с которыми я работаю, я определенно хочу, чтобы слова, не относящиеся к родному языку, были опубликованы, поэтому я бы не пошел по пути использования каких-либо маркеров non-publishable. Я просто хочу способ исключить эти слова из списка слов… или, как вы предложили, anon542642, способ переместить их в отдельный интерфейс.

Как я обсуждал с Matthew_Lee, мы задумываемся, не может ли это быть действие правой кнопкой мыши или другое необязательное действие, как когда мы отклоняем ошибки в базовых проверках. Таким образом, мы «отклоняем» слово, а затем можем выбрать фильтр для «всех отклоненных слов» и просмотреть их.

Переведено машиной с языка English
0 голосов

Вместо «игнорирования» или «отклонения» иностранного слова, мне было бы более логично пометить иностранное (правильно написанное) слово как таковое. Правый клик > Пометить как правильно написанное иностранное слово (или другой вариант). Тогда Paratext мог бы распознавать (в других контекстах), что это слово ПРАВИЛЬНО, но оно не принадлежит к контексту списка слов родного языка. И его можно было бы отобразить в отдельном списке, или в под-списке, или иметь фильтр для отображения ВСЕХ слов, только слов родного языка, или только иностранных слов.

Переведено машиной с языка English
от [Moderator]
(2,1тыс. очков)

Похожие вопросы

0 голосов
1 ответ 299 просмотров
Мне известно о теме Исключение иностранных слов из списка слов , и я считаю запланированный ответ на ... алфавитом) является опечаткой, которую могут допустить переводчики.
anon542642 294 задал вопрос мар 16, 2023
+1 голос
1 ответ 198 просмотров
Dear All, I would like to how can I mark and display the scriptural text with a certain color or ... International Certified) ACC Coach(International Coach Federation) GMT+8.00
anon221954 128 задал вопрос дек 17, 2019
0 голосов
3 ответов 557 просмотров
Как в заметках (Notes) найти все заметки, в которых нет определённого слова (в данном случае UNS )? Я немного ... с регулярными выражениями в поле поиска, но не могу разобраться.
skim1124 219 задал вопрос июл 6, 2022
0 голосов
2 ответов 396 просмотров
Here's your chance to shape how the wordlist tool works. Consider the following . . . In Paratext, WordList has ... wordlist. Screenshot_2020-03-05-11-01-37800 1280 139 KB
[Moderator]
anon089134
239
задал вопрос мар 5, 2020
0 голосов
4 ответов 529 просмотров
При экспорте части Евангелий из Paratext в PDF слова Иисуса, выделенные красным цветом, не отображаются в файле. При экспорте в RTF это работает, но не в PDF.
ace541611 123 задал вопрос июл 7, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Just as a body, though one, has many parts, but all its many parts form one body, so it is with Christ.
1 Corinthians 12:12
3,048 вопросов
6,007 ответов
5,672 комментариев
2,027 пользователей





