+3 votos
673 visualizações

Eu tenho um número de palavras estrangeiras na minha Lista de Palavras do Paratext que vêm da página inicial (por exemplo, 'Ilustrações', 'permissão' ou os nomes de artistas) ou de entre \tl…\tl*.
Existe uma maneira de excluir essas palavras para que elas não apareçam na Lista de Palavras ou de marcá-las de alguma forma como não pertencentes ao idioma?
Obrigado!

Tradução automática de English
Paratext por (245 pontos) | 673 visualizações

8 Respostas

0 votos
Melhor resposta

Essa questão tem passado pela nossa mente há muito tempo (acho que eu digo isso com frequência neste fórum) e está relacionada à aprovação não apenas de palavras, mas também de caracteres e pontuação.

Como todos notaram, a Wordlist e os Inventories atualmente permitem que as equipes aprovem palavras “em todos os lugares” ou “em nenhum lugar”, mas as coisas raramente são tão simples. A solução que planejamos exibe o status das palavras (ou caracteres) em localizações de escritura e não escritura em colunas separadas na Wordlist e nos inventários.

Especificar a aprovação de acordo com a localização estará disponível para aqueles que a desejarem. Não será obrigatória para aqueles que não a necessitarem.

Os primeiros sinais dessas mudanças podem ser vistos em Find no PT9.2. Isso permite que os usuários pesquisem em “Verse text” ou “All text” (‘non-verse text’ chegando “em breve”™️). Além disso, a Wordlist não tem mais três botões em cada linha para definir a aprovação de palavras. Em vez disso, o status é definido no cabeçalho da coluna de acordo com a linha ativa. Isso ocorre porque, quando adicionamos uma coluna para texto não versículo (e em projetos de Bíblia de Estudo, outra coluna aparece para material de Bíblia de Estudo), a “parede” de 6 a 9 botões por linha se torna um pouco esmagadora. Um mockup do Characters Inventory abaixo dá uma boa ideia de como isso ficaria na Wordlist. Por padrão, aprovar uma palavra no texto do versículo também a aprovará no texto não versículo; aprovar uma palavra no texto não versículo não aprova essa palavra no texto do versículo.
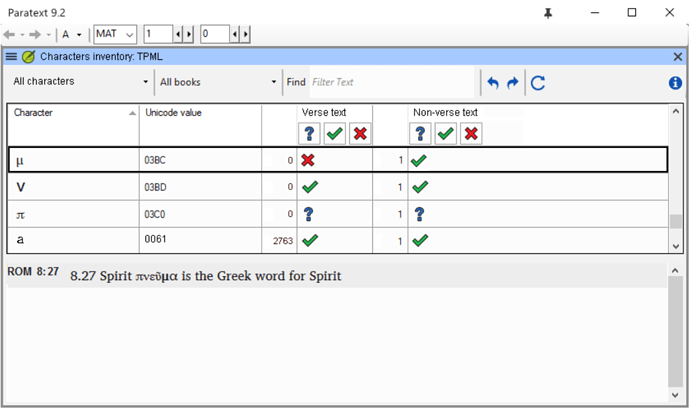
Não havíamos pensado que haveria necessidade de uma lista separada de hifenização. É algo para termos em mente.

Vocês provavelmente estão se perguntando quando isso será implementado. Pode estar na versão 9.4 (sem garantias).

Tradução automática de English
por [Moderator]
(1,2k pontos)
0 votos

Atualmente, não há como excluir essas palavras da Lista de Palavras. A Lista de Palavras não é simplesmente uma lista de palavras no idioma, mas uma lista de palavras que ocorrem no texto do projeto. É importante verificar todas essas palavras, pois é possível haver erros de digitação em palavras estrangeiras.

Tradução automática de English
por (9,9k pontos)
+1 voto

O Paratext na verdade exclui palavras não publicáveis da Lista de Palavras. Por exemplo, palavras em notas não são encontradas na lista de palavras. Para excluir o texto de referência das tabelas de texto de mapas, criei um estilo de caractere personalizado chamado \zrm …\zrm* com \TextProperties nonpublishable e adicionei-o ao arquivo frtbak.sty do meu projeto:

# Map Table Reference text
# Reference text in Map tables marked with \zrm ...\zrm* do not appear in the Wordlist or other checks 
\Marker zrm
\Endmarker zrm*
\Name zrm...zrm* - Remark span
\Description For Comments and remarks
\OccursUnder ip im ipi imi ipq imq ipr iq iq1 iq2 iq3 io io1 io2 io3 io4 ms ms1 ms2 s s1 s2 s3 s4 cd sp d lh li li1 li2 li3 li4 lf lim lim1 lim2 lim3 lim4 ili ili1 ili2 ili3 ili4 m mi nb p pc ph phi pi pi1 pi2 pi3 pr pmo pm pmc pmr po q q1 q2 q3 q4 qc qr qd qm qm1 qm2 qm3 cls tr th1 th2 th3 th4 thr1 thr2 thr3 thr4 tc1 tc2 tc3 tc4 tcr1 tcr2 tcr3 tcr4 f fe ef rem NEST
\TextType Other
\TextProperties nonpublishable 
\StyleType Character
\FontSize 12
\Color 16711680 # Same color as \rem

Este é um exemplo de como é usado no livro BAK de um projeto

\periph Map 02_03 The World of the Patriarchs

\tr \thc1 \zrm The world of the Patriarchs \zrm* \thc2 পিতৃপুৰুষদেৰ জগৎ
\tr \th1 \zrm Legend \zrm* \th2 ~
\tr \tc1 \zrm km\zrm* \tc2 কিমি
\tr \tc1 \zrm Journeys of Abraham\zrm* \tc2 অব্ৰাহামেৰ যাত্ৰা

As palavras na primeira coluna são excluídas da Lista de Palavras, mas as palavras na segunda coluna são verificadas quanto à ortografia.

Deixe-me acrescentar que não recomendo excluir da Lista de Palavras qualquer palavra que será publicada. Nomes e palavras na declaração de direitos autorais também devem ser verificados quanto à ortografia.

Tradução automática de English
por (1,8k pontos)
reexibida

Tendo em mente as ressalvas que @CrazyRocky menciona, eu também uso bastante o marcador não publicável pelos exatos motivos listados aqui.

Uma desvantagem é que o PT também ignora caracteres não publicáveis ao realizar certas buscas e ao fornecer resultados. Por exemplo, ao fazer buscas de parênteses e alguns outros controles, muitas vezes obtenho resultados estranhos, como algo que parece um conjunto de marcas de parênteses com nada dentro, mas que na verdade tem apenas caracteres não publicáveis dentro. Como resultado, eu realmente edito minha folha de estilo custom.sty de vez em quando para fazer o PT lidar com palavras estrangeiras da maneira como eu quero no momento.

Eu adiciono “nonpublishable” na folha de estilo custom.sty e, em seguida, mudo de volta para “publishable” na PrintDraft-mods.sty e/ou em qualquer folha ptxprint.sty relevante.

Tradução automática de English
+1 voto

Eu já me deparei com isso muitas vezes. Eu apoio equipes de tradução que estão se preparando para publicar, trabalhando em seus controles finais, incluindo a lista de palavras. Nosso objetivo para a lista de palavras é sempre “0 palavras desconhecidas ou incorretas no NT”, mas nossa contagem sempre inclui aquelas 100-200 palavras em francês (porque essas equipes estão na RCA, um país francófono) que elas decidiram incluir em seu texto. É irrazoável esperar que elas usem APENAS seu idioma materno, pois muitos de seus membros da comunidade falam e leem pelo menos um pouco de francês. É mais uma palavra aqui ou ali, geralmente em itálico: É assim que você escreve “X palavra francesa” em nosso idioma.

Portanto, quero fazer uma sugestão para os desenvolvedores: Poderíamos criar uma maneira de excluir palavras estrangeiras da lista de palavras, ou fornecer uma maneira de removê-las da contagem de “palavras desconhecidas”? Tenho duas ideias de como isso poderia ser feito.

  1. Adicionar uma quarta caixa de seleção opcional na lista de palavras? Ou seja, interrogação azul, marca de verificação verde, X vermelho e… digamos, estrela laranja? (Ou algum quarto ícone + cor diferente que signifique “palavra estrangeira”?) O problema é que a validação global que ocorre na lista de palavras não é apropriada para “palavras estrangeiras”, pois cada caso da palavra estrangeira precisa ser revisado e validado separadamente. Então, acho que esta quarta caixa significaria “esta palavra não é ortografia do idioma materno, mas não é ‘desconhecida’, pode ser ignorada para fins da lista de palavras, mas cada caso precisará ser revisado antes da publicação para garantir que ainda seja válido.”

  2. Outra opção seria mudar \tl ou algum outro marcador para ser um marcador de “palavra estrangeira”. Isso não mudaria nenhum formatação, apenas como o PTX o trata: “esta palavra pode ser ignorada na lista de palavras.” Diferente das ideias de “não publicável” explicadas acima, ela ainda teria que ser publicável. Isso resolveria o problema de “revisar cada caso” que mencionei acima, mas exigiria marcadores especiais para cada e todos os casos de cada palavra.

Qualquer opção provavelmente precisará de algum tipo de inventário + par de controle básico para permitir a validação, mas não tenho certeza de como isso seria feito caso a caso.

Então, o que vocês acham? Isso seria algo útil para pedir aos desenvolvedores?

Obrigado,
~anon550568

Tradução automática de English
por (114 pontos)

Haveria uma vantagem adicional para a opção 2. Em alguns casos, uma certa sequência de caracteres pode ser tanto uma palavra estrangeira (corretamente escrita) quanto uma palavra vernácula (seja corretamente ou incorretamente escrita). Pode-se querer julgar esses casos caso a caso.

Nesses casos, a solução ideal seria poder dizer ao PT para ignorar ocorrências individuais de palavras – assim como podemos negar erros individuais nos controles básicos (e o PT lembrará dessa escolha). Se isso for complexo demais de implementar, ignorar um certo marcador para a verificação ortográfica pode ser uma boa alternativa.

A propósito, quando se trata da verificação ortográfica final, eu geralmente defino um filtro incluindo todos os livros bíblicos (e possivelmente o glossário e a introdução) e excluindo o material preliminar. Mas isso não resolve o problema se o livro INT contiver tanto uma introdução vernácula quanto uma introdução em LWC.

Paulus+Kieviet

Tradução automática de English

P.S. Outro exemplo onde eu gostaria de excluir ocorrências individuais é este: em alguns livros, o Sumário de Conteúdo contém itens de 2º nível, que são rotulados com letras do alfabeto. O alfabeto vernáculo é “a e f” etc. Agora, “a” e “e” também são erros de ortografia de palavras vernáculas (deveriam ser ꞌ****a e ꞌ****e, respectivamente), então seria bom poder ignorar essas ocorrências. Eu sei, é um detalhe minúsculo, mas isso simplesmente não nos permite chegar àquela etapa muito satisfatória de zero palavras incorretas ou indecisas.

Paulus+Kieviet

Tradução automática de English

As descrições de imagens em inglês são frequentemente deixadas nas legendas das figuras ao lado das legendas vernáculas (embora não sejam mostradas na saída). Isso também seria outra seção para ignorar seletivamente.

Tradução automática de English
0 votos

Como estive trabalhando com outra equipe em sua lista de palavras hoje, pensei em outro benefício que viria dessa mudança, particularmente da ideia do marcador “ignorar esta palavra”… as palavras em francês seriam removidas da lista de palavras, para que o usuário não tivesse que constantemente pular sobre elas. Como está agora, todos os controles de ortografia – e até mesmo uma verificação manual – têm que mentalmente pular sobre qualquer palavra estrangeira, pois não há como excluí-las atualmente, muitas vezes muitas vezes em uma única sessão, porque elas estão em toda parte! Removê-las nos pouparia a todos muito retrabalho mental.

Tradução automática de English
por (114 pontos)

\tl … \tl* seria um bom candidato para palavras a serem ignoradas. Por padrão, ele coloca as palavras em itálico, mas alguém poderia sobrescrever isso.

Paulus+Kieviet

Tradução automática de English
0 votos

Não sei. O marcador \tl já tem um uso particular, na verdade marcando palavras estrangeiras no texto, então eles podem ter que criar um novo especificamente para isso que não faça a mudança de formatação, apenas a função de “ignorar na lista de palavras”… embora não seria uma má ideia TAMBÉM tirar as palavras \tl da lista de palavras.

Tradução automática de English
por (114 pontos)
reexibida
0 votos

Só para o caso de alguém estar planejando usar nonpublishable … Seja avisado que a segunda parte do comentário de mnjames acima é realmente importante (coloque-os como publicáveis em uma folha de estilo local): nonpublishable é usado pelo PTXprint para dizer ‘isto é um comentário, não coloque nada na página aqui’. Ou seja, será silenciosamente ignorado.

O Paratext na verdade já tem \tl com um \TextProperties de nonvernacular, ou seja, ele deveria ser tratado de forma diferente de outras palavras.

Com a tradução em que temos trabalhado, temos bastante palavras do idioma nacional como sinônimos / traduções em nosso glossário e notas de rodapé. Por estarem no idioma nacional, elas quebram todo tipo de regras para o vernáculo, mas são erros de digitação/typos comuns quando as pessoas estão cansadas. Seria muito bom poder excluir essas do inventário de caracteres, etc.

Eu sugeriria que o texto em qualquer estilo ‘nonvernacular’ seja:

  1. Buscável
  2. Totalmente ignorado para inventários de caracteres e pontuação (a menos que alguém queira implementar um segundo conjunto de inventários não vernáculos).
  3. Ter uma entrada distinta e separada na lista de hifenização, para que possam ser hifenizadas e verificadas ortograficamente de forma diferente. (Ou seja, uma ortografia OK em contextos nonvernacular não deve afetar contextos não vernáculos, e vice-versa).
Tradução automática de English

por (294 pontos)

Para os projetos com os quais trabalho, eu definitivamente quero que as palavras não vernáculas sejam publicadas, então eu não seguiria o caminho de usar qualquer marcador não publicável. Eu só quero uma maneira de excluir essas palavras da lista de palavras… ou, como você sugeriu, anon542642, uma maneira de movê-las para uma interface separada.

Como tenho discutido com Matthew_Lee, estamos nos perguntando se poderia ser um clique com o botão direito ou outra ação opcional, como quando negamos erros nos controles básicos. Assim, nós “negaríamos” uma palavra e, em seguida, poderíamos escolher um filtro para e revisar “todas as palavras negadas”.

Tradução automática de English

0 votos

Em vez de “ignorar” ou “negar” uma palavra estrangeira, faria mais sentido para mim marcar uma palavra estrangeira (corretamente escrita) como tal. Clique com o botão direito > Marcar como palavra estrangeira corretamente escrita (ou outra opção). Então o Paratext seria capaz de reconhecer (em outros contextos) que esta palavra É correta, mas não pertence ao contexto da lista de palavras vernáculas. E ela poderia ser exibida em uma lista diferente, ou em uma sublista, ou ter um filtro para mostrar TODAS as palavras, apenas palavras vernáculas, ou apenas palavras estrangeiras.

Tradução automática de English

por [Moderator]
(2,1k pontos)

Perguntas relacionadas

0 votos
1 resposta 299 visualizações
Estou ciente do tópico Excluir palavras estrangeiras da lista de palavras e vejo que a resposta planejada para isso é ... ) são erros de ortografia que os tradutores podem cometer.
anon542642 294 perguntada Mar 16, 2023
+1 voto
1 resposta 198 visualizações
Dear All, I would like to how can I mark and display the scriptural text with a certain color or ... International Certified) ACC Coach(International Coach Federation) GMT+8.00
anon221954 128 perguntada Dez 17, 2019
0 votos
3 respostas 557 visualizações
Em Notas, como faço para pesquisar todas as notas que não contêm uma certa palavra (neste caso, UNS )? Experimentei ... com regex na caixa de pesquisa, mas não consegui resolver.
skim1124 219 perguntada Jul 6, 2022
0 votos
2 respostas 396 visualizações
Here's your chance to shape how the wordlist tool works. Consider the following . . . In Paratext, WordList has ... wordlist. Screenshot_2020-03-05-11-01-37800 1280 139 KB
[Moderator]
anon089134
239
perguntada Mar 5, 2020
0 votos
4 respostas 529 visualizações
Ao exportar uma parte dos Evangelhos do Paratext para PDF, as palavras de Jesus em vermelho não aparecem no arquivo. Funciona ao exportar para RTF, mas não para PDF.
ace541611 123 perguntada Jul 7, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
All the believers were one in heart and mind. No one claimed that any of their possessions was their own, but they shared everything they had.
Acts 4:32
3,048 perguntas
6,007 respostas
5,672 comentários
2,027 usuários



