+3 votes
672 vues

J'ai un certain nombre de mots étrangers dans ma liste des mots (Wordlist) de Paratext qui proviennent de la page de garde (par exemple « Illustrations », « permission » ou les noms d'artistes) ou de la section comprise entre \tl…\tl*.
Y a-t-il un moyen d'exclure ces mots afin qu'ils n'apparaissent pas dans la liste des mots, ou de les marquer d'une manière ou d'une autre comme n'appartenant pas à la langue ?
Merci !

Traduit automatiquement depuis English
Paratext par (245 points) | 672 vues

8 Réponses

0 votes
Meilleure réponse

Cette question nous préoccupe depuis longtemps (je pense que je le dis souvent sur ce forum) et elle concerne l’approbation non seulement des mots, mais aussi des caractères et de la ponctuation.

Comme vous l’avez tous remarqué, la liste des mots (Wordlist) et les inventaires permettent actuellement aux équipes d’approuver les mots « partout » ou « nulle part », mais les choses sont rarement aussi simples. La solution que nous avons prévue affiche le statut des mots (ou des caractères) dans les passages bibliques et non bibliques dans des colonnes distinctes de la liste des mots et des inventaires.

La spécification de l’approbation selon l’emplacement sera disponible pour ceux qui le souhaitent. Elle ne sera pas obligatoire pour ceux qui n’en ont pas besoin.

Les premiers signes de ces changements peuvent être observés dans Find dans PT9.2. Cela permet aux utilisateurs de rechercher dans « Verse text » ou « All text » (le « non-verse text » arrivant « bientôt »™️). De plus, la liste des mots n’a plus trois boutons dans chaque ligne pour définir l’approbation des mots. Au lieu de cela, le statut est défini dans l’en-tête de la colonne selon la ligne active. C’est parce que lorsque nous ajoutons une colonne pour le texte non verset (et dans les projets de Bible d’étude, une autre colonne s’affiche pour le matériel de la Bible d’étude), le « mur » de 6 à 9 boutons par ligne devient un peu écrasant. Une maquette de l’inventaire des caractères ci-dessous donne une bonne idée de l’aspect que cela aurait dans la liste des mots. Par défaut, l’approbation d’un mot dans le texte verset l’approuve également dans le texte non verset ; l’approbation d’un mot dans le texte non verset n’approuve pas ce mot dans le texte verset.
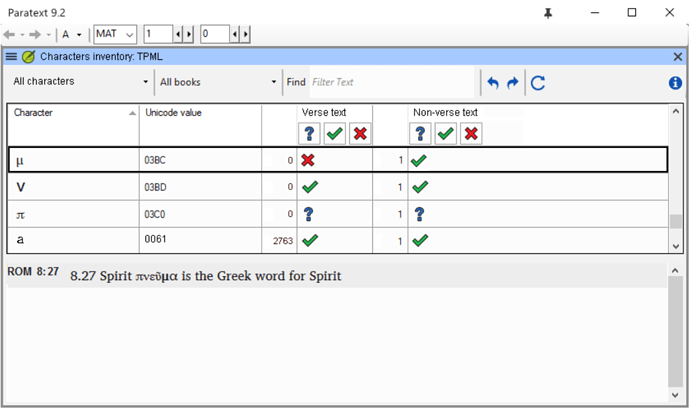
Nous n’avions pas pensé qu’il y aurait besoin d’une liste de césures séparée. C’est quelque chose à garder à l’esprit.

Vous vous demandez probablement quand cela sera mis en œuvre. Cela pourrait être inclus dans la version 9.4 (sans garantie).

Traduit automatiquement depuis English

par [Moderator]
(1,2k points)
0 votes

Il n'existe actuellement aucun moyen d'exclure ces mots de la liste des mots. La liste des mots n'est pas simplement une liste de mots de la langue, mais une liste des mots qui apparaissent dans le texte du projet. Il est important de vérifier tous ces mots, car il est possible de mal orthographier des mots étrangers.

Traduit automatiquement depuis English

par (9,9k points)
+1 vote

Paratext exclut en fait les mots nonpubliables de la liste des mots. Par exemple, les mots dans les remarques ne sont pas trouvés dans la liste des mots. Afin d'exclure le texte de référence des tableaux de texte des cartes, j'ai créé un style de caractère personnalisé appelé \zrm …\zrm* avec \TextProperties nonpublishable et je l'ai ajouté au fichier frtbak.sty de mon projet :

# Map Table Reference text
# Reference text in Map tables marked with \zrm ...\zrm* do not appear in the Wordlist or other checks 
\Marker zrm
\Endmarker zrm*
\Name zrm...zrm* - Remark span
\Description For Comments and remarks
\OccursUnder ip im ipi imi ipq imq ipr iq iq1 iq2 iq3 io io1 io2 io3 io4 ms ms1 ms2 s s1 s2 s3 s4 cd sp d lh li li1 li2 li3 li4 lf lim lim1 lim2 lim3 lim4 ili ili1 ili2 ili3 ili4 m mi nb p pc ph phi pi pi1 pi2 pi3 pr pmo pm pmc pmr po q q1 q2 q3 q4 qc qr qd qm qm1 qm2 qm3 cls tr th1 th2 th3 th4 thr1 thr2 thr3 thr4 tc1 tc2 tc3 tc4 tcr1 tcr2 tcr3 tcr4 f fe ef rem NEST
\TextType Other
\TextProperties nonpublishable 
\StyleType Character
\FontSize 12
\Color 16711680 # Same color as \rem

Voici un exemple de la façon dont cela est utilisé dans le livre BAK d'un projet

\periph Map 02_03 The World of the Patriarchs

\tr \thc1 \zrm The world of the Patriarchs \zrm* \thc2 পিতৃপুরুষদের জগৎ
\tr \th1 \zrm Legend \zrm* \th2 ~
\tr \tc1 \zrm km\zrm* \tc2 কিমি
\tr \tc1 \zrm Journeys of Abraham\zrm* \tc2 অব্রাহামের যাত্রা

Les mots de la première colonne sont exclus de la liste des mots, mais les mots de la deuxième colonne sont vérifiés par le correcteur orthographique.

Je tiens à ajouter que je ne recommande pas d'exclure de la liste des mots des mots qui seront publiés. Les noms et les mots de la déclaration de droits d'auteur doivent également être vérifiés pour l'orthographe.

Traduit automatiquement depuis English

par (1,8k points)
réaffiché

En gardant à l'esprit les mises en garde formulées par @CrazyRocky, j'utilise également assez souvent le marqueur nonpublishable pour les raisons exactes énumérées ici.

Un inconvénient est que PT ignore également les caractères nonpublishables lors de certaines recherches et de la fourniture de résultats. Par exemple, lors de la recherche de parenthèses et de certaines autres vérifications, j'obtiens souvent des résultats étranges, comme quelque chose qui ressemble à un ensemble de marques de parenthèses avec rien à l'intérieur, mais qui ne contient en fait que des caractères nonpublishables. En conséquence, je modifie en fait ma feuille de style custom.sty de temps en temps pour que PT traite les mots étrangers comme je le souhaite à un moment donné.

J'ajoute « nonpublishable » dans la feuille de style custom.sty, puis je le change en « publishable » dans PrintDraft-mods.sty et/ou dans les feuilles ptxprint.sty pertinentes.

Traduit automatiquement depuis English

+1 vote

J'ai rencontré ce problème à maintes reprises. J'assiste des équipes de traduction qui se préparent à publier en passant en revue leurs vérifications finales, y compris la liste des mots. Notre objectif pour la liste des mots est toujours « 0 mots inconnus ou incorrects dans le NT », mais notre comptage inclut toujours ces 100 à 200 mots français (parce que ces équipes sont en RCA, un pays francophone) qu'elles ont décidé d'inclure dans leur texte. Il est irrationnel de s'attendre à ce qu'elles n'utilisent QUE leur langue maternelle, car de nombreux membres de leur communauté parlent et lisent au moins un peu le français. C'est généralement un mot ici ou là, souvent en italique : Voici comment on écrit « X mot français » dans notre langue.

Je souhaite donc faire une suggestion aux développeurs : pourrions-nous créer un moyen d'exclure les mots étrangers de la liste des mots, ou fournir un moyen de les retirer du comptage des « mots inconnus » ? J'ai deux idées sur la façon dont cela pourrait être fait.

  1. Ajouter une quatrième case à cocher facultative dans la liste des mots ? c'est-à-dire point d'interrogation bleu, coche verte, croix rouge, et… disons, étoile orange ? (Ou une quatrième icône + une couleur différente qui signifie « mot étranger » ?) Le problème est que la validation globale qui se produit dans la liste des mots n'est pas appropriée pour les « mots étrangers », car chaque occurrence du mot étranger doit être examinée et validée séparément. Je suppose donc que cette quatrième case signifierait « ce mot n'est pas de l'orthographe de la langue maternelle, mais n'est pas « inconnu », il peut être ignoré aux fins de la liste des mots, mais chaque occurrence devra être examinée avant la publication pour s'assurer qu'il est toujours valide. »

  2. Une autre option serait de modifier \tl ou un autre marqueur pour en faire un marqueur de « mot étranger ». Cela ne modifierait aucun formatage, seulement la façon dont PTX le traite : « ce mot peut être ignoré dans la liste des mots. » Contrairement aux idées « nonpublishable » expliquées ci-dessus, il devrait toujours être publiable. Cela résoudrait le problème de « l'examen de chaque occurrence » que j'ai mentionné ci-dessus, mais nécessiterait des marqueurs spéciaux pour chaque occurrence de chaque mot.

Chaque option nécessitera probablement une sorte de paire inventaire + vérification de base pour permettre la validation, mais je ne suis pas sûr de la façon dont cela se ferait au cas par cas.

Que pensez-vous tous ? Serait-ce une demande utile à faire aux développeurs ?

Merci,
~anon550568

Traduit automatiquement depuis English
par (114 points)

Il y aurait un avantage supplémentaire à l'option 2. Dans certains cas, une certaine chaîne de caractères peut être à la fois un mot étranger (correctement orthographié) et un mot vernaculaire (correctement ou incorrectement orthographié). On pourrait vouloir juger ces cas au cas par cas.

Dans de tels cas, la solution idéale serait de pouvoir dire à PT d'ignorer des occurrences individuelles de mots – tout comme nous pouvons refuser des erreurs individuelles dans les vérifications de base (et PT se souviendra de ce choix). Si cela est trop complexe à mettre en œuvre, ignorer un certain marqueur pour la vérification orthographique pourrait être une bonne alternative.

Au fait, lorsqu'il s'agit de la vérification orthographique finale, je définis généralement un filtre incluant tous les livres bibliques (et éventuellement le glossaire et l'introduction) et excluant le matériel préliminaire. Mais cela ne résout pas le problème si le livre INT contient à la fois une introduction en langue vernaculaire et une introduction en langue de travail (LWC).

Paulus+Kieviet

Traduit automatiquement depuis English

P.-S. Un autre exemple où j'aimerais exclure des occurrences individuelles est le suivant : dans quelques livres, le Plan de contenu contient des éléments de niveau 2, qui sont étiquetés avec des lettres de l'alphabet. L'alphabet vernaculaire est « a e f » etc. Or « a » et « e » sont également des fautes d'orthographe de mots vernaculaires (devraient être ꞌ****a et ꞌ****e, respectivement), il serait donc agréable de pouvoir ignorer ces occurrences. Je sais, c'est un détail minuscule, mais cela ne nous permet tout simplement pas d'atteindre ce stade très satisfaisant de zéro mots incorrects ou indécis.

Paulus+Kieviet

Traduit automatiquement depuis English

Les descriptions d'images en anglais sont souvent laissées dans les légendes des figures aux côtés des légendes vernaculaires (bien qu'elles ne soient pas affichées dans la sortie). Ce serait une autre section à ignorer sélectivement.

Traduit automatiquement depuis English

0 votes

En travaillant avec une autre équipe sur sa liste des mots aujourd'hui, j'ai pensé à un autre avantage qui résulterait de ce changement, en particulier de l'idée du marqueur « ignorer ce mot »… les mots français seraient retirés de la liste des mots, de sorte que l'utilisateur n'aurait pas constamment à les sauter. En l'état actuel des choses, toutes les vérifications d'orthographe – et même une vérification manuelle – doivent mentalement sauter tous les mots étrangers, car il n'y a actuellement aucun moyen de les exclure, souvent plusieurs fois dans une seule session parce qu'ils sont partout ! Les supprimer nous ferait économiser beaucoup de travail mental à tous.

Traduit automatiquement depuis English

par (114 points)

\tl … \tl* serait un bon candidat pour les mots à ignorer. Par défaut, il met les mots en italique, mais on pourrait outrepasser cela.

Paulus+Kieviet

Traduit automatiquement depuis English
0 votes

Je ne sais pas. Le marqueur \tl a déjà un usage particulier, à savoir marquer les mots étrangers dans le texte, donc ils devront peut-être en créer un nouveau spécifiquement pour cela qui ne fait pas de changement de formatage, seulement la fonctionnalité « ignorer dans la liste des mots »… bien que ce ne serait pas une mauvaise idée de retirer AUSSI les mots \tl de la liste des mots.

Traduit automatiquement depuis English
par (114 points)
réaffiché
0 votes

Au cas où quelqu'un prévoit d'utiliser nonpublishable … Soyez averti que la deuxième partie du commentaire de mnjames ci-dessus est vraiment importante (les mettre en publishable dans une feuille de style locale) : nonpublishable est utilisé par PTXprint pour dire « ceci est un commentaire, ne mettez rien sur la page ici ». C'est-à-dire qu'il sera silencieusement ignoré.

Paratext a en fait déjà \tl avec un \TextProperties de nonvernacular, c'est-à-dire qu'il devrait être traité différemment des autres mots.

Avec la traduction sur laquelle nous travaillons, nous avons assez de mots de la langue nationale comme synonymes / traductions dans notre glossaire et nos notes de bas de page. Étant dans la langue nationale, ils enfreignent toutes sortes de règles pour la langue vernaculaire, mais sont des fautes d'orthographe / coquilles courantes lorsque les gens sont fatigués. Il serait très bon de pouvoir les exclure des inventaires de caractères, etc.

Je suggère que le texte dans tout style « nonvernacular » soit :

  1. Recherchable
  2. Totalement ignoré pour les inventaires de caractères et de ponctuation (à moins que quelqu'un ne veuille mettre en œuvre un deuxième ensemble d'inventaires non vernaculaires).
  3. Avoir une entrée distincte et séparée dans la liste de césure, afin qu'ils puissent être césurés et vérifiés orthographiquement différemment. (c'est-à-dire qu'une orthographe correcte dans les contextes nonvernaculaires ne devrait pas affecter les contextes non vernaculaires, et vice-versa).
Traduit automatiquement depuis English
par (294 points)

Pour les projets avec lesquels je travaille, je veux définitivement que les mots non vernaculaires soient publiés, donc je ne suivrais pas la voie de l'utilisation de marqueurs non publiales. Je veux juste un moyen d'exclure ces mots de la liste des mots… ou comme vous l'avez suggéré, anon542642, un moyen de les déplacer vers une interface séparée.

Comme je l'ai discuté avec Matthew_Lee, nous nous demandons si cela pourrait être un clic droit ou une autre action facultative, comme lorsque nous refusons des erreurs dans les vérifications de base. Nous « refuserions » ainsi un mot, puis pourrions choisir un filtre pour et examiner « tous les mots refusés ».

Traduit automatiquement depuis English
0 votes

Au lieu d'« ignorer » ou de « refuser » un mot étranger, il me semblerait plus logique de marquer un mot étranger (correctement orthographié) comme tel. Clic droit > Marquer comme mot étranger correctement orthographié (ou autre option). Paratext serait alors en mesure de reconnaître (dans d'autres contextes) que ce mot EST correct, mais qu'il n'appartient pas au contexte de la liste des mots vernaculaires. Et il pourrait être affiché dans une liste différente, ou une sous-liste, ou avoir un filtre pour afficher TOUS les mots, seulement les mots vernaculaires, ou seulement les mots étrangers.

Traduit automatiquement depuis English
par [Moderator]
(2,1k points)

Questions connexes

0 votes
1 réponse 299 vues
Je suis au courant du sujet Exclure les mots étrangers de la liste des mots, et je vois que la réponse ... sont des fautes d'orthographe que les traducteurs pourraient commettre.
anon542642 294 posée mars 16, 2023
+1 vote
1 réponse 198 vues
Dear All, I would like to how can I mark and display the scriptural text with a certain color or ... International Certified) ACC Coach(International Coach Federation) GMT+8.00
anon221954 128 posée déc. 17, 2019
0 votes
3 réponses 557 vues
Dans Notes, comment puis-je rechercher toutes les notes qui ne contiennent pas un mot particulier (dans ce cas UNS ... de recherche, mais je n'arrive pas à trouver la solution.
skim1124 219 posée juil. 6, 2022
0 votes
2 réponses 396 vues
Here's your chance to shape how the wordlist tool works. Consider the following . . . In Paratext, WordList has ... wordlist. Screenshot_2020-03-05-11-01-37800 1280 139 KB
[Moderator]
anon089134
239
posée mars 5, 2020
0 votes
4 réponses 529 vues
Lors de l'exportation d'une partie des Évangiles depuis Paratext vers PDF, les paroles de Jésus en rouge n'apparaissent pas ... lors de l'exportation vers RTF, mais pas avec PDF.
ace541611 123 posée juil. 7, 2021
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Finally, all of you, be like-minded, be sympathetic, love one another, be compassionate and humble.
1 Peter 3:8
3,048 questions
6,007 réponses
5,672 commentaires
2,027 utilisateurs