Mengingat tim-tim mulai menggunakan Glyssen untuk memproses awal teks PB mereka guna mengidentifikasi setiap pembicara dalam teks untuk rekaman dramatisasi, saya bertanya-tanya apakah akan berguna untuk memanfaatkan pekerjaan tersebut untuk secara OTOMATIS menandai Kata-kata Yesus \wj … \wj* dalam proyek Paratext.
Glyssen menghasilkan file Excel dengan data yang diperlukan, yang terlihat seperti ini:
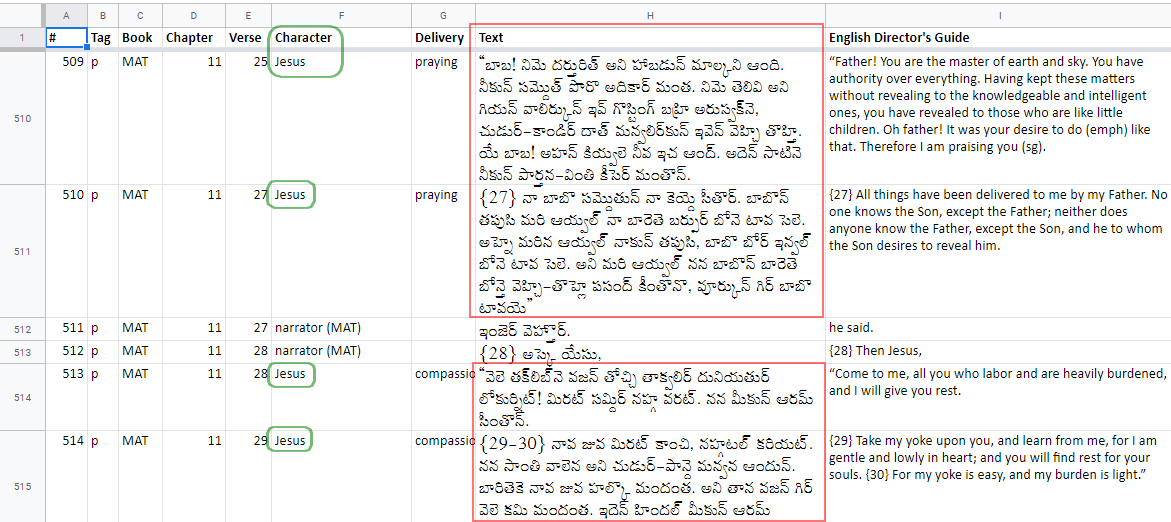
image.png1171×522 59.8 KB
Jadi, seharusnya relatif mudah untuk membuat skrip untuk menemukan tempat-tempat ini dalam teks dan membungkusnya dengan markup \wj … …\wj*
Saya mencoba sesuatu yang sederhana sendiri dengan beberapa tabel CC yang dihasilkan, dan berhasil menandai 88% dari 1901 kemunculan kata-kata Yesus secara sukses. Namun, ini masih menyisakan 200+ tempat di mana saya perlu masuk dan memperbaikinya secara manual. Karena tidak puas dengan hasil ini, dan ingin menghemat waktu orang lain di masa depan dengan membuatnya otomatis, lengkap, dan lebih tahan kesalahan, saya mempertimbangkan untuk membuat Custom Script (dalam Python) yang dapat melakukan tugas ini langsung dari dalam Paratext.
Sebagian besar kasus “gagal” dengan metode CC adalah karena markup lain seperti \w angel|angels\w* atau \f catatan kaki dan \x silang-referensi yang tertanam di dalam teks yang dicari. Saya punya beberapa ide tentang cara menghindari hal tersebut menggunakan Regular Expressions (dan mencari awal dan akhir string alih-alih seluruh string, dll.) tetapi itu melampaui CC dan akan memerlukan beberapa kode Python untuk membuatnya mungkin.
TETAPI, sebelum saya mencoba membuat Custom Script untuk melakukan ini, saya bertanya-tanya apakah ada orang lain yang sudah melakukan sesuatu yang serupa. Saya tidak ingin mengulang penemuan roda! Melihat skrip sampel yang disertakan dengan Paratext, hal terdekat yang saya lihat adalah TransferParallelPassageRefs.py oleh DRM.
Apakah ada orang lain yang memiliki sesuatu yang serupa, atau apakah ada orang lain yang lebih berbakat dalam pemrograman Python dengan ScriptureObjects yang bisa merangkum ini lebih baik daripada yang pernah bisa saya lakukan? Saya bersedia menulis pseudo code jika itu membantu. Dan saya bersedia belajar dan bekerja dengan orang lain tentang ini…
Given that teams are starting to use Glyssen to pre-process their NT texts to identify each speaker in the text for a dramatized recording, I wondered whether it would be worth piggy-backing on that work to AUTOMATICALLY mark up the Words of Jesus \wj … \wj* in the Paratext project.
Glyssen produces an Excel file with the needed data in it, which looks like this:
image.png1171×522 59.8 KB
So it should be relatively easy to generate a script to find these places in the text and wrap them with the \wj … markup …\wj*
I tried something simple myself with a couple of generated CC tables, and managed to get 88% of the 1901 occurrences of the words of Jesus marked up successfully. However, this still leaves 200+ places where I would need to go in and fix it manually. Being unsatisfied with this result, and wanting to save others time in the future by making it automated, complete and more foolproof, I wondered about creating a Custom Script (in Python) that could do this task directly from within Paratext.
Most of the “failed” cases with the CC method are because of other markup like \w angel|angels\w* or \f footnotes and \x cross-references being embedded within the text being searched for. I’ve got some ideas about how to get around those using Regular Expressions (and searching for the start and end of strings rather than the whole string, etc.) but that is beyond CC and would need to use some Python code to make it possible.
BUT, before I attempt to make a Custom Script to do this, I’m wondering if anyone else has done something similar already. I don’t want to re-invent the wheel! Looking at the sample scripts shipped with Paratext, the closest thing I see is TransferParallelPassageRefs.py by DRM.
Does anyone else have something similar, or is anyone else more gifted at Python programming with ScriptureObjects who could pull this together better than I ever could? I’m willing to write the pseudo code if that’s helpful. And I’m willing to learn and work with someone else on this…








