Какой лучший способ переводить глаголы в глагольные фразы? В языке Mato (исходный язык) есть harungia «говорить против», который переводится как pasila suki mana «говорить спотыкаться о» в языке Uma (целевой язык). Исходный глагол может иметь как подлежащее, так и дополнение. Глагольная фраза в целевом языке требует префикса подлежащего (на глаголе, который является первым словом во фразе), но не допускает суффикса дополнения: da-harungia-di «3p.S-говорить против-3p.O / они говорят о них» > di-pasila suki mana «3p.S-говорить спотыкаться о». Я могу удалить дополнение с помощью правила. Но для синтеза целевого слова мне нужно сделать следующее в целевом лексиконе: 1. Определить шаблон для глагольных фраз, 2. Заполнить слот подлежащего префиксами подлежащего, а затем 3. Переопределить глоссы для глосс глагольных фраз на что-то вроде 3p.S2, что затем заставит меня писать правило для обработки всех альтернативных глосс (3p.S>3p.S2 и т. д.) для синтеза внутри целевой базы данных. На шаге 3 это стало действительно громоздким, и я wondering, есть ли более простое решение?
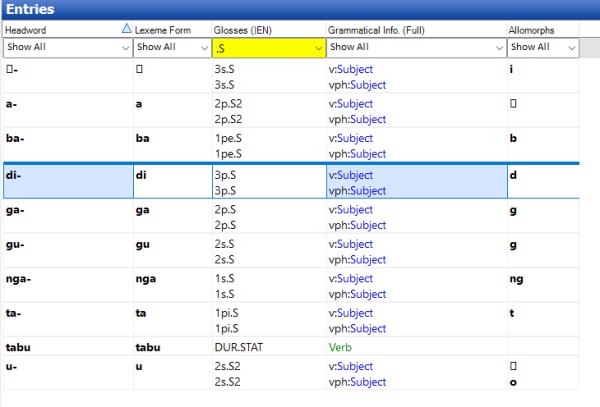
What's the best way to handle verb to verb phrase translations? In Mato (source lg) we have harungia 'speak against' which is rendered as pasila suki mana 'speak slip about' in Uma (target lg). The source verb can take both a subject and an object. The target language verb phrase requires a subject prefix (on the verb which is the first word in the phrase), but will not tolerate an object suffix: da-harungia-di '3p.S-speak against-3p.O / they speak them against' > di-pasila suki mana '3p.S-speak slip about'. I can strip the object with a rule. But to synthesize the target word means that I need to do the following in the target lexicon: 1. Define a template for verb phrases, 2. Populate the subject slot with the subject prefixes, then 3. Redefine the glosses for the verb phrase glosses to something like 3p.S2, which would then send me back to writing a rule to handle all the alternate glosses (3p.S>3p.S2, etc) for synthesizing within the target database. It was at point 3 that this became really cumbersome, and I'm wondering if there's an easier solution?
Переведено машиной с языка English








