0 票
844 次瀏覽

你好,我使用的是最新版本的 Paratext、WIN10 和 PTXPrint。Satere (SAT) 語言使用鼻化元音。我安裝了一個特殊字體來轉換為鼻化元音。直撇號 (') 用於表示喉塞音。當我使用 PTXPrint 列印《創世記》或《出埃及記》時,PDF 文件中的所有這些字符都正常顯示。但是,《利未記》在 PDF 中將撇號顯示為方塊(即無法識別的字符?)。《民數記》、《申命記》和《馬太福音》中的元音也顯示為方塊?配置沒有幫助嗎?如果有人能幫我糾正這個行為,我將非常感激!另外,我剛嘗試將 PDF 轉換為 Word 文件 (DOCX),以便用適當的字符替換方塊,但在出現方塊的地方,轉換後句子的一半突然消失了?我剛檢查了字符和標點符號清單,發現有一些問題,但我嘗試使用 PTXPrint 列印時出現的無法識別字符的問題仍然存在?

機器翻譯自 English
Paratext 由 (116 點) 提出
已重新顯示 | 844 次瀏覽

5 個回答

0 票
最佳回答

你好 anon165192。
如果佈局已經定義為 NFC,那麼從 XeTeX 消息中我能想到的唯一可能性是你在 Paratext 和 PTXprint 中沒有使用相同的字體。

從 XeTeX 消息來看,你似乎想使用字體“MarkTNR Satere”。是否有可能你在 Paratext 中使用了另一種字體?
你可以檢查兩個程序中是否配置了相同的字體。

如果不是,請嘗試在 PTXprint 中前往此選項。選項卡“Fonts + Sripts”,並將這 4 個字段更改為你的字體(Regular, Bold, Italic, Bold Italic)。然後嘗試生成你的 PDF。

Saludos,
anon689242.

機器翻譯自 English
由 (973 點) 提出
已重新顯示

你好 anon689242,

感謝你的幫助!我確實嘗試過,但 Paratext 和 PTXprint 都配置為使用 MarkNTR Satere 字體!
在大量查找和提問之後,我終於找到了一個臨時解決方案。自動鍵盤切換
不知何故在 Paratext 中被禁用了。因此,《創世記》和《出埃及記》列印正常,但其他書包含的字符
anon421222 屬於我使用的字體(即錯誤的鍵盤 = 錯誤的輸入字體)!在啟用鍵盤切換後,我必須手動
查找並替換每個字符,現在這些書列印出來完全沒問題!

然而,這只是臨時解決方案。有些人建議可以配置 Paratext,這樣我就不再
需要使用特殊字體?但到目前為止沒有人解釋過如何實現這一點?我檢查了 Convert Project 和
Project Properties 對話框。Convert Project 對話框沒有組合字符 (NFC) 的選項,但 Project Properties
對話框已經配置為 Unicode 和組合字符 (NFC)。因此,我認為項目已經配置好了?
但我如何配置 Paratext 以能夠使用任何字體,同時仍能輸入鼻化元音、鼻化 y 和代表喉塞音的直
撇號?

感謝你的幫助!

anon165192

機器翻譯自 English
0 票

聽起來你的項目可能存在混合編碼,即項目的部分內容使用了不同的代碼點。你可能需要有人與你一起工作來解決這個問題。

你提到了一個“特殊”字體。這個詞讓我很擔心。我假設這意味著它是自定義編碼的,只能與該字體一起使用。如果項目尚未轉換,你應該找人幫助你將整個項目完全轉換為 Unicode。這樣你就不需要特殊字體了,可以使用幾乎任何常見的拉丁字體。

機器翻譯自 English
由 (329 點) 提出

你好 Lorna,感謝你的回覆。我剛添加了一些我在 Paratext 中嘗試過但無效的內容。我不確定我是否理解你關於混合編碼和代碼點的觀點——你能詳細解釋一下嗎?恐怕我 anon421222 沒有人可以陪我,因為我是一名獨立譯者。如果你能指點我找一個能幫助我的人,我將非常感激。諷刺的是,我為《利未記》使用的配置與我為《創世記》和《出埃及記》使用的配置相同。因此,很難理解 Paratext 或 PTXPrint 是如何以不同方式解釋《利未記》、《民數記》、《申命記》和《馬太福音》的?這個“特殊字體”是幾年前由新部落(New Tribes)印刷店專家創建的,所以我 anon421222 認為那裡沒有任何問題。它在 Word 或 Paratext 中運行良好,除了鼻化 y,我在 Paratext 中無法使其正常工作?此外,使用直撇號 (') 來表示喉塞音有時會導致該詞被解釋為兩個單獨的詞(即換行)?然而,這個相同的字體已用於《創世記》和《出埃及記》,它們列印出來完全沒問題?如果有人能幫助我解決你提到的將整個項目轉換為 Unicode(如果尚未轉換)的問題,我將非常感激!我 anon421222 知道該怎麼做,但我會研究一下,看看我是否能理解該怎麼做。暫時謝謝!願上帝祝福你!

機器翻譯自 English

可能有用的內容:
如何使我的 Paratext 項目數據保持一致?

對於新項目:

為了避免由項目數據中混合使用組合字符和分解字符引起的問題,當你在 Paratext 8.0(及更高版本)中創建新項目時,項目屬性對話框的“高級”選項卡上有一個“正規化”下拉菜單。

默認的正規化是組合字符 (NFC)。這意味著當 Paratext 保存項目時,它會將所有項目數據轉換為組合字符。
如果你希望 Paratext 在保存項目時將所有項目數據轉換為分解字符,請在創建項目時選擇分解字符 (NFD)。

如果你希望允許 Paratext 將項目數據存儲為組合字符和分解字符的混合,請在創建項目時選擇關閉(無正規化)。
我們不建議選擇“關閉(無正規化)”,除非項目語言的正字法以非標準方式使用變音符號,且變音符號出現的順序很重要。

對於現有項目:

如果你的項目數據混合了組合字符和分解字符(可能是由於使用了不同的鍵盤佈局),請執行以下操作以強制所有數據保持一致。

  1. 點擊你的項目選項卡,使其成為活動選項卡。
  2. 點擊項目中的選項卡菜單圖標,然後從 Project 菜單中,指向 Project settings,並選擇 Project properties。
  3. 在 Advanced 選項卡上,在正規化下拉列表中選擇以下其中一項。
  • Composed characters (NFC)(用於將數據保存為組合字符)。
  • Decomposed characters (NFD)(用於將數據保存為分解字符)。
  1. 點擊 OK。
    Paratext 會將項目中的所有數據更改為你選擇的正規化選項。
    一旦混合了組合字符和分解字符的項目數據保持一致,請讓所有團隊成員 Send/Receive 該項目。

如果你希望允許 Paratext 將項目數據存儲為組合字符和分解字符的混合,請從正規化下拉列表中選擇 Off (no normalization)。
我們不建議選擇“Off (no normalization)”,除非項目語言的正字法以非標準方式使用變音符號,且變音符號出現的順序很重要。

機器翻譯自 English

你好 anon421222,

感謝您提供這些資訊!就我所知,我的專案已經設定為 Unicode 和
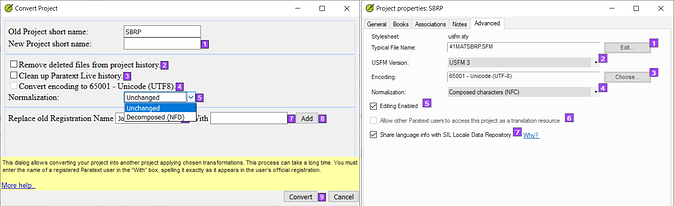
組合字元(Composed Characters)(請參閱下方的截圖)!左邊是「轉換專案」(Convert Project)對話方塊,其中並未
顯示「組合字元」的選項。但右邊的「專案屬性」(Project Properties)似乎顯示該
專案已設定為 Unicode(即顯示 Unicode 且按鈕為停用狀態)以及組合字元?
PTXPrint 的某人建議我查看 XeTeX 日誌的結尾,按照他們的建議,我發現了
以下內容:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

Satere-Mawe(SAT)語言使用鼻化元音、鼻化 y 以及直撇號(straight apostrophe)來表示喉塞音。
MarkTNR Satere 是我使用的字型,但缺失字元的 Unicode 編號與我使用的字型中的同一字元
不同(即 > 符號之後的編號)。

因此,當我使用 PTXPrint 列印時出現的矩形未識別字元符號,就是上述的
缺失字元。不知為何,Paratext 中的輸入似乎沒有使用 MarkTNR Satere 字型,儘管這
正是專案中設定的字型?

有幾個人建議,專案可以透過某種方式進行轉換,這樣我 anon421222 就不需要使用特殊
字型了。但沒有人實際解釋過如何做到這一點?我願意付出努力,但我 anon421222 不知道該做什麼!我
曾嘗試研究專案轉換,但它顯然已經設定為 Unicode 和組合字元?

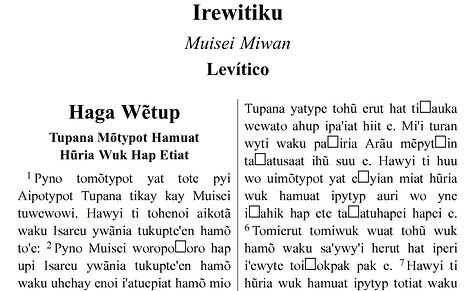
以下是我使用 PTXPrint 列印為 PDF 時出現的錯誤截圖。利未記中缺失的字元似乎是
喉塞音,但在其他書卷中,則是鼻化元音未被識別?
非常感謝您的幫助!願上帝祝福您!

anon165192

機器翻譯自 English
0 票

根據你上面的說法,你的 MarkNTR Satere 字體不符合 Unicode 標準。它將 y diaeresis 等字符替換為 y tilde,這些需要修復。我相信簡單的查找/替換例程就可以解決。
查找 U+0027 替換為 U+A78C
查找 U+00FF > U+1EF9
查找 U+00E6 > U+1EBD
查找 U+00F0 > U+0129

不過,你可能還有其他被篡改的代碼點。你需要對正字法中的每個鼻化元音和其他任何特殊字符執行此操作。然後你應該能夠切換為使用 Charis SIL,但你也需要切換鍵盤。如果你有鍵盤的源文件,我可以幫助你將其更改為輸出符合 Unicode 標準的字符。

機器翻譯自 English
由 (329 點) 提出

嗨 Lorna,我不確定我說了什麼會讓人覺得字體不符合 Unicode 標準?自動鍵盤切換不知為何被禁用了,這意味著輸入時使用的是普通字體,而不是我通常使用的字體。當我啟用鍵盤切換後,我就能手動執行「尋找並取代」字元了。另外,我不確定您建議的「使用 Unicode 數字進行尋找並取代」該在哪裡操作?我恐怕 anon421222 不知道如何以那種方式使用 Unicode 數字?不過,我可以把字體寄給您,讓您可以查看。
fontsetc_.zip (99.9 KB)

機器翻譯自 English
+1 票

感謝提供字型!這很有幫助。您擁有的字型是我們有時所稱的修改過(hacked)字型或「自訂編碼」字型。在 Unicode 普及之前,我們經常這樣做,因為那是我們取得所需字元的唯一方式。因此,雖然對您來說感覺像是 Unicode,但其中一些字元是根據實際的 Unicode 重新定義的。所以,您的字型很可能是世界上唯一具有此對應關係的字型。如果您失去了資料與此字型之間的關聯,沒有人會知道這些字元應該是什麼(因此會顯示為方框)

例如,Unicode 字元 ÿ(U+00FF)被重新定義為帶有波浪號的 y。在 Unicode 編號中,那應該是 ỹ(U+1EF9)。

此時,您可能不想要經歷將資料轉換為 Unicode 的過程。但是,如果您願意這樣做,且有人能協助您,我願意建立一個對應檔案,將您的自訂碼位對應到正確的 Unicode 碼位。我可以根據我在字型中看到的情況來完成這件事。

您需要同時進行資料轉換和鍵盤更新。

為了長期的資料穩定性,您真的應該轉換為 Unicode,但我 anon421222’t 知道您目前處於翻譯過程中的哪個階段。

機器翻譯自 English
由 (329 點) 提出

嗨 Lorna,

您和我達成了相同的結論。我也認為這是修改過字體(hacked font)的結果。我會透過電子郵件與您聯繫,並 anon165192 在列表外討論我們能做什麼。

james_post

機器翻譯自 English
0 票

您可以在 Paratext 說明主題中找到更多詳細資訊:

我的專案文本使用「自訂」字體。我該如何將其轉換為 Unicode?

關於該項目,Lorna 提出願意提供一個對應檔(.map),可用於轉換。您需要一個修訂後的鍵盤,以輸出 Unicode 字元(或者您可以找到一個能產生您所需字元的鍵盤並使用它)。在切換到 Unicode 之後,您將可以從大量字體中選擇,所以這不應該成為問題(除了您一直使用的那個自訂字體可能無法使用)。

機器翻譯自 English
由 (296 點) 提出

嗨 anon806807,謝謝您!是的,Lorna 和 james_post 都在與我聯繫,Lorna 正在處理 .map 檔。轉換為 Unicode 後,我 anon421222 認為我不再需要我目前使用的字體了。

機器翻譯自 English

相關問題

0 票
0 個回答 54 次瀏覽
我認為空白與隱藏字元(WHC)選項將對我們的專案產生重大影響 它帶來了一些實際的好處,但如果用於格式設定目的,也有被濫用的風險 我們需要仔細思考,以確保能妥善使用此功能 [已編輯] 請參閱 John Wickberg 在相關貼文中提供的 ... 時,自動將它們轉換為 u00A0 可能也是個好主意 我期待聽到其他人的評論和觀察,也許還能收到開發人員的回覆
Kent Spielmann 1.8k 提出 已提問 11月 19, 2024
0 票
2 個回答 508 次瀏覽
我的文字中有像 3 000 000 這樣的數字。 字元清單檢查顯示一個錯誤:「initial zero non valid.」(開頭零無效)。但開頭的零在清單中或其他地方都沒有顯示出來,所以我無法將其標記為有效, 我該如何處理這個問題?
anon057624 136 提出 已提問 9月 6, 2021
0 票
6 個回答 614 次瀏覽
我試圖將專案(Manya - mzj)中的分解字元(decomposed characters)變更為組合格式(composed characters) 但當我嘗試在「專案屬性」(Project Properties)部分套用此選項時,系統不讓我點選 ... 1162 24.9 KB Shot12292 1062 171 KB 有什麼想法可以解決這些問題嗎?
anon055151 176 提出 已提問 3月 22, 2021
0 票
1 個回答 398 次瀏覽
我建立了一個新的轉寫專案,並試圖套用一些一致的變更,以補充透過 TecKit 映射已實現的一對一轉寫 主要專案是 RTL(從右到左),而轉寫是 LTR(從左到右) 在這個專案中(但在其他任 ... 清單(Character Inventory)和標點符號清單(Punctuation Inventory),但看不出導致此行為的原因 我卡住了 有什麼建議嗎?
DVM 175 提出 已提問 10月 20, 2020
0 票
2 個回答 489 次瀏覽
一位方言譯者希望在詩篇 119 的每一節開頭顯示一個希伯來字母。他們所使用的語言字型不包含希伯來字母。在方言文本中,是否有辦法針對像標題這樣的單字使用希伯來字型? 例如:他們希望第一個節標題為: א Alep John
anon084052 157 提出 已提問 5月 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Accept the one whose faith is weak, without quarreling over disputable matters.
Romans 14:1
3,052 個問題
6,011 個回答
5,677 則評論
2,032 位使用者






