0 票
843 次浏览

你好,我正在使用最新版本的 Paratext、WIN10 和 PTXPrint。Satere (SAT) 语言使用鼻化元音。我安装了一种特殊字体来转换为鼻化元音。直撇号 (') 用于表示喉塞音。当我使用 PTXPrint 打印《创世记》或《出埃及记》时,PDF 文档中所有这些字符都正常显示。但是,《利未记》在 PDF 中将撇号显示为方块(即无法识别的字符?)。《民数记》、《申命记》和《马太福音》中的元音显示为方块?配置没有帮助吗?如果有人能帮我纠正这种行为,我将不胜感激!另外,我刚刚尝试将 PDF 转换为 Word 文档 (DOCX),以便用适当的字符替换方块,但在方块出现的地方,转换时句子的一半突然消失了?我刚刚检查了字符和标点符号清单,发现了一些问题,但我尝试使用 PTXPrint 打印时无法识别字符的问题仍然存在?

机器翻译自 English
Paratext 中 由 (116 分) 发布
已重新显示 | 843 次浏览

5 个回答

0 票
最佳答案

你好 anon165192。
如果布局已经定义为 NFC,那么从 XeTeX 消息来看,我能想到的唯一原因是你在 Paratext 和 PTXprint 中没有使用相同的字体。

从 XeTeX 消息来看,你似乎想使用字体“MarkTNR Satere”。是否有可能你在 Paratext 中使用了另一种字体?
你可以检查两个程序中是否配置了相同的字体。

如果没有,请尝试在 PTXprint 中转到此选项。选项卡“Fonts + Sripts”,并将这 4 个字段更改为你的字体(Regular, Bold, Italic, Bold Italic)。然后尝试生成你的 PDF。

Saludos,
anon689242.

机器翻译自 English
由 (973 分) 发布
已重新显示

你好 anon689242,

感谢你的帮助!我确实尝试过,但 Paratext 和 PTXprint 都配置为使用 MarkNTR Satere 字体!
在四处查看并询问问题后,我终于找到了一个临时解决方案。Paratext 中的自动键盘切换
不知何故被禁用了。因此,《创世记》和《出埃及记》打印正常,但其他书包含的字符
anon421222’t 属于我使用的字体(即错误的键盘 = 错误的输入字体)!在启用键盘切换后,我必须手动
查找并替换每个字符,现在这些书打印正常!

然而,这只是一个临时解决方案。有些人建议可以配置 Paratext,这样我就不再
需要使用特殊字体?但到目前为止没有人解释如何实现这一点?我检查了 Convert Project 和
Project Properties 对话框。Convert Project 对话框没有组合字符 (NFC) 的选项,但 Project Properties
对话框已经配置为 Unicode 和组合字符 (NFC)。因此,我认为项目已经配置好了?
但我如何配置 Paratext 以能够使用任何字体,同时仍能输入鼻化元音、鼻化 y 和代表喉塞音的直
撇号?

感谢你的帮助!

anon165192

机器翻译自 English
0 票

听起来你的项目可能存在混合编码,其中项目的不同部分使用了不同的码点。你可能需要有人和你一起坐下来解决这个问题。

你提到了一种“特殊”字体。这个词让我感到担忧。我假设这意味着它是自定义编码的,并且只能与该字体一起使用。如果项目尚未完全转换为 Unicode,你应该找人帮助你将整个项目完全转换为 Unicode。这样你就不需要特殊字体了,可以使用几乎任何常见的拉丁字体。

机器翻译自 English
由 (329 分) 发布

你好 Lorna,感谢你的回复。我只是添加了一些我在 Paratext 中尝试过但没有帮助的事情。我不确定我是否理解你关于混合编码和码点的观点 - 你能解释得更详细一些吗?恐怕我 anon421222’t 有人可以和我坐在一起,因为我是独立翻译人员。如果你能指引我去找能帮助的人,我将不胜感激。讽刺的是,我在《利未记》中使用的配置与我在《创世记》和《出埃及记》中使用的配置相同。因此,很难理解 Paratext 或 PTXPrint 是如何以不同的方式解释《利未记》、《民数记》、《申命记》和《马太福音》的?这种“特殊字体”是多年前由新部落印刷店专家创建的,所以我 anon421222’t 认为那里有任何问题。它在 Word 或 Paratext 中运行得很好,除了鼻化 y,我在 Paratext 中无法使其工作?另外,使用直撇号 (') 来表示喉塞音有时会导致单词被解释为两个独立的单词(即断词)?然而,这种相同的字体已用于《创世记》和《出埃及记》,它们打印出来非常好?我将非常感激有人帮助我了解你提到的将整个项目转换为 Unicode(如果尚未转换)!我 anon421222’t 知道该怎么做,但我会研究一下,看看我是否能理解该怎么做。暂时谢谢!上帝保佑!

机器翻译自 English

可能有用的内容:
如何使我的 Paratext 项目数据保持一致?

对于新项目:

为了避免由项目数据中混合使用组合字符和分解字符引起的问题,当你在 Paratext 8.0(及更高版本)中创建新项目时,项目属性对话框的“高级”选项卡上有一个“规范化”下拉菜单。

默认规范化是组合字符 (NFC)。这意味着当 Paratext 保存项目时,它会将所有项目数据转换为组合字符。
如果你更喜欢让 Paratext 在保存项目时将所有项目数据转换为分解字符,请在创建项目时选择分解字符 (NFD)。

如果你更喜欢允许 Paratext 以组合字符和分解字符的混合形式存储项目数据,请在创建项目时选择关闭(无规范化)。
除非项目语言的拼写规则以非标准方式使用变音符号,并且变音符号出现的顺序很重要,否则我们不建议选择“关闭(无规范化)”。

对于现有项目:

如果你的项目数据中混合了组合字符和分解字符(可能是由于使用了不同的键盘布局),请执行以下操作以强制所有数据保持一致。

  1. 点击你的项目选项卡,使其成为活动选项卡。
  2. 点击你项目中的选项卡菜单图标,然后从 Project 菜单中,指向 Project settings,并选择 Project properties。
  3. 在 Advanced 选项卡上,在规范化下拉列表中选择以下其中一项。
  • Composed characters (NFC)(用于将数据保存为组合字符)。
  • Decomposed characters (NFD)(用于将数据保存为分解字符)。
  1. 点击 OK。
    Paratext 会将你项目中的所有数据更改为你选择的规范化选项。
    一旦混合了组合字符和分解字符的项目数据变得一致,请让所有团队成员 Send/Receive 该项目。

如果你更喜欢允许 Paratext 以组合字符和分解字符的混合形式存储项目数据,请从规范化下拉列表中选择 Off (no normalization)。
除非项目语言的拼写规则以非标准方式使用变音符号,并且变音符号出现的顺序很重要,否则我们不建议选择“Off (no normalization)”。

机器翻译自 English

Hi anon421222,

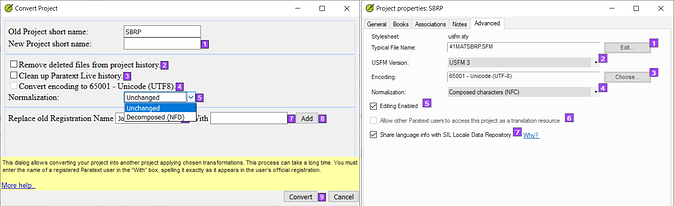
Thank you for that information! As far as I can tell my project is already configured as unicode and
Composed Characters (see screenshot below)! On the left is the Convert Project dialog which doesn’t
show the option for Composed Characters. But on the right the Project Properties appear to show that
the project is configured as unicode (i.e. unicode appears and button is disabled) and Composed Characters?
Someone from PTXPrint told me to look at the end of the XeTeX Log and as per their suggestion I found the
following:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

The Satere-Mawe (SAT) language uses nasalized vowels, nasalized y and the straight apostrophe for the glottal.
MarkTNR Satere is the font I use, but the missing character’s unicode number is different from the same character
in the font I use (i.e. after the > symbol).

Therefore, the retangular unrecognized character symbols which appear when I print using PTXPrint are the missing
characters above. Somehow the input in Paratext appears not to be using the MarkTNR Satere font although this is
the font which is configured in the project?

A couple of people have suggested that the project can be converted in some way so that I anon421222’t need to use a special
font. But no one has actually explained how to achieve this? I’m willing to do the work, but I anon421222’t know what to do! I
have tried looking into converting the project, but it apparently is already configured for unicode and Composed Characters?

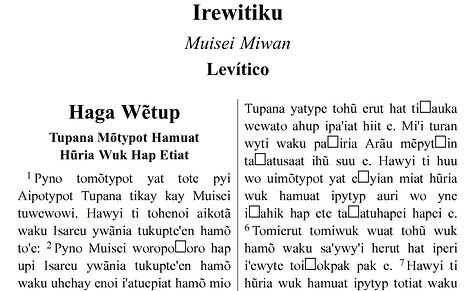
Below is a screenshot of the error I get when using PTXPrint to print to PDF. The missing characters in Leviticus appear to be
the glottal, but in other books it is the nasalized vowels which are not being recognized?
Your help is greatly appreciated! God bless!

anon165192

0 票

根据你上面所说的,你的 MarkNTR Satere 字体不符合 Unicode 标准。它用 y tilde 替换了 y diaeresis 等字符,这些需要修复。我相信一个简单的查找/替换例程就可以解决。
查找 U+0027 替换为 U+A78C
查找 U+00FF > U+1EF9
查找 U+00E6 > U+1EBD
查找 U+00F0 > U+0129

不过你可能还有其他被篡改的码点。你需要对拼写规则中的每个鼻化元音和其他任何特殊字符执行此操作。然后你应该能够切换到使用 Charis SIL,但你也需要切换键盘。如果你有键盘的源文件,我可以帮你将其更改为输出符合 Unicode 标准的字符。

机器翻译自 English
由 (329 分) 发布

你好 Lorna,我不确定我说了什么让你觉得字体不符合 Unicode 标准?自动键盘切换不知怎么被禁用了,这意味着输入时使用的是普通字体,而不是我通常使用的字体。当我启用键盘切换后,我就可以手动查找和替换字符了。另外,我不确定在哪里可以使用 Unicode 数字进行查找和替换,就像你建议的那样?恐怕我 anon421222 不知道如何以那种方式使用 Unicode 数字?不过,我可以把字体发给你看看。
fontsetc_.zip (99.9 KB)

机器翻译自 English
+1 票

谢谢提供字体!这很有帮助。你拥有的是我们有时所说的被修改过的(hacked)字体或“自定义编码”字体。在 Unicode 普及之前,我们经常这样做,因为那是我们获取所需字符的唯一方法。因此,虽然对你来说感觉像是 Unicode,但其中一些字符是从实际的 Unicode 重新定义的。所以,你的字体可能是世界上唯一具有这种映射关系的字体。如果你失去了数据与该字体的关联,没有人会知道这些字符应该是什么(因此会出现方框)。

例如,Unicode 字符 ÿ (U+00FF) 被重新定义为带波浪号的 y。在 Unicode 数字中,那应该是 ỹ (U+1EF9)。

此时,你可能不想经历将数据转换为 Unicode 的过程。但如果你愿意这样做,并且有人能帮助你,我愿意创建一个映射文件,将你的自定义码点映射到正确的 Unicode 码点。我可以根据我在字体中看到的内容来完成这项工作。

你需要同时进行数据转换和键盘更新。

为了长期的数据稳定性,你真的应该转换为 Unicode,但我 anon421222 不知道你在翻译过程中处于哪个阶段。

机器翻译自 English
由 (329 分) 发布

你好 Lorna,

你和我得出了相同的结论。我也认为这是被修改过的字体(hacked font)造成的结果。我会给你发电子邮件,并在 anon165192 列表外看看我们能做什么。

james_post

机器翻译自 English
0 票

你可以在 Paratext 帮助主题中找到更多详细信息

我的项目文本使用“自定义”字体。我如何将其转换为 Unicode?

参考该条目,Lorna 提议提供一个映射(.map)文件,可用于转换。你需要一个修订版的键盘,以输出 Unicode 字符(或者你可以找到一个能生成所需字符的键盘并使用它)。切换到 Unicode 后,你可以选择大量字体,所以这不应该是个问题(除了你一直在使用的自定义字体可能无法工作)。

机器翻译自 English
由 (296 分) 发布

嘿 anon806807,谢谢!是的,Lorna 和 james_post 都在与我联系,Lorna 正在制作 .map 文件。转换为 Unicode 后,我 anon421222 认为我不再需要我一直在使用的字体了。

机器翻译自 English

相关问题

0 票
0 个回答 54 次浏览
在我看来, 空白和隐藏字符 (WHC)选项将对我们的项目产生重大影响 它带来了一些切实的好处,但如果用于格式设置目的,也有被滥用的风险 我们需要仔细思考,以确保正确使用它 [已编辑] 参见 John Wickberg 在相关帖子中的回答 ... 时,自动将它们转换为 u00A0 可能是一个好主意 我期待听到其他人的评论和观察,也许还能得到开发人员的回复
Kent Spielmann 1.8k 发布 提问于 十一月 19, 2024
0 票
2 个回答 508 次浏览
我的文本中有类似 3 000 000 的数字。 字符清单检查显示一个错误:“initial zero non valid.”(初始零无效)。但初始零并没有显示在清单中或其他任何地方,因此我无法将其标记为有效, 我该如何解决这个问题?
anon057624 136 发布 提问于 九月 6, 2021
0 票
6 个回答 614 次浏览
我试图将我的项目(Manya - mzj)中的分解字符更改为组合字符 但是当我尝试在 项目属性 (Project Properties)部分应用此选项时,系统不允许我选择 确定 (Okay) Shot51194 1246 32.6 ... 1162 24.9 KB Shot12292 1062 171 KB 关于如何解决这些问题,大家有什么想法吗?
anon055151 176 发布 提问于 三月 22, 2021
0 票
1 个回答 398 次浏览
我创建了一个新的转写项目,并试图应用一些一致的更改,以补充通过 TecKit 映射已经实现的一对一转写 主项目是从右向左(RTL)书写的,而转写文本是从左向右(LTR)书写的 在这个项目中(但在 ... Inventory)和标点符号清单(Punctuation Inventory),但看不出导致这种行为的原因 我对此感到困惑 有什么建议吗?
DVM 175 发布 提问于 十月 20, 2020
0 票
2 个回答 489 次浏览
一位方言翻译者希望在诗篇 119 每一节的开头显示一个希伯来字母。他们所使用的语言字体不包含希伯来字母。有没有办法在方言文本中,像标题那样,对单个字符使用希伯来字体? 例如:他们希望第一节的标题为: א Alep John
anon084052 157 发布 提问于 五月 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
And over all these virtues put on love, which binds them all together in perfect unity.
Colossians 3:14
3,052 个问题
6,011 个回答
5,677 条评论
2,032 位用户





