0 голосов
842 просмотров

Здравствуйте, я использую последнюю версию Paratext, WIN10, PTXPrint. В языке сатере (SAT) используются носовые гласные. У меня установлена специальная шрифтовая программа для преобразования в носовые гласные. Прямой апостроф (') используется для обозначения глоттального смычка. Когда я печатаю Бытие или Исход с помощью PTXPrint, все эти символы отображаются нормально в PDF-документе. Но в книге Левит апостроф отображается как квадрат (т.е. нераспознанный символ?) в PDF? В книгах Числа, Второзакония и Матфея гласные отображаются как квадраты? Настройки не помогают? Буду благодарен, если кто-нибудь поможет мне исправить это поведение! Также я только что попробовал преобразовать PDF в документ Word (DOCX), чтобы заменить квадраты на соответствующие символы, но там, где появляются квадраты, при преобразовании внезапно исчезает половина предложения? Только что проверил инвентарь символов и знаков препинания, где есть несколько проблем, но проблема с нераспознанными символами при попытке печати с помощью PTXPrint сохраняется?

Переведено машиной с языка English
Paratext от (116 очков)
снова показан | 842 просмотров

5 Ответов

0 голосов
Лучший ответ

Здравствуйте, anon165192.
Если макет уже определен как NFC, то единственное, что я могу придумать из сообщения XeTeX, это то, что вы не используете один и тот же шрифт в Paratext и PTXprint.

Из сообщения XeTeX кажется, что вы хотите использовать шрифт «MarkTNR Satere». Возможно, вы используете другой шрифт в Paratext?
Вы можете проверить, настроен ли у вас один и тот же шрифт в обеих программах.

Если нет, попробуйте перейти к этому параметру в PTXprint. Вкладка «Шрифты + Скрипты» и измените эти 4 поля на ваш шрифт (Regular, Bold, Italic, Bold Italic). Затем попробуйте сгенерировать ваш PDF.

С наилучшими пожеланиями,
anon689242.

Переведено машиной с языка English
от (973 очков)
снова показан

Здравствуйте, anon689242,

Спасибо за вашу помощь! Я пробовал это, но и Paratext, и PTXprint настроены на использование шрифта MarkNTR Satere!
После долгих поисков и вопросов я наконец нашел временное решение. Автоматическое переключение клавиатуры
по какой-то причине было отключено в Paratext. Так что Бытие и Исход печатаются нормально, но в других книгах содержались символы, которые
не принадлежали шрифту, который я использую (т.е. неправильная клавиатура = неправильный шрифт ввода)! После включения переключения клавиатуры мне пришлось вручную
найти и заменить каждый символ, и теперь книги печатаются без проблем!

Однако это только временное решение. Некоторые люди предложили, что Paratext можно настроить так, чтобы мне больше не нужно было использовать специальный
шрифт? Но пока никто не объяснил, как это сделать? Я проверил диалоговые окна «Преобразовать проект» и
«Свойства проекта». В диалоговом окне «Преобразовать проект» нет варианта «Составные символы (NFC)», но в диалоговом окне «Свойства проекта»
уже настроено Unicode и Составные символы (NFC). Следовательно, я считаю, что проект уже настроен?
Но как мне настроить Paratext, чтобы я мог использовать любой шрифт и при этом вводить носовые гласные, носовое y и прямой
апостроф, который обозначает глоттальный смычок?

Буду благодарен за вашу помощь!

anon165192

Переведено машиной с языка English
0 голосов

Мне кажется, у вас может быть смешанная кодировка, где разные части проекта используют разные кодовые точки. Возможно, вам понадобится кто-то, кто сядет рядом с вами и поможет разобраться.

Вы упоминаете «специальный» шрифт. Это слово меня пугает. Я предполагаю, что это означает, что он имеет собственную кодировку и будет работать только с этим шрифтом. Вам следует попросить кого-нибудь помочь вам полностью преобразовать весь ваш проект в Unicode, если он еще не в Unicode. Тогда вам не понадобится специальный шрифт, вы сможете использовать практически любой обычный латинский шрифт.

Переведено машиной с языка English
от (329 очков)

Здравствуйте, Lorna, спасибо за ваш ответ. Я только что добавил несколько вещей, которые я пробую в Paratext, но они не помогли. Не уверен, что понимаю вашу точку зрения о смешанной кодировке и кодовых точках - могли бы вы объяснить подробнее? Боюсь, у меня не будет никого, кто мог бы сидеть рядом со мной, так как я независимый переводчик. Если вы могли бы направить меня к кому-то, кто может помочь, я буду очень благодарен. Ирония в том, что я использую ту же конфигурацию для Левита, что и для Бытия и Исхода. Отсюда и сложность в понимании того, как Paratext или PTXPrint работают, чтобы интерпретировать Левит, Числа, Второзаконие и Матфея по-разному? «Специальный шрифт» был создан специалистом типографии New Tribes много лет назад, поэтому я не вижу в этом никакой проблемы. Он работает отлично в Word или Paratext, за исключением носового y, которое я не могу заставить работать в Paratext? Также использование прямого апострофа (') для обозначения глоттального смычка иногда приводит к тому, что слово интерпретируется как два отдельных слова (т.е. разрыв слова)? Однако этот же шрифт использовался для Бытия и Исхода, которые печатаются без проблем? Я буду очень благодарен за помощь в том, что вы упомянули о преобразовании всего проекта в Unicode (если он еще не в Unicode)! Я не знаю, как это сделать, но я посмотрю и постараюсь понять, как это сделать. Спасибо пока! Да благословит вас Бог!

Переведено машиной с языка English

Возможно, это будет полезно:
Как сделать данные моего проекта Paratext согласованными?

Для нового проекта:

Чтобы избежать проблем, вызванных наличием данных проекта со смесью составных и разложенных символов, при создании нового проекта в Paratext 8.0 (и более поздних версиях) на вкладке «Дополнительно» в диалоговом окне свойств проекта есть выпадающий список «Нормализация».

По умолчанию нормализация — это составные символы (NFC). Это означает, что при сохранении проекта Paratext преобразует все данные проекта в составные символы.
Если вы предпочитаете, чтобы Paratext преобразовывал все данные проекта в разложенные символы при сохранении проекта, выберите «Разложенные символы (NFD)» при создании проекта.

Если вы предпочитаете разрешить Paratext хранить данные проекта как смесь составных и разложенных символов, выберите «Выкл. (без нормализации)» при создании проекта.
Мы НЕ рекомендуем выбирать «Выкл. (без нормализации)», если только орфография языка проекта не использует диакритические знаки нестандартным образом и порядок их появления не имеет значения.

Для существующего проекта:

Если в вашем проекте есть данные со смесью составных и разложенных символов (вероятно, из-за использования разных раскладок клавиатуры), выполните следующие действия, чтобы привести все данные к согласованному виду.

  1. Щелкните вкладку вашего проекта, чтобы сделать ее активной.
  2. Щелкните значок меню вкладки в вашем проекте, затем из меню Проект наведите на Настройки проекта и выберите Свойства проекта.
  3. На вкладке Дополнительно выберите один из следующих вариантов в выпадающем списке нормализации.
  • Составные символы (NFC) (для сохранения данных в виде составных символов).
  • Разложенные символы (NFD) (для сохранения данных в виде разложенных символов).
  1. Щелкните ОК.
    Paratext изменит все данные в вашем проекте на выбранный вами вариант нормализации.
    После того как данные проекта со смесью составных и разложенных символов будут приведены к согласованному виду, все участники команды должны выполнить Send/Receive (Отправить/Получить) проекта.

Если вы предпочитаете разрешить Paratext хранить данные проекта как смесь составных и разложенных символов, выберите Выкл. (без нормализации) из выпадающего списка нормализации.
Мы НЕ рекомендуем выбирать «Выкл. (без нормализации)», если только орфография языка проекта не использует диакритические знаки нестандартным образом и порядок их появления не имеет значения.

Переведено машиной с языка English

Здравствуйте, anon421222,

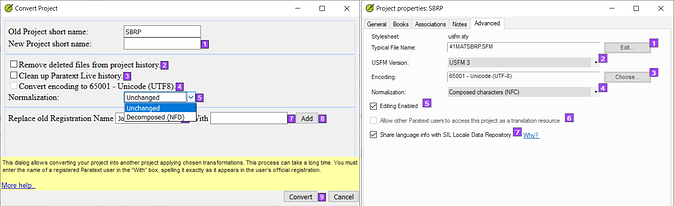
Спасибо за эту информацию! Насколько я могу судить, мой проект уже настроен как Unicode и
Составные символы (см. скриншот ниже)! Слева находится диалоговое окно «Преобразовать проект», которое не
показывает вариант «Составные символы». Но справа в «Свойствах проекта» кажется, что
проект настроен как Unicode (т.е. отображается Unicode, и кнопка неактивна) и Составные символы?
Кто-то из PTXPrint посоветовал мне посмотреть в конце журнала XeTeX, и по их предложению я нашел
следующее:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

В языке сатере-маве (SAT) используются носовые гласные, носовое y и прямой апостроф для глоттального смычка.
MarkTNR Satere — это шрифт, который я использую, но Unicode-номер отсутствующего символа отличается от того же символа
в шрифте, который я использую (т.е. после символа >).

Таким образом, прямоугольные символы нераспознанных символов, которые появляются при печати с помощью PTXPrint, — это отсутствующие
символы выше. По какой-то причине ввод в Paratext, похоже, не использует шрифт MarkTNR Satere, хотя это
шрифт, который настроен в проекте?

Несколько человек предложили, что проект можно каким-то образом преобразовать, чтобы мне не нужно было использовать специальный
шрифт. Но никто не объяснил, как это сделать? Я готов выполнить работу, но я не знаю, что делать! Я
пытался разобраться с преобразованием проекта, но, по-видимому, он уже настроен для Unicode и Составных символов?

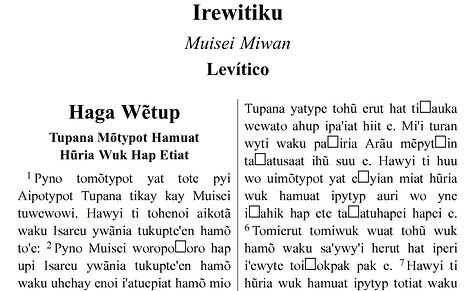
Ниже приведен скриншот ошибки, которую я получаю при использовании PTXPrint для печати в PDF. Отсутствующие символы в Левите, похоже,
это глоттальный смычок, но в других книгах это носовые гласные, которые не распознаются?
Ваша помощь очень ценна! Да благословит вас Бог!

anon165192

Переведено машиной с языка English
0 голосов

Судя по тому, что вы сказали выше, ваш шрифт MarkNTR Satere не соответствует стандарту Unicode. В нем заменены такие символы, как y с диерезисом, на y с тильде, и их нужно исправить. Я считаю, что простая процедура поиска/замены сработает.
Найти U+0027 Заменить U+A78C
Найти U+00FF > U+1EF9
Найти U+00E6 > U+1EBD
Найти U+00F0 > U+0129

У вас могут быть и другие измененные кодовые точки. Вам нужно сделать это для каждой носовой гласной и любого другого специального символа в вашей орфографии. Тогда вы сможете перейти на использование Charis SIL, но вам также нужно будет сменить клавиатуры. Если у вас есть исходный файл вашей клавиатуры, я мог бы помочь вам изменить его, чтобы он выводил символы, соответствующие стандарту Unicode.

Переведено машиной с языка English
от (329 очков)

Привет, Лорна, не уверен, что я сказал, что указывает на то, что шрифт не соответствует стандарту Unicode? Автоматическое переключение раскладки клавиатуры по какой-то причине было отключено, что означает, что для ввода использовался обычный шрифт, а не тот, которым я пользуюсь. Когда я включил переключение раскладки, я смог вручную найти и заменить символы. Также не уверен, где можно выполнить поиск и замену с использованием кодов Unicode, как вы предлагаете? Боюсь, я anon421222 не знаю, как использовать коды Unicode таким образом? Однако я могу отправить вам шрифт, чтобы вы могли его посмотреть.
fontsetc_.zip (99.9 KB)

Переведено машиной с языка English
+1 голос

Спасибо за шрифт! Это очень полезно. То, что у вас есть, то, что мы иногда называем взломанным шрифтом или шрифтом с «собственной кодировкой». Раньше мы часто так делали до появления Unicode, потому что это был единственный способ получить нужные нам символы. Так что, хотя вам может казаться, что это Unicode, некоторые символы были переопределены относительно фактического Unicode. Таким образом, ваш шрифт, вероятно, единственный в мире, в котором есть такая сопоставление. Если вы потеряете связь ваших данных с этим шрифтом, никто не будет знать, какие символы должны быть (отсюда и квадратные окошки)

Например, символ Unicode ÿ (U+00FF) был переопределен как y с тильдой. В кодах Unicode это было бы ỹ (U+1EF9).

На данный момент вы, возможно, не хотите проходить через процесс конвертации ваших данных в Unicode. Но, если вы были бы готовы это сделать и если кто-то мог бы вам помочь, я был бы готов создать файл сопоставления, который сопоставил бы ваши собственные кодовые точки с правильными кодовыми точками Unicode. Я мог бы сделать это на основе того, что я вижу в шрифте.

Вам нужно будет выполнить конвертацию данных и обновление клавиатуры одновременно.

Для долгосрочной стабильности данных вам действительно следует конвертировать в Unicode, но я anon421222 не знаю, на каком этапе перевода вы находитесь.

Переведено машиной с языка English
от (329 очков)

Привет, Лорна,

Мы с вами пришли к одному и тому же выводу. Я тоже считаю, что это результат взломанного шрифта. Я напишу вам и anon165192 вне списка рассылки, чтобы посмотреть, что мы можем сделать.

james_post

Переведено машиной с языка English
0 голосов

Больше подробностей можно найти в теме справки Paratext

Текст моего проекта использует «собственный» шрифт. Как мне конвертировать его в Unicode?

Отсылаясь на этот пункт, Лорна предлагает предоставить файл сопоставления (.map), который можно было бы использовать для конвертации. Вам понадобится исправленная раскладка клавиатуры, которая будет выводить символы Unicode (или вы можете найти раскладку, которая создает нужные вам символы, и использовать ее). После перехода на Unicode у вас будет выбор из огромного количества шрифтов, так что это не должно быть проблемой (кроме того, что собственный шрифт, которым вы пользовались, скорее всего, перестанет работать).

Переведено машиной с языка English
от (296 очков)

Привет, anon806807, спасибо за это! Да, и Лорна, и james_post общаются со мной, и Лорна работает над файлом .map. После конвертации в Unicode я anon421222 не думаю, что мне понадобится шрифт, которым я пользовался.

Переведено машиной с языка English

Похожие вопросы

0 голосов
0 ответов 54 просмотров
Мне кажется, что опция пробелы и скрытые символы (WHC) окажет значительное влияние на наши проекты. Она предоставляет ... людей, а также, возможно, получить ответ от разработчиков.
Kent Spielmann 1,8тыс. задал вопрос ноя 19, 2024
0 голосов
2 ответов 508 просмотров
У меня в тексте есть числа, например 3 000 000. Проверка инвентаризации символов показывает ошибку: initial zero ... проверить его как допустимый, как мне решить эту проблему?
anon057624 136 задал вопрос сен 6, 2021
0 голосов
6 ответов 614 просмотров
Я пытаюсь изменить разложенные символы в моем проекте (Manya - mzj) на составные символы. Но когда я пытаюсь применить этот ... Есть ли у кого-нибудь идеи, как решить эти проблемы?
anon055151 176 задал вопрос мар 22, 2021
0 голосов
1 ответ 398 просмотров
Я создал новый проект транслитерации и пытаюсь внести некоторые последовательные изменения, чтобы дополнить уже выполненную через ... Я в тупике. Есть ли какие-нибудь предложения?
DVM 175 задал вопрос окт 20, 2020
0 голосов
2 ответов 489 просмотров
Переводчик на местном языке хочет отображать ивритскую букву в начале каждого раздела Псалма 119. Шрифт, который они ... чтобы первый заголовок раздела выглядел так: א Alep Джон
anon084052 157 задал вопрос май 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
If anyone destroys God’s temple, God will destroy that person; for God’s temple is sacred, and you together are that temple.
1 Corinthians 3:17
3,052 вопросов
6,011 ответов
5,677 комментариев
2,032 пользователей





