0 votos
844 visualizações

Olá, estou usando a versão mais recente do Paratext, WIN10, PTXPrint. A língua Satere (SAT) usa vogais nasalizadas. Tenho uma fonte especial instalada para converter para vogais nasalizadas. O apóstrofo reto (') é usado para representar a glotal. Quando imprimo Gênesis ou Êxodo usando o PTXPrint, todos esses caracteres aparecem normalmente no documento PDF. Mas, Levítico mostra o apóstrofo como um quadrado (ou seja, caractere não reconhecido?) no PDF? NUM DEUT MATT mostram as vogais como quadrados? A configuração não ajuda? Agradeço se alguém puder me ajudar a corrigir esse comportamento! Além disso, acabei de tentar converter o PDF para um documento do Word (DOCX) para substituir os quadrados pelo caractere apropriado, mas onde os quadrados aparecem, metade da frase desaparece na conversão? Verifiquei os inventários de caracteres e pontuação, onde há alguns problemas, mas o problema com caracteres não reconhecidos ao tentar imprimir com o PTXPrint continua?

Tradução automática de English
Paratext por (116 pontos)
reexibida | 844 visualizações

5 Respostas

0 votos
Melhor resposta

Olá anon165192.
Se o layout já estiver definido como NFC, a única coisa que posso pensar a partir da mensagem do XeTeX é que você não está usando a mesma fonte no Paratext e no PTXprint.

Pela mensagem do XeTeX, parece que você quer usar a fonte “MarkTNR Satere”. É possível que você esteja usando outra fonte no Paratext?
Você pode verificar se tem a mesma fonte configurada em ambos os programas.

Se não, tente ir para essa opção no PTXprint. Guia “Fonts + Scripts” e altere esses 4 campos para a sua fonte (Regular, Bold, Italic, Bold Italic). Depois, tente gerar seu PDF.

Saludos,
anon689242.

Tradução automática de English
por (973 pontos)
reexibida

Olá anon689242,

Obrigado pela sua ajuda! Eu tentei isso, mas tanto o Paratext quanto o PTXprint estão configurados para usar a fonte MarkNTR Satere!
Depois de muita pesquisa e de fazer perguntas, finalmente encontrei uma solução temporária. A troca automática de teclado
de alguma forma foi desabilitada no Paratext. Então, Gênesis e Êxodo são impressos sem problemas, mas outros livros continham caracteres que
anon421222 pertencem à fonte que eu uso (ou seja, teclado errado = fonte de entrada errada)! Depois de habilitar a troca de teclado, tive que encontrar e substituir manualmente
cada caractere e agora os livros são impressos perfeitamente!

No entanto, isso é apenas uma solução temporária. Algumas pessoas sugeriram que é possível configurar o Paratext para que eu não
precise mais usar uma fonte especial? Mas até agora ninguém explicou como fazer isso? Verifiquei as caixas de diálogo Converter Projeto e
Propriedades do Projeto. A caixa de diálogo Converter Projeto não tem a opção para Caracteres Compostos (NFC), mas a caixa de diálogo Propriedades do Projeto
já está configurada para unicode e Caracteres Compostos (NFC). Portanto, acredito que o projeto já está configurado?
Mas como eu configuro o Paratext para poder usar qualquer fonte e ainda ser capaz de inserir vogais nasalizadas, y nasalizado e apóstrofo reto
que representa a glotal?

Agradeço pela sua ajuda!

anon165192

Tradução automática de English
0 votos

Parece-me que você pode ter uma codificação mista, onde partes do projeto estão usando pontos de código diferentes. Você pode precisar de alguém para sentar com você e resolver isso.

Você menciona uma fonte “especial”. Essa palavra me assusta. Suponho que isso signifique que ela é codificada de forma personalizada e funcionará apenas com essa fonte. Você deve pedir a alguém que o ajude a converter todo o seu projeto para Unicode, se ainda não estiver. Assim, você não precisará de uma fonte especial e poderá usar quase qualquer fonte latina comum.

Tradução automática de English
por (329 pontos)

Olá Lorna, obrigado pela sua resposta. Acabei de adicionar algumas coisas que estou tentando no Paratext, mas que não ajudaram. Não tenho certeza se entendo seu ponto sobre codificação mista e pontos de código - poderia explicar mais? Tenho medo de que anon421222 não tenha ninguém para sentar comigo, pois sou um tradutor independente. Se você pudesse me indicar alguém que possa ajudar, eu apreciaria muito. Ironicamente, estou usando a mesma configuração para Levítico que usei para Gênesis e Êxodo. Daí a dificuldade em entender como o Paratext ou o PTXPrint está trabalhando para interpretar Levítico, Números, Deuteronômio e Mateus de forma diferente? A “fonte especial” foi criada pelo especialista da gráfica New Tribes anos atrás, então não vejo nenhum problema nisso. Ela funciona perfeitamente bem no Word ou no Paratext, exceto pelo y nasalizado, que não consigo fazer funcionar no Paratext? Além disso, o uso do apóstrofo reto (') para representar a glotal às vezes faz com que a palavra seja interpretada como duas palavras separadas (ou seja, quebra de palavra)? No entanto, essa mesma fonte foi usada para Gênesis e Êxodo, que são impressos sem problemas? Eu apreciaria muito a ajuda de alguém sobre o que você menciona sobre converter todo o projeto para unicode (se ainda não estiver)! Não sei como fazer isso, mas vou dar uma olhada e ver se consigo entender como fazer. Obrigado por enquanto! Deus abençoe!

Tradução automática de English

De potencial utilidade:
Como faço para manter os dados do meu projeto no Paratext consistentes?

Para um novo projeto:

Para evitar problemas causados por ter dados do projeto com uma mistura de caracteres compostos e decompostos, ao criar um novo projeto no Paratext 8.0 (e posterior), há uma lista suspensa “Normalização” na guia Avançado da caixa de diálogo Propriedades do Projeto.

A Normalização padrão é Caracteres compostos (NFC). Isso significa que, quando o Paratext salva o projeto, ele converte todos os dados do projeto para caracteres compostos.
Se você preferir que o Paratext converta todos os dados do projeto para caracteres decompostos ao salvar o projeto, selecione Caracteres decompostos (NFD) ao criar o projeto.

Se você preferir permitir que o Paratext armazene os dados do projeto como uma mistura de caracteres Compostos e Decompostos, selecione Desligado (sem normalização) ao criar o projeto.
NÃO recomendamos selecionar “Desligado (sem normalização)” a menos que a ortografia da língua do projeto use diacríticos de uma forma não padrão e a ordem em que os diacríticos ocorram seja importante.

Para um projeto existente:

Se o seu projeto tiver dados com uma mistura de caracteres compostos e decompostos (provavelmente devido ao uso de diferentes layouts de teclado), faça o seguinte para forçar que todos os dados sejam consistentes.

  1. Clique na guia do seu projeto para torná-la a guia ativa.
  2. Clique no ícone do menu da guia no seu projeto, então, a partir do menu Projeto, aponte para Configurações do projeto e selecione Propriedades do projeto.
  3. Na guia Avançado, selecione uma das seguintes opções na lista suspensa de Normalização.
  • Caracteres compostos (NFC) (para que os dados sejam salvos como caracteres compostos).
  • Caracteres decompostos (NFD) (para que os dados sejam salvos como caracteres decompostos).
  1. Clique em OK.
    O Paratext altera todos os dados no seu projeto para a opção de normalização que você escolheu.
    Depois que os dados do projeto com a mistura de caracteres compostos e decompostos tiverem sido tornados consistentes, todos os membros da equipe devem Enviar/Receber (Send/Receive) o projeto.

Se você preferir permitir que o Paratext armazene os dados do projeto como uma mistura de caracteres Compostos e Decompostos, selecione Desligado (sem normalização) na lista suspensa de Normalização.
NÃO recomendamos selecionar “Desligado (sem normalização)” a menos que a ortografia da língua do projeto use diacríticos de uma forma não padrão e a ordem em que os diacríticos ocorram seja importante.

Tradução automática de English

Olá anon421222,

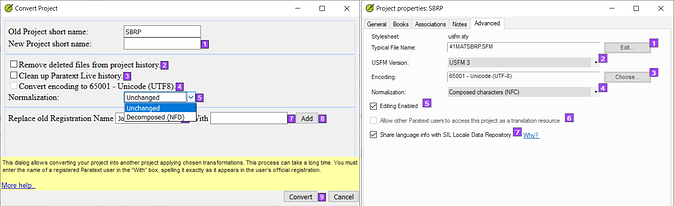
Obrigado por essas informações! Pelo que posso ver, meu projeto já está configurado como unicode e
Caracteres Compostos (veja a captura de tela abaixo)! À esquerda está a caixa de diálogo Converter Projeto, que não
mostra a opção para Caracteres Compostos. Mas, à direita, as Propriedades do Projeto parecem mostrar que
o projeto está configurado como unicode (ou seja, unicode aparece e o botão está desabilitado) e Caracteres Compostos?
Alguém do PTXPrint me disse para olhar o final do Log do XeTeX e, conforme sua sugestão, encontrei o
seguinte:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

A língua Satere-Mawe (SAT) usa vogais nasalizadas, y nasalizado e o apóstrofo reto para a glotal.
MarkTNR Satere é a fonte que eu uso, mas o número unicode do caractere em falta é diferente do mesmo caractere
na fonte que eu uso (ou seja, após o símbolo >).

Portanto, os símbolos de caracteres não reconhecidos em forma retangular que aparecem quando imprimo usando o PTXPrint são os
caracteres em falta acima. De alguma forma, a entrada no Paratext parece não estar usando a fonte MarkTNR Satere, embora esta seja
a fonte configurada no projeto?

Algumas pessoas sugeriram que o projeto pode ser convertido de alguma forma para que eu anon421222 precise usar uma fonte
especial. Mas ninguém realmente explicou como fazer isso? Estou disposto a fazer o trabalho, mas não sei o que fazer! Tentei
pesquisar sobre a conversão do projeto, mas aparentemente ele já está configurado para unicode e Caracteres Compostos?

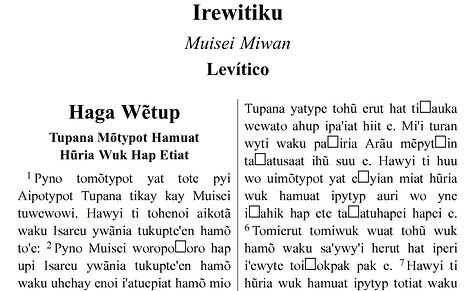
Abaixo está uma captura de tela do erro que recebo ao usar o PTXPrint para imprimir em PDF. Os caracteres em falta em Levítico parecem ser
a glotal, mas em outros livros são as vogais nasalizadas que não estão sendo reconhecidas?
Sua ajuda é muito apreciada! Deus abençoe!

anon165192

Tradução automática de English
0 votos

Pelo que você disse acima, sua fonte MarkNTR Satere não é compatível com Unicode. Ela substituiu caracteres como y com trema por y com til e esses precisam ser corrigidos. Acredito que uma rotina simples de encontrar/substituir funcionaria.
Encontrar U+0027 Substituir U+A78C
Encontrar U+00FF > U+1EF9
Encontrar U+00E6 > U+1EBD
Encontrar U+00F0 > U+0129

Você pode ter outros pontos de código adulterados. Você precisa fazer isso com cada vogal nasal e qualquer outro caractere especial na sua ortografia. Então, você deve ser capaz de mudar para usar a Charis SIL, mas você também precisará mudar os teclados. Se você tiver o arquivo de origem do seu teclado, eu poderia ajudá-lo a alterá-lo para produzir caracteres compatíveis com Unicode.

Tradução automática de English
por (329 pontos)

Olá Lorna, não tenho certeza do que eu disse que indica que a fonte não é compatível com Unicode? A troca automática de teclado foi desativada de alguma forma, o que significa que uma fonte regular estava sendo usada para a digitação em vez da fonte que eu uso. Quando eu ativei a troca de teclado, consegui localizar e substituir caracteres manualmente. Além disso, não tenho certeza de onde você pode localizar e substituir usando números Unicode, como você sugere? Tenho medo de que anon421222 não saiba como usar números Unicode dessa forma? No entanto, posso enviar a fonte para você examinar.
fontsetc_.zip (99,9 KB)

Tradução automática de English
+1 voto

Obrigado pela fonte! Isso é útil. O que você tem é o que às vezes chamamos de fonte modificada (hacked) ou fonte com “codificação personalizada”. Nós fazíamos isso muito antes do Unicode, porque era a única maneira de obter os caracteres de que precisávamos. Portanto, embora pareça Unicode para você, alguns dos caracteres foram redefinidos a partir do Unicode real. Assim, a sua é provavelmente a única fonte no mundo que tem esse mapeamento. Se você perdesse a associação dos seus dados com esta fonte, ninguém saberia o que os caracteres deveriam ser (daí as caixas quadradas)

Por exemplo, o caractere Unicode ÿ (U+00FF) foi redefinido para ser um y com til. Em números Unicode, isso seria ỹ (U+1EF9).

Neste ponto, você pode não querer passar pelo processo de converter seus dados para Unicode. Mas, se você estivesse disposto a fazer isso e se alguém pudesse ajudá-lo, eu estaria disposto a criar um arquivo de mapeamento que mapearia seus pontos de código personalizados para os pontos de código Unicode corretos. Eu poderia fazer isso com base no que vejo na fonte.

Você precisaria fazer a conversão de dados e a atualização do teclado ao mesmo tempo.

Para a estabilidade de dados a longo prazo, você realmente deveria converter para Unicode, mas eu anon421222 não sei em que processo de tradução você está.

Tradução automática de English
por (329 pontos)

Olá Lorna,

Você e eu chegamos à mesma conclusão. Eu também acredito que este é o resultado de uma fonte modificada (hacked). Enviarei um e-mail para você e anon165192 fora da lista para ver o que podemos fazer.

james_post

Tradução automática de English
0 votos

Você pode encontrar mais detalhes no tópico de Ajuda do Paratext

Meu texto do projeto usa uma fonte “personalizada”. Como faço para convertê-lo para Unicode?

Referindo-se a esse item, Lorna está oferecendo-se para fornecer um arquivo de mapeamento (.map) que pode ser usado para a conversão. Você precisará de um teclado revisado que produza caracteres Unicode (ou você pode encontrar um teclado que produza os caracteres de que precisa e usá-lo). Depois de ter passado para o Unicode, você terá a escolha de um grande número de fontes, então isso não deve ser um problema (exceto pelo fato de que a fonte personalizada que você tem usado provavelmente não funcionará).

Tradução automática de English
por (296 pontos)

Ei anon806807, obrigado por isso! Sim, tanto Lorna quanto james_post estão se comunicando comigo e Lorna está trabalhando no .map. Depois de converter para Unicode, eu anon421222 não acho que precisarei mais da fonte que tenho usado.

Tradução automática de English

Perguntas relacionadas

0 votos
0 respostas 54 visualizações
Parece-me que a opção de espaços em branco e caracteres ocultos (WHC) impactará significativamente nossos projetos. ... outros e, talvez, receber um retorno dos desenvolvedores.
Kent Spielmann 1,8k perguntada Nov 19, 2024
0 votos
2 respostas 508 visualizações
Eu tenho números como 3 000 000 no meu texto. A verificação de inventário de caracteres me mostra um erro: zero ... possa marcá-lo como válido, como devo resolver esse problema?
anon057624 136 perguntada Set 6, 2021
0 votos
6 respostas 614 visualizações
Estou tentando alterar os caracteres decompostos no meu projeto (Manya - mzj) para caracteres compostos. Mas, quando ... 171 KB Alguma ideia de como resolver esses problemas?
anon055151 176 perguntada Mar 22, 2021
0 votos
1 resposta 398 visualizações
Criei um novo projeto de transliteração e estou tentando aplicar algumas alterações consistentes para complementar a transliteração ... sem saber o que fazer. Alguma sugestão?
DVM 175 perguntada Out 20, 2020
0 votos
2 respostas 489 visualizações
Um tradutor vernáculo deseja exibir uma letra hebraica no início de cada seção do Salmo 119. A fonte que ele usa para o ... querem que o primeiro título da seção seja: א Alep John
anon084052 157 perguntada Mai 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
So Peter was kept in prison, but the church was earnestly praying to God for him.
Acts 12:5
3,052 perguntas
6,011 respostas
5,677 comentários
2,032 usuários





