0 suara
842 tampilan

Halo, saya menggunakan versi terbaru Paratext, WIN10, PTXPrint. Bahasa Satere (SAT) menggunakan vokal bersuara hidung (nasalized vowels). Saya memiliki font khusus yang terinstal untuk mengonversi ke vokal bersuara hidung. Tanda apostrof lurus (') digunakan untuk mewakili glotal. Ketika saya mencetak Kejadian atau Keluaran menggunakan PTXPrint, semua karakter ini muncul dengan normal dalam dokumen PDF. Namun, Imamat menampilkan apostrof sebagai kotak (yaitu karakter tidak dikenali?) dalam PDF? NUM DEUT MATT menampilkan vokal sebagai kotak? Konfigurasi tidak membantu? Saya akan sangat berterima kasih jika ada yang bisa membantu saya memperbaiki perilaku ini! Selain itu, saya baru saja mencoba mengonversi PDF menjadi dokumen Word (DOCX) untuk mengganti kotak-kotak tersebut dengan karakter yang tepat, tetapi di tempat kotak-kotak muncul, tiba-tiba setengah kalimat hilang dalam konversi? Saya baru saja memeriksa inventaris karakter dan tanda baca, di mana ada beberapa masalah, tetapi masalah dengan karakter tidak dikenali ketika saya mencoba mencetak dengan PTXPrint masih berlanjut?

Diterjemahkan secara otomatis dari English
Paratext oleh (116 poin)
ditampilkan kembali | 842 tampilan

5 Jawaban

0 suara
Jawaban terbaik

Halo anon165192.
Jika tata letak sudah didefinisikan sebagai NFC, maka satu-satunya hal yang bisa saya pikirkan dari pesan XeTeX adalah bahwa Anda tidak menggunakan font yang sama di Paratext dan PTXprint.

Dari pesan XeTeX, Anda tampaknya ingin menggunakan font "MarkTNR Satere". Apakah mungkin Anda menggunakan font lain di Paratext?
Anda dapat memeriksa apakah Anda memiliki font yang sama yang dikonfigurasi di kedua program.

Jika tidak, coba pergi ke opsi ini di PTXprint. Tab "Fonts + Sripts" dan ubah 4 bidang ini menjadi font Anda (Regular, Bold, Italic, Bold Italic). Lalu coba buat PDF Anda.

Saludos,
anon689242.

Diterjemahkan secara otomatis dari English
oleh (973 poin)
ditampilkan kembali

Halo anon689242,

Terima kasih atas bantuan Anda! Saya sudah mencoba itu tetapi baik Paratext maupun PTXprint dikonfigurasi untuk menggunakan font MarkNTR Satere!
Setelah banyak mencari dan bertanya, saya akhirnya menemukan solusi sementara. Pengalihan keyboard otomatis
sebagaimana caranya dinonaktifkan di Paratext. Jadi, Kejadian dan Keluaran dicetak dengan baik, tetapi buku-buku lain mengandung karakter yang
anon421222't milik font yang saya gunakan (yaitu keyboard salah = font input salah)! Setelah mengaktifkan pengalihan keyboard, saya harus secara manual
mencari dan mengganti setiap karakter dan sekarang buku-buku dicetak dengan baik!

Namun, ini hanya solusi sementara. Beberapa orang telah menyarankan bahwa Paratext dapat dikonfigurasi sehingga saya tidak
lagi perlu menggunakan font khusus? Tetapi sejauh ini tidak ada yang menjelaskan bagaimana cara mencapainya? Saya telah memeriksa dialog Convert Project dan
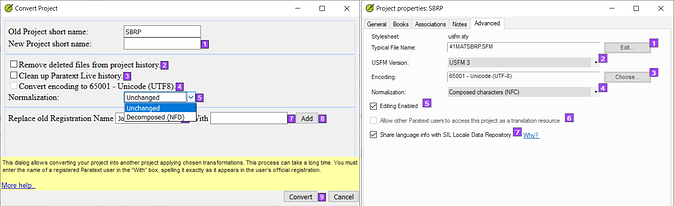
Project Properties. Dialog Convert Project tidak memiliki opsi untuk Karakter Tersusun (NFC), tetapi dialog Project Properties
sudah dikonfigurasi untuk unicode dan Karakter Tersusun (NFC). Oleh karena itu, saya percaya proyek sudah dikonfigurasi?
Tetapi bagaimana saya mengonfigurasi Paratext agar dapat menggunakan font apa pun dan masih dapat memasukkan vokal bersuara hidung, y bersuara hidung, dan apostrof lurus
yang mewakili glotal?

Saya berterima kasih atas bantuan Anda!

anon165192

Diterjemahkan secara otomatis dari English
0 suara

Bagi saya, ini terdengar seperti Anda mungkin memiliki pencampuran enkoding di mana bagian-bagian proyek menggunakan codepoint yang berbeda. Anda mungkin perlu seseorang untuk duduk bersama Anda dan merapikannya.

Anda menyebutkan font "khusus". Kata itu membuat saya khawatir. Saya asumsikan itu berarti font tersebut dikodekan secara kustom dan hanya akan berfungsi dengan font tersebut. Anda harus meminta seseorang untuk membantu Anda mengonversi seluruh proyek Anda ke Unicode jika belum dilakukan. Maka Anda tidak akan membutuhkan font khusus, Anda dapat menggunakan hampir semua font Latin umum.

Diterjemahkan secara otomatis dari English
oleh (329 poin)

Halo Lorna, terima kasih atas balasan Anda. Saya baru saja menambahkan beberapa hal yang sedang saya coba di Paratext tetapi belum membantu. Saya tidak yakin memahami poin Anda tentang pencampuran enkoding dan codepoint - bisakah Anda menjelaskan lebih lanjut? Saya takut saya anon421222't memiliki seseorang untuk duduk bersama saya karena saya adalah penerjemah independen. Jika Anda bisa menunjuk seseorang yang bisa membantu, saya akan sangat menghargainya. Ironisnya, saya menggunakan konfigurasi yang sama untuk Imamat seperti yang saya gunakan untuk Kejadian dan Keluaran. Oleh karena itu, sulit memahami bagaimana Paratext atau PTXPrint bekerja untuk menafsirkan Imamat, Bilangan, Ulangan, dan Matius secara berbeda? Font "khusus" itu dibuat oleh spesialis percetakan New Tribes bertahun-tahun lalu sehingga saya anon421222't melihat masalah di sana. Font itu berfungsi dengan baik di Word atau Paratext kecuali untuk y bersuara hidung yang tidak bisa saya buat berfungsi di Paratext? Selain itu, menggunakan tanda apostrof lurus (') untuk mewakili glotal kadang-kadang menyebabkan kata ditafsirkan sebagai dua kata terpisah (yaitu pemecahan kata)? Namun, font yang sama ini telah digunakan untuk Kejadian dan Keluaran yang dicetak dengan baik? Saya akan sangat menghargai bantuan seseorang tentang apa yang Anda sebutkan tentang mengonversi seluruh proyek ke unicode (jika belum)! Saya anon421222't tahu cara melakukannya, tetapi saya akan melihat-lihat dan melihat apakah saya bisa memahami cara melakukannya. Terima kasih untuk saat ini! Tuhan memberkati!

Diterjemahkan secara otomatis dari English

Berguna secara potensial:
Bagaimana cara membuat data proyek Paratext saya konsisten?

Untuk proyek baru:

Untuk menghindari masalah yang disebabkan oleh data proyek dengan campuran karakter tersusun (composed) dan terurai (decomposed), ketika Anda membuat proyek baru di Paratext 8.0 (dan kemudian), ada drop-down "Normalization" di tab Advanced dari dialog properti Proyek.

Normalisasi default adalah Karakter Tersusun (NFC). Ini berarti bahwa ketika Paratext menyimpan proyek, ia mengonversi semua data proyek menjadi karakter tersusun.
Jika Anda lebih suka Paratext mengonversi semua data proyek menjadi karakter terurai ketika menyimpan proyek, pilih Karakter Terurai (NFD) ketika Anda membuat proyek.

Jika Anda lebih suka mengizinkan Paratext menyimpan data proyek sebagai campuran Karakter Tersusun dan Terurai, pilih Off (no normalization) ketika Anda membuat proyek.
Kami TIDAK merekomendasikan memilih "Off (no normalization)" kecuali ortografi bahasa proyek menggunakan diakritik dengan cara non-standar dan urutan terjadinya diakritik penting.

Untuk proyek yang sudah ada:

Jika proyek Anda memiliki data dengan campuran karakter tersusun dan terurai (kemungkinan karena menggunakan tata letak keyboard yang berbeda), lakukan hal berikut untuk memaksa semua data menjadi konsisten.

  1. Klik tab proyek Anda untuk membuatnya menjadi tab aktif.
  2. Klik ikon menu tab di proyek Anda, lalu dari menu Project, arahkan ke Project settings, dan pilih Project properties.
  3. Pada tab Advanced, pilih salah satu dari berikut ini dalam daftar drop-down Normalization.
  • Composed characters (NFC) (untuk data yang disimpan sebagai karakter tersusun).
  • Decomposed characters (NFD) (untuk data yang disimpan sebagai karakter terurai).
  1. Klik OK.
    Paratext mengubah semua data di proyek Anda ke opsi normalisasi yang Anda pilih.
    Setelah data proyek dengan campuran karakter tersusun dan terurai dibuat konsisten, minta semua anggota tim untuk Send/Receive proyek tersebut.

Jika Anda lebih suka mengizinkan Paratext menyimpan data proyek sebagai campuran Karakter Tersusun dan Terurai, pilih Off (no normalization) dari daftar drop-down Normalization.
Kami TIDAK merekomendasikan memilih "Off (no normalization)" kecuali ortografi bahasa proyek menggunakan diakritik dengan cara non-standar dan urutan terjadinya diakritik penting.

Diterjemahkan secara otomatis dari English

Halo anon421222,

Terima kasih atas informasi itu! Sejauh yang bisa saya ketahui, proyek saya sudah dikonfigurasi sebagai unicode dan
Karakter Tersusun (lihat tangkapan layar di bawah)! Di sebelah kiri adalah dialog Convert Project yang tidak
menampilkan opsi untuk Karakter Tersusun. Tetapi di sebelah kanan, Project Properties tampaknya menunjukkan bahwa
proyek dikonfigurasi sebagai unicode (yaitu unicode muncul dan tombol dinonaktifkan) dan Karakter Tersusun?
Seseorang dari PTXPrint memberi tahu saya untuk melihat akhir dari XeTeX Log dan sesuai saran mereka, saya menemukan
berikutnya:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

Bahasa Satere-Mawe (SAT) menggunakan vokal bersuara hidung, y bersuara hidung, dan tanda apostrof lurus untuk glotal.
MarkTNR Satere adalah font yang saya gunakan, tetapi nomor unicode karakter yang hilang berbeda dari karakter yang sama
dalam font yang saya gunakan (yaitu setelah simbol >).

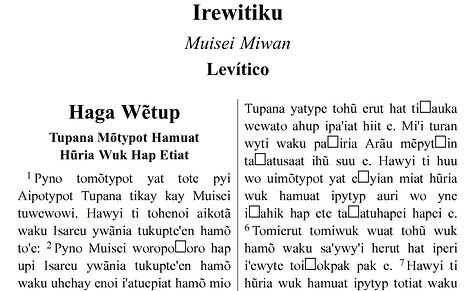
Oleh karena itu, simbol karakter persegi panjang yang tidak dikenali yang muncul ketika saya mencetak menggunakan PTXPrint adalah karakter
yang hilang di atas. Dengan某种 cara, input di Paratext tampaknya tidak menggunakan font MarkTNR Satere meskipun ini adalah
font yang dikonfigurasi dalam proyek?

Beberapa orang telah menyarankan bahwa proyek dapat dikonversi dengan某种 cara sehingga saya anon421222't perlu menggunakan font
khusus. Tetapi sejauh ini tidak ada yang menjelaskan bagaimana cara mencapainya? Saya bersedia melakukan pekerjaannya, tetapi saya anon421222't tahu apa yang harus dilakukan! Saya
sudah mencoba mencari tahu tentang mengonversi proyek, tetapi tampaknya sudah dikonfigurasi untuk unicode dan Karakter Tersusun?

Di bawah ini adalah tangkapan layar dari kesalahan yang saya dapatkan ketika menggunakan PTXPrint untuk mencetak ke PDF. Karakter yang hilang di Imamat tampaknya adalah
glotal, tetapi di buku-buku lain, vokal bersuara hidung yang tidak dikenali?
Bantuan Anda sangat dihargai! Tuhan memberkati!

anon165192

Diterjemahkan secara otomatis dari English
0 suara

Dari apa yang Anda katakan di atas, font MarkNTR Satere Anda tidak sesuai dengan Unicode. Font tersebut telah mengganti karakter seperti y diaeresis dengan y tilde dan itu perlu diperbaiki. Saya percaya rutinitas cari/ganti sederhana akan berfungsi.
Cari U+0027 Ganti U+A78C
Cari U+00FF > U+1EF9
Cari U+00E6 > U+1EBD
Cari U+00F0 > U+0129

Anda mungkin memiliki codepoint yang diretas lainnya. Anda perlu melakukan itu untuk setiap vokal bersuara hidung dan karakter khusus lainnya dalam ortografi Anda. Maka Anda harus bisa beralih ke penggunaan Charis SIL, tetapi Anda juga perlu beralih keyboard. Jika Anda memiliki file sumber untuk keyboard Anda, saya bisa membantu Anda mengubahnya untuk mengeluarkan karakter yang sesuai dengan Unicode.

Diterjemahkan secara otomatis dari English
oleh (329 poin)

Halo Lorna, tidak yakin apa yang saya katakan yang menunjukkan bahwa font tersebut tidak sesuai dengan unicode? Pengalihan keyboard otomatis entah bagaimana menjadi nonaktif, yang berarti bahwa font biasa digunakan untuk input alih-alih font yang saya gunakan. Ketika saya mengaktifkan pengalihan keyboard, saya mampu menemukan dan mengganti karakter secara manual. Selain itu, tidak yakin di mana Anda dapat menemukan dan mengganti menggunakan angka unicode seperti yang Anda sarankan? Saya takut saya anon421222’t tahu cara menggunakan angka unicode dengan cara itu? Namun, saya dapat mengirimkan font kepada Anda untuk Anda lihat.
fontsetc_.zip (99.9 KB)

Diterjemahkan secara otomatis dari English
+1 suara

Terima kasih atas font-nya! Itu sangat membantu. Yang Anda miliki adalah apa yang kadang-kadang kami sebut font hacked atau font “custom-encoded”. Kami dulu sering melakukan itu sebelum Unicode karena itu adalah satu-satunya cara kami bisa mendapatkan karakter yang kami butuhkan. Jadi, meskipun terasa seperti Unicode bagi Anda, beberapa karakter didefinisikan ulang dari Unicode sebenarnya. Dengan demikian, milik Anda kemungkinan besar adalah satu-satunya font di dunia yang memiliki pemetaan ini. Jika Anda kehilangan asosiasi data Anda dari font ini, tidak ada yang akan tahu apa karakter yang seharusnya (oleh karena itu kotak-kotak persegi)

Sebagai contoh, karakter Unicode ÿ (U+00FF) didefinisikan ulang menjadi y dengan tilde. Dalam angka Unicode, itu akan menjadi ỹ (U+1EF9).

Pada titik ini, Anda mungkin tidak ingin melalui proses mengkonversi data Anda ke Unicode. Tetapi, jika Anda bersedia melakukan itu dan jika seseorang bisa membantu Anda, saya bersedia membuat file pemetaan yang akan memetakan codepoint kustom Anda ke codepoint Unicode yang benar. Saya bisa melakukan itu berdasarkan apa yang saya lihat di font.

Anda perlu melakukan konversi data dan pembaruan keyboard pada saat yang sama.

Untuk stabilitas data jangka panjang, Anda benar-benar harus mengkonversi ke Unicode, tetapi saya anon421222’t tahu proses apa dalam terjemahan yang sedang Anda lakukan.

Diterjemahkan secara otomatis dari English
oleh (329 poin)

Halo Lorna,

Anda dan saya mencapai kesimpulan yang sama. Saya juga percaya ini adalah hasil dari font hacked. Saya akan mengirim email kepada Anda dan anon165192 off-list untuk melihat apa yang bisa kami lakukan.

james_post

Diterjemahkan secara otomatis dari English
0 suara

Anda dapat menemukan lebih banyak detail di topik Bantuan Paratext

Teks proyek saya menggunakan font “kustom”. Bagaimana cara mengonversinya ke Unicode?

Mengacu pada item tersebut, Lorna menawarkan untuk menyediakan file pemetaan (.map) yang dapat digunakan untuk konversi. Anda akan membutuhkan keyboard yang direvisi yang akan mengeluarkan karakter Unicode (atau Anda bisa menemukan keyboard yang menghasilkan karakter yang Anda butuhkan dan menggunakan itu). Setelah beralih ke Unicode, Anda akan memiliki pilihan dari sejumlah besar font, jadi itu seharusnya bukan masalah (kecuali font kustom yang telah Anda gunakan kemungkinan tidak akan berfungsi).

Diterjemahkan secara otomatis dari English
oleh (296 poin)

Hei anon806807, terima kasih atas itu! Ya, baik Lorna maupun james_post sedang berkomunikasi dengan saya dan Lorna sedang mengerjakan .map. Setelah mengkonversi ke unicode, saya anon421222’t berpikir saya akan membutuhkan font yang telah saya gunakan lagi.

Diterjemahkan secara otomatis dari English

Pertanyaan terkait

0 suara
0 jawaban 54 tampilan
Menurut saya, opsi spasi dan karakter tersembunyi (WHC) akan berdampak signifikan pada proyek kami. Opsi ini ... lain, dan mungkin mendapat tanggapan dari para pengembang.
Kent Spielmann 1,8k bertanya Nov 19, 2024
0 suara
2 jawaban 508 tampilan
Saya memiliki angka seperti 3 000 000 dalam teks saya. Periksa inventaris karakter menunjukkan kesalahan: initial ... sebagai valid, bagaimana cara saya mengatasi masalah ini?
anon057624 136 bertanya Sep 6, 2021
0 suara
6 jawaban 614 tampilan
Saya sedang mencoba mengubah karakter terurai (decomposed characters) dalam proyek saya (Manya - mzj) menjadi karakter ... ada ide tentang cara menyelesaikan masalah-masalah ini?
anon055151 176 bertanya Mar 22, 2021
0 suara
1 jawaban 398 tampilan
Saya telah membuat proyek transliterasi baru, dan sedang mencoba menerapkan beberapa perubahan yang konsisten untuk melengkapi ... untuk perilaku ini. Saya kebingungan. Ada saran?
DVM 175 bertanya Okt 20, 2020
0 suara
2 jawaban 489 tampilan
Penerjemah vernakular ingin menampilkan huruf Ibrani di awal setiap bagian dalam Mazmur 119. Font yang mereka gunakan ... Mereka ingin judul bagian pertama menjadi: א Alep John
anon084052 157 bertanya Mei 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Live in harmony with one another. Do not be proud, but be willing to associate with people of low position. Do not be conceited.
Romans 12:16
3,052 pertanyaan
6,011 jawaban
5,677 komentar
2,032 pengguna






