0 वोट
844 व्यूज़

नमस्ते, मैं Paratext की नवीनतम संस्करण, WIN10 और PTXPrint का उपयोग कर रहा/रही हूँ। Satere (SAT) भाषा में नासिक स्वर (nasalized vowels) का उपयोग होता है। मुझे नासिक स्वरों में परिवर्तन के लिए एक विशेष फ़ॉन्ट इंस्टॉल है। सीधा एपॉस्ट्रॉफ़ (') ग्लॉटल (glottal) का प्रतिनिधित्व करने के लिए उपयोग किया जाता है। जब मैं PTXPrint का उपयोग करके Genesis या Exodus प्रिंट करता/करती हूँ, तो ये सभी वर्ण PDF दस्तावेज़ में सामान्य रूप से दिखाई देते हैं। लेकिन, Leviticus में एपॉस्ट्रॉफ़ एक वर्ग के रूप में दिखाई देता है (अर्थात् अपरिचित वर्ण?) PDF में? NUM DEUT MATT में स्वर वर्ग के रूप में दिखाई देते हैं? कॉन्फ़िगरेशन मदद नहीं करता? यदि कोई इस व्यवहार को ठीक करने में मेरी मदद कर सके, तो मैं आभारी रहूँगा/रहूँगी! इसके अलावा, मैंने वर्गों को उचित वर्णों से बदलने के लिए PDF को Word दस्तावेज़ (DOCX) में परिवर्तित करने का भी प्रयास किया, लेकिन जहाँ वर्ग दिखाई देते हैं, वहाँ परिवर्तन के दौरान अचानक वाक्य का आधा हिस्सा गायब हो जाता है? मैंने वर्ण और विराम चिह्न सूची (inventories) की जाँच की जहाँ कुछ समस्याएँ थीं, लेकिन जब मैं PTXPrint के साथ प्रिंट करने की कोशिश करता/करती हूँ, तो अपरिचित वर्णों की समस्या जारी है?

English से मशीन-अनुवादित
Paratext में द्वारा (116 अंक)
फिर से दिखाया गया | 844 व्यूज़

5 उत्तर

0 वोट
सर्वोत्तम उत्तर

नमस्ते anon165192.
यदि लेआउट पहले से ही NFC के रूप में परिभाषित है, तो XeTeX संदेश से मैं जो एकमात्र चीज़ सोच सकता/सकती हूँ वह यह है कि आप Paratext और PTXprint में वही फ़ॉन्ट उपयोग नहीं कर रहे हैं।

XeTeX संदेश से प्रतीत होता है कि आप “MarkTNR Satere” फ़ॉन्ट का उपयोग करना चाहते हैं। क्या यह संभव है कि आप Paratext में कोई अन्य फ़ॉन्ट उपयोग कर रहे हैं?
आप जाँच सकते हैं कि क्या दोनों कार्यक्रमों में वही फ़ॉन्ट कॉन्फ़िगर किया गया है।

यदि नहीं, तो PTXprint में इस विकल्प पर जाने का प्रयास करें। टैब “Fonts + Sripts” और इन 4 फ़ील्ड्स को अपने फ़ॉन्ट में बदलें (Regular, Bold, Italic, Bold Italic)। फिर अपने PDF को जनरेट करने का प्रयास करें।

Saludos,
anon689242.

English से मशीन-अनुवादित
द्वारा (973 अंक)
फिर से दिखाया गया

नमस्ते anon689242,

आपकी मदद के लिए धन्यवाद! मैंने वह प्रयास किया लेकिन Paratext और PTXprint दोनों MarkNTR Satere फ़ॉन्ट का उपयोग करने के लिए कॉन्फ़िगर किए गए हैं!
बहुत खोजबीन करने और सवाल पूछने के बाद, मैंने अंततः एक अस्थायी समाधान पाया। स्वचालित कीबोर्ड स्विचिंग
किसी तरह Paratext में अक्षम हो गई थी। इसलिए, Genesis और Exodus ठीक से प्रिंट होते हैं, लेकिन अन्य पुस्तकों में ऐसे वर्ण थे जो
मेरे उपयोग किए जाने वाले फ़ॉन्ट से संबंधित नहीं थे (अर्थात् गलत कीबोर्ड = गलत इनपुट फ़ॉन्ट)! कीबोर्ड स्विचिंग को सक्षम करने के बाद, मुझे
प्रत्येक वर्ण को मैन्युअली खोजने और बदलने के लिए मजबूर होना पड़ा और अब पुस्तकें ठीक से प्रिंट हो रही हैं!

हालाँकि, यह केवल एक अस्थायी समाधान है। कुछ लोगों ने सुझाव दिया है कि Paratext को इस तरह कॉन्फ़िगर किया जा सकता है कि मुझे अब
विशेष फ़ॉन्ट का उपयोग करने की आवश्यकता न हो? लेकिन अभी तक किसी ने इसकी उपलब्धि का तरीका समझाया नहीं है? मैंने Convert Project और
Project Properties डायलॉग्स की जाँच की है। Convert Project डायलॉग में Composed Characters(NFC) के लिए विकल्प नहीं है, लेकिन Project Properties
डायलॉग पहले से ही unicode और Composed Characters(NFC) के लिए कॉन्फ़िगर किया गया है। इसलिए, मेरा मानना है कि परियोजना पहले से ही कॉन्फ़िगर की गई है?
लेकिन मैं Paratext को इस तरह कैसे कॉन्फ़िगर करूँ कि मैं कोई भी फ़ॉन्ट उपयोग कर सकूँ और फिर भी नासिक स्वर, नासिक y और सीधा
एपॉस्ट्रॉफ़ का इनपुट कर सकूँ जो ग्लॉटल का प्रतिनिधित्व करता है?

आपकी मदद के लिए आभारी हूँ!

anon165192

English से मशीन-अनुवादित
0 वोट

मेरे लिए ऐसा लगता है कि आपके पास मिश्रित एन्कोडिंग (mixed encoding) हो सकती है, जहाँ परियोजना के कुछ हिस्से अलग-अलग कोडपॉइंट्स का उपयोग कर रहे हैं। आपको शायद किसी ऐसे व्यक्ति की आवश्यकता होगी जो आपके साथ बैठकर इसे ठीक कर सके।

आपने एक “विशेष” फ़ॉन्ट का उल्लेख किया है। वह शब्द मुझे डराता है। मैं मानता/मानती हूँ कि इसका अर्थ है कि यह कस्टम-एन्कोडेड है और केवल उसी फ़ॉन्ट के साथ काम करेगा। यदि यह पहले से ही Unicode में नहीं है, तो आपको किसी ऐसे व्यक्ति को मदद करने के लिए बुलाना चाहिए जो आपकी पूरी परियोजना को Unicode में पूरी तरह से परिवर्तित कर सके। तब आपको विशेष फ़ॉन्ट की आवश्यकता नहीं होगी, आप लगभग कोई भी सामान्य लैटिन फ़ॉन्ट उपयोग कर सकते हैं।

English से मशीन-अनुवादित
द्वारा (329 अंक)

नमस्ते Lorna, आपके उत्तर के लिए धन्यवाद। मैंने Paratext में कुछ चीज़ें जोड़ी हैं जिनका मैं प्रयास कर रहा/रही हूँ लेकिन जिनसे मदद नहीं मिली। मुझे पक्का नहीं है कि मैं मिश्रित एन्कोडिंग और कोडपॉइंट्स के बारे में आपका बिंदु समझ रहा/रही हूँ - क्या आप और विस्तार से समझा सकते हैं? मुझे डर है कि मेरे पास कोई नहीं है जो मेरे साथ बैठे क्योंकि मैं एक स्वतंत्र अनुवादक हूँ। यदि आप मुझे किसी ऐसे व्यक्ति की ओर इशारा कर सकते हैं जो मदद कर सके, तो मैं बहुत आभारी रहूँगा/रहूँगी। विरोधाभासी रूप से, मैं Leviticus के लिए वही कॉन्फ़िगरेशन उपयोग कर रहा/रही हूँ जो मैंने Genesis और Exodus के लिए उपयोग किया था। इसलिए समझने में कठिनाई है कि Paratext या PTXPrint Leviticus, Numbers, Deuteronomy और Matthew को अलग-अलग कैसे व्याख्या करता है? “विशेष फ़ॉन्ट” कई वर्षों पहले New Tribes प्रिंट शॉप विशेषज्ञ द्वारा बनाया गया था, इसलिए मुझे वहाँ कोई समस्या नहीं दिखती। यह Word या Paratext में ठीक से काम करता है, सिवाय नासिक y के, जिसे मैं Paratext में काम नहीं कर पा रहा/पा रही हूँ? इसके अलावा, ग्लॉटल का प्रतिनिधित्व करने के लिए सीधे एपॉस्ट्रॉफ़ (') का उपयोग कभी-कभी शब्द को दो अलग-अलग शब्दों के रूप में व्याख्या करने का कारण बनता है (अर्थात् शब्द विभाजन)? हालाँकि, यह वही फ़ॉन्ट है जिसका उपयोग Genesis और Exodus के लिए किया गया है जो ठीक से प्रिंट होते हैं? मैं आपकी बात पर बहुत आभारी रहूँगा/रहूँगी कि आप पूरी परियोजना को unicode में परिवर्तित करने के बारे में बता रहे हैं (यदि यह पहले से ही नहीं है)! मुझे नहीं पता कि इसे कैसे किया जाता है, लेकिन मैं इसकी जाँच करूँगा/करूँगी और देखूँगा/देखूँगी कि मैं इसे कैसे समझ सकता/समझ सकती हूँ। अभी के लिए धन्यवाद! भगवान आपकी आशीष करें!

English से मशीन-अनुवादित

संभावित उपयोग के लिए:
मैं अपने Paratext परियोजना डेटा को कैसे सुसंगत बना सकता/सकती हूँ?

नई परियोजना के लिए:

संयुक्त (composed) और विघटित (decomposed) वर्णों के मिश्रण वाले परियोजना डेटा के कारण होने वाली समस्याओं से बचने के लिए, जब आप Paratext 8.0 (और बाद के संस्करणों) में एक नई परियोजना बनाते हैं, तो Project properties डायलॉग के Advanced टैब पर एक “Normalization” ड्रॉप-डाउन होता है।

डिफ़ॉल्ट Normalization Composed characters (NFC) है। इसका अर्थ है कि जब Paratext परियोजना को सेव करता है, तो यह सभी परियोजना डेटा को संयुक्त वर्णों में परिवर्तित कर देता है।
यदि आप चाहते हैं कि Paratext परियोजना को सेव करते समय सभी परियोजना डेटा को विघटित वर्णों में परिवर्तित कर दे, तो परियोजना बनाने पर Decomposed characters (NFD) का चयन करें।

यदि आप चाहते हैं कि Paratext परियोजना डेटा को Composed और Decomposed वर्णों के मिश्रण के रूप में संग्रहीत करने की अनुमति दे, तो परियोजना बनाने पर Off (no normalization) का चयन करें।
हम “Off (no normalization)” का चयन करने की सिफ़ारिश नहीं करते, जब तक कि परियोजना भाषा की वर्तनी (orthography) में diacritics का गैर-मानक तरीके से उपयोग न हो और diacritics के होने का क्रम महत्वपूर्ण न हो।

मौजूदा परियोजना के लिए:

यदि आपकी परियोजना में संयुक्त और विघटित वर्णों के मिश्रण वाला डेटा है (संभवतः अलग-अलग कीबोर्ड लेआउट का उपयोग करने के कारण), तो सभी डेटा को सुसंगत बनाने के लिए निम्नलिखित करें।

  1. अपनी परियोजना के टैब पर क्लिक करें ताकि यह सक्रिय टैब बन जाए।
  2. अपनी परियोजना में टैब मेनू आइकन पर क्लिक करें, फिर Project मेनू से, Project settings की ओर इशारा करें, और Project properties का चयन करें।
  3. Advanced टैब पर, Normalization ड्रॉप-डाउन सूची में निम्नलिखित में से एक का चयन करें।
  • Composed characters (NFC) (डेटा को संयुक्त वर्णों के रूप में सेव करने के लिए)।
  • Decomposed characters (NFD) (डेटा को विघटित वर्णों के रूप में सेव करने के लिए)।
  1. OK पर क्लिक करें।
    Paratext आपकी परियोजना में सभी डेटा को उस normalization विकल्प में बदल देता है जिसे आपने चुना है।
    एक बार जब संयुक्त और विघटित वर्णों के मिश्रण वाली परियोजना का डेटा सुसंगत बना दिया जाता है, तो सभी टीम सदस्यों को परियोजना को Send/Receive करना चाहिए।

यदि आप चाहते हैं कि Paratext परियोजना डेटा को Composed और Decomposed वर्णों के मिश्रण के रूप में संग्रहीत करने की अनुमति दे, तो Normalization ड्रॉप-डाउन सूची से Off (no normalization) का चयन करें।
हम “Off (no normalization)” का चयन करने की सिफ़ारिश नहीं करते, जब तक कि परियोजना भाषा की वर्तनी में diacritics का गैर-मानक तरीके से उपयोग न हो और diacritics के होने का क्रम महत्वपूर्ण न हो।

English से मशीन-अनुवादित

नमस्ते anon421222,

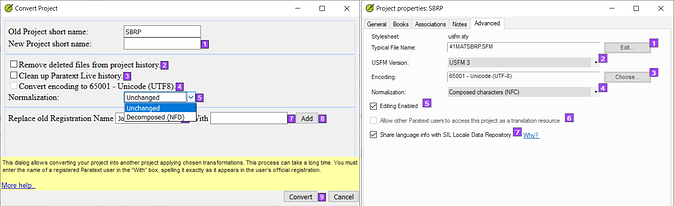
उस जानकारी के लिए धन्यवाद! जितना मैं बता सकता/सकती हूँ, मेरी परियोजना पहले से ही unicode और
Composed Characters के रूप में कॉन्फ़िगर की गई है (नीचे स्क्रीनशॉट देखें)! बाईं ओर Convert Project डायलॉग है जो
Composed Characters के लिए विकल्प नहीं दिखाता है। लेकिन दाईं ओर Project Properties ऐसा दिखाते हैं कि
परियोजना unicode के रूप में कॉन्फ़िगर की गई है (अर्थात् unicode दिखाई देता है और बटन अक्षम है) और Composed Characters?
PTXPrint के किसी व्यक्ति ने मुझे XeTeX Log के अंत को देखने के लिए कहा और उनके सुझाव के अनुसार मैंने
निम्नलिखित पाया:

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

Satere-Mawe (SAT) भाषा में नासिक स्वर, नासिक y और ग्लॉटल के लिए सीधा एपॉस्ट्रॉफ़ का उपयोग होता है।
MarkTNR Satere वह फ़ॉन्ट है जिसका मैं उपयोग करता/करती हूँ, लेकिन गायब वर्णों का unicode नंबर अलग है
जो मैं उपयोग करने वाले फ़ॉन्ट में उसी वर्ण से है (अर्थात् > प्रतीक के बाद)।

इसलिए, PTXPrint का उपयोग करके प्रिंट करने पर जो आयताकार अपरिचित वर्ण प्रतीक दिखाई देते हैं, वे
ऊपर दिए गए गायब वर्ण हैं। किसी तरह Paratext में इनपुट MarkTNR Satere फ़ॉन्ट का उपयोग नहीं करता है, हालाँकि यह
वह फ़ॉन्ट है जो परियोजना में कॉन्फ़िगर किया गया है?

कुछ लोगों ने सुझाव दिया है कि परियोजना को किसी तरह परिवर्तित किया जा सकता है ताकि मुझे विशेष
फ़ॉन्ट का उपयोग करने की आवश्यकता न हो। लेकिन अभी तक किसी ने इसकी उपलब्धि का तरीका समझाया नहीं है? मैं काम करने के लिए तैयार हूँ, लेकिन मुझे नहीं पता कि क्या करना है!
मैंने परियोजना को परिवर्तित करने की जाँच की है, लेकिन यह प्रतीत होता है कि यह पहले से ही unicode और Composed Characters के लिए कॉन्फ़िगर की गई है?

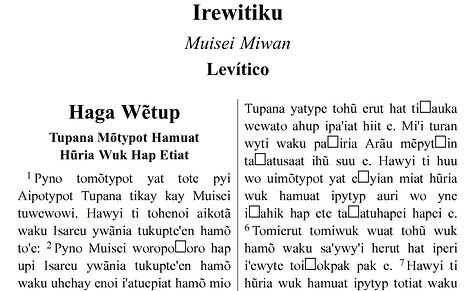
नीचे वह स्क्रीनशॉट है जो त्रुटि दिखाता है जब मैं PDF में प्रिंट करने के लिए PTXPrint का उपयोग करता/करती हूँ। Leviticus में गायब वर्ण प्रतीत
होते हैं ग्लॉटल, लेकिन अन्य पुस्तकों में यह नासिक स्वर हैं जो पहचाने नहीं जा रहे?
आपकी मदद का बहुत-बहुत आभार! भगवान आपकी आशीष करें!

anon165192

English से मशीन-अनुवादित

0 वोट

ऊपर आपकी बातों से, आपका MarkNTR Satere फ़ॉन्ट Unicode अनुपालक (compliant) नहीं है। इसमें y diaeresis जैसे वर्णों को y tilde से बदल दिया गया है और उन्हें ठीक करने की आवश्यकता है। मुझे विश्वास है कि एक सरल find/replace रूटीन काम करेगा।
Find U+0027 Replace U+A78C
Find U+00FF > U+1EF9
Find U+00E6 > U+1EBD
Find U+00F0 > U+0129

हालाँकि, आपके पास अन्य हैक्ड कोडपॉइंट्स हो सकते हैं। आपको अपनी वर्तनी में प्रत्येक नासिक स्वर और किसी भी अन्य विशेष वर्ण के साथ ऐसा करना होगा। तब आप Charis SIL का उपयोग करने में सक्षम होंगे, लेकिन आपको कीबोर्ड भी बदलने होंगे। यदि आपके पास आपके कीबोर्ड का स्रोत फ़ाइल है, तो मैं आपकी मदद कर सकता/सकती हूँ ताकि इसे Unicode अनुपालक वर्णों को आउटपुट करने के लिए बदला जा सके।

English से मशीन-अनुवादित
द्वारा (329 अंक)

लोरना, नमस्ते। मुझे पता नहीं कि मैंने ऐसा क्या कहा जिससे यह संकेत मिलता है कि फ़ॉन्ट यूनिकोड-संगत (unicode compliant) नहीं है? ऑटोमैटिक कीबोर्ड स्विचिंग (Automatic keyboard switching) किसी तरह से अक्षम (disabled) हो गई थी, जिसका अर्थ है कि इनपुट के लिए एक सामान्य फ़ॉन्ट का उपयोग हो रहा था, न कि वह फ़ॉन्ट जिसका मैं उपयोग करता हूँ। जब मैंने कीबोर्ड स्विचिंग सक्षम (enabled) किया, तो मैंने मैन्युअली चरों (characters) को खोजने और बदलने (Find and Replace) में सफलता प्राप्त की। साथ ही, मुझे पता नहीं कि आपकी सलाह के अनुसार यूनिकोड नंबरों का उपयोग करके खोज और प्रतिस्थापन (Find and Replace) कहाँ किया जा सकता है? मुझे डर है कि मुझे पता नहीं कि उस तरह से यूनिकोड नंबरों का उपयोग कैसे किया जाए? हालाँकि, मैं आपको वह फ़ॉन्ट भेज सकता हूँ ताकि आप उसे देख सकें।
fontsetc_.zip (99.9 KB)

English से मशीन-अनुवादित
+1 मत

फ़ॉन्ट के लिए धन्यवाद! यह मददगार है। जो आपके पास है, उसे हम कभी-कभी हैक्ड (hacked) फ़ॉन्ट या “कस्टम-एन्कोडेड” (custom-encoded) फ़ॉन्ट कहते हैं। हमने यूनिकोड से पहले इसे बहुत बार किया क्योंकि हमारे पास हमें ज़रूरी चर (characters) प्राप्त करने का यही एकमात्र तरीका था। इसलिए, हालाँकि यह आपको यूनिकोड जैसा लगता है, कुछ चरों को वास्तविक यूनिकोड से पुनर्परिभाषित (redefined) किया गया था। इस प्रकार, संभवतः आपका ही दुनिया का एकमात्र फ़ॉन्ट है जिसमें यह मैपिंग है। यदि आपका डेटा इस फ़ॉन्ट से असंबद्ध हो जाता, तो कोई भी यह नहीं जान पाएगा कि चरों को क्या होना चाहिए (इसलिए वर्ग आकार के बॉक्स दिखते हैं)।

उदाहरण के लिए, यूनिकोड चर ÿ (U+00FF) को पुनर्परिभाषित करके टिल्ड (tilde) वाला y बना दिया गया था। यूनिकोड नंबरों में, वह ỹ (U+1EF9) होगा।

इस बिंदु पर, आप शायद अपने डेटा को यूनिकोड में परिवर्तित करने की प्रक्रिया से गुज़रना नहीं चाहेंगे। लेकिन, यदि आप ऐसा करने के लिए तैयार हैं और यदि कोई आपकी मदद कर सकता है, तो मैं एक मैपिंग फ़ाइल (mapping file) बनाने के लिए तैयार हूँ जो आपके कस्टम कोडपॉइंट्स को सही यूनिकोड कोडपॉइंट्स में मैप करेगी। मैं फ़ॉन्ट में जो मैं देखता हूँ, उसके आधार पर ऐसा कर सकता हूँ।

आपको डेटा रूपांतरण और कीबोर्ड अपडेट एक ही समय पर करने होंगे।

लंबे समय तक डेटा स्थिरता के लिए आपको वास्तव में यूनिकोड में परिवर्तन करना चाहिए, लेकिन मुझे पता नहीं कि आप अनुवाद में किस प्रक्रिया में हैं।

English से मशीन-अनुवादित
द्वारा (329 अंक)

लोरना, नमस्ते,

आप और मैंने एक ही निष्कर्ष निकाला। मैं भी मानता हूँ कि यह एक हैक्ड फ़ॉन्ट का परिणाम है। मैं आपको ईमेल करूँगा और anon165192 को लिस्ट से बाहर (off-list) देखने के लिए कि हम क्या कर सकते हैं।

james_post

English से मशीन-अनुवादित
0 वोट

आप Paratext Help विषय में और विवरण पा सकते हैं

मेरा प्रोजेक्ट टेक्स्ट एक “कस्टम” फ़ॉन्ट का उपयोग करता है। मैं इसे यूनिकोड में कैसे परिवर्तित करूँ?

उस आइटम का हवाला देते हुए, लोरना रूपांतरण के लिए उपयोग की जा सकने वाली एक मैपिंग (.map) फ़ाइल प्रदान करने की पेशकश कर रही हैं। आपको एक संशोधित कीबोर्ड की ज़रूरत होगी जो यूनिकोड चरों का आउटपुट दे (या आप एक ऐसा कीबोर्ड खोज सकते हैं जो आपको ज़रूरी चर दे और उसका उपयोग कर सकते हैं)। यूनिकोड में स्विच करने के बाद, आपके पास बहुत सारे फ़ॉन्टों में से चुनने का विकल्प होगा, इसलिए यह कोई समस्या नहीं होनी चाहिए (इसके अलावा कि आप जिस कस्टम फ़ॉन्ट का उपयोग कर रहे हैं, वह संभवतः काम नहीं करेगा)।

English से मशीन-अनुवादित
द्वारा (296 अंक)

हे anon806807, इसके लिए धन्यवाद! हाँ, लोरना और james_post दोनों मेरे साथ संपर्क कर रहे हैं और लोरना .map पर काम कर रही हैं। यूनिकोड में रूपांतरण के बाद, मुझे नहीं लगता कि मुझे उस फ़ॉन्ट की ज़रूरत होगी जिसका मैं उपयोग कर रहा हूँ।

English से मशीन-अनुवादित

संबंधित प्रश्न

0 वोट
0 उत्तर 54 व्यूज़
मेरे ख्याल में व्हाइटस्पेस और छिपे हुए कैरेक्टर (WHC) विकल्प हमारे प्रोजेक्ट्स पर गहरा प्रभाव डालेगा। इसमें कुछ वास्तविक लाभ ... रुचि है और शायद डेवलपर्स से भी कुछ सुनने को मिले।
Kent Spielmann 1.8k पूछा गया नवंबर 19, 2024
0 वोट
2 उत्तर 508 व्यूज़
मेरे पाठ में 3 000 000 जैसे अंक हैं। अक्षरों की सूची जाँच (characters inventory check) मुझे एक त्रुटि दिखाती है: ... रूप में जाँच सकूँ, मैं इस समस्या का समाधान कैसे करूँ?
anon057624 136 पूछा गया सितंबर 6, 2021
0 वोट
6 उत्तर 614 व्यूज़
मैं अपने प्रोजेक्ट (Manya - mzj) में विघटित वर्णों (decomposed characters) को संयुक्त वर्णों (composed characters) में बदलने की कोशिश ... कैसे हल किया जा सकता है, इस पर कोई सुझाव?
anon055151 176 पूछा गया मार्च 22, 2021
0 वोट
1 उत्तर 398 व्यूज़
मैंने एक नया लिप्यंतरण (transliteration) परियोजना बनाई है, और TecKit map के माध्यम से पहले से प्राप्त एक-से-एक लिप्यंतरण को ... नहीं देख पा रहा हूँ। मैं अटक गया हूँ। कोई सुझाव?
DVM 175 पूछा गया अक्टूबर 20, 2020
0 वोट
2 उत्तर 489 व्यूज़
एक स्थानीय भाषा के अनुवादक चाहते हैं कि भजन संहिता 119 के प्रत्येक खंड के आरंभ में एक हिब्रू अक्षर दिखाया जाए। उनके भाषा ... चाहते हैं कि पहला खंड शीर्षक इस प्रकार हो: א Alep जॉन
anon084052 157 पूछा गया मई 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
So Peter was kept in prison, but the church was earnestly praying to God for him.
Acts 12:5
3,052 प्रश्न
6,011 उत्तर
5,677 टिप्पणियाँ
2,032 उपयोगकर्ता





