0 votes
842 vues

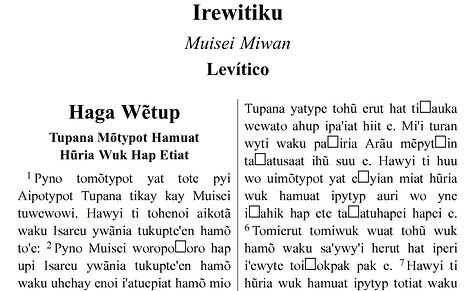
Bonjour, j'utilise la dernière version de Paratext, WIN10 et PTXPrint. La langue Satere (SAT) utilise des voyelles nasales. J'ai installé une police spéciale pour convertir en voyelles nasales. L'apostrophe droite (') est utilisée pour représenter la glottale. Lorsque j'imprime la Genèse ou l'Exode avec PTXPrint, tous ces caractères s'affichent normalement dans le document PDF. Mais, dans le Lévitique, l'apostrophe apparaît comme un carré (c'est-à-dire un caractère non reconnu ?) dans le PDF ? Dans les livres des Nombres, Deutéronome et Matthieu, les voyelles apparaissent-elles comme des carrés ? La configuration n'aide-t-elle pas ? Je serais reconnaissant si quelqu'un pouvait m'aider à corriger ce comportement ! J'ai également essayé de convertir le PDF en document Word (DOCX) afin de remplacer les carrés par le caractère approprié, mais là où les carrés apparaissent, soudainement la moitié de la phrase disparaît lors de la conversion ? Je viens de vérifier les inventaires des caractères et de la ponctuation où il y a quelques problèmes, mais le problème des caractères non reconnus lorsque j'essaie d'imprimer avec PTXPrint persiste ?

Traduit automatiquement depuis English
Paratext par (116 points)
réaffiché | 842 vues

5 Réponses

0 votes
Meilleure réponse

Bonjour anon165192.
Si la mise en page est déjà définie comme NFC, la seule chose à laquelle je puisse penser à partir du message XeTeX est que vous n'utilisez pas la même police dans Paratext et PTXprint.

D'après le message XeTeX, vous semblez vouloir utiliser la police « MarkTNR Satere ». Est-il possible que vous utilisiez une autre police dans Paratext ?
Vous pouvez vérifier si vous avez la même police configurée dans les deux programmes.

Si ce n'est pas le cas, essayez d'aller à cette option dans PTXprint. Onglet « Polices + Scripts » et modifiez ces 4 champs avec votre police (Normal, Gras, Italique, Gras Italique). Puis essayez de générer votre PDF.

Salutations,
anon689242.

Traduit automatiquement depuis English
par (973 points)
réaffiché

Bonjour anon689242,

Merci pour votre aide ! J'ai essayé cela, mais Paratext et PTXprint sont tous deux configurés pour utiliser la police MarkNTR Satere !
Après beaucoup de recherches et de questions, j'ai finalement trouvé une solution temporaire. Le changement automatique de clavier
a été désactivé d'une manière ou d'une autre dans Paratext. Ainsi, la Genèse et l'Exode s'impriment bien, mais d'autres livres contenaient des caractères qui
n'appartenaient pas anon421222 à la police que j'utilise (c'est-à-dire mauvais clavier = mauvaise police de saisie) ! Après avoir activé le changement de clavier, j'ai dû rechercher et remplacer manuellement
chaque caractère et maintenant les livres s'impriment très bien !

Cependant, ce n'est qu'une solution temporaire. Certaines personnes ont suggéré qu'il est possible de configurer Paratext pour que je n'aie plus besoin
d'utiliser une police spéciale ? Mais jusqu'à présent, personne n'a expliqué comment y parvenir ? J'ai vérifié les boîtes de dialogue Convertir le projet et
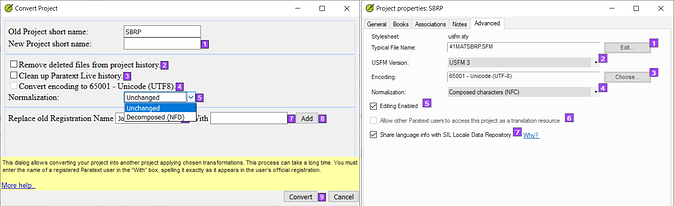
Propriétés du projet. La boîte de dialogue Convertir le projet n'a pas l'option Caractères composés (NFC), mais la boîte de dialogue Propriétés du projet
est déjà configurée pour Unicode et Caractères composés (NFC). Par conséquent, je crois que le projet est déjà configuré ?
Mais comment configurer Paratext pour pouvoir utiliser n'importe quelle police et toujours être en mesure de saisir des voyelles nasales, un y nasal et une apostrophe droite
qui représente la glottale ?

Je vous serais reconnaissant de votre aide !

anon165192

Traduit automatiquement depuis English
0 votes

Il me semble que vous pourriez avoir un codage mixte où certaines parties du projet utilisent des points de code différents. Il se peut que vous ayez besoin que quelqu'un s'assoie avec vous pour régler cela.

Vous mentionnez une police « spéciale ». Ce mot me fait peur. Je suppose que cela signifie qu'elle est codée sur mesure et ne fonctionnera qu'avec cette police. Vous devriez faire appel à quelqu'un pour vous aider à convertir complètement votre projet entier en Unicode s'il ne l'est pas déjà. Ensuite, vous n'aurez pas besoin d'une police spéciale, vous pourrez utiliser presque n'importe quelle police latine courante.

Traduit automatiquement depuis English
par (329 points)

Bonjour Lorna, merci pour votre réponse. Je viens d'ajouter quelques choses que j'essaie dans Paratext mais qui n'ont pas aidé. Je ne suis pas sûr de comprendre votre point sur le codage mixte et les points de code - pourriez-vous expliquer davantage ? Je crains que je n'aie pas anon421222 quelqu'un pour s'asseoir avec moi car je suis un traducteur indépendant. Si vous pouviez m'orienter vers quelqu'un qui peut m'aider, je vous en serais très reconnaissant. Ironiquement, j'utilise la même configuration pour le Lévitique que celle que j'ai utilisée pour la Genèse et l'Exode. D'où la difficulté à comprendre comment Paratext ou PTXPrint fonctionne pour interpréter le Lévitique, les Nombres, le Deutéronome et Matthieu différemment ? La « police spéciale » a été créée par le spécialiste de l'atelier d'impression New Tribes il y a des années, donc je ne vois anon421222 aucun problème là-bas. Elle fonctionne très bien dans Word ou Paratext, sauf pour le y nasal que je n'arrive pas à faire fonctionner dans Paratext ? De plus, l'utilisation de l'apostrophe droite (') pour représenter la glottale provoque parfois l'interprétation du mot comme deux mots séparés (c'est-à-dire une coupure de mot) ? Cependant, cette même police a été utilisée pour la Genèse et l'Exode qui s'impriment très bien ? Je serais très reconnaissant de l'aide de quelqu'un sur ce que vous mentionnez concernant la conversion du projet entier en Unicode (s'il ne l'est pas déjà) ! Je ne sais pas anon421222 comment faire, mais je vais m'en occuper et voir si je peux comprendre comment faire. Merci pour le moment ! Que Dieu vous bénisse !

Traduit automatiquement depuis English

Potentiellement utile :
Comment rendre les données de mon projet Paratext cohérentes ?

Pour un nouveau projet :

Pour éviter les problèmes causés par des données de projet avec un mélange de caractères composés et décomposés, lorsque vous créez un nouveau projet dans Paratext 8.0 (et versions ultérieures), il y a une liste déroulante « Normalisation » sur l'onglet Avancé de la boîte de dialogue des propriétés du projet.

La normalisation par défaut est Caractères composés (NFC). Cela signifie que lorsque Paratext enregistre le projet, il convertit toutes les données du projet en caractères composés.
Si vous préférez que Paratext convertisse toutes les données du projet en caractères décomposés lors de l'enregistrement du projet, sélectionnez Caractères décomposés (NFD) lors de la création du projet.

Si vous préférez autoriser Paratext à stocker les données du projet comme un mélange de caractères Composés et Décomposés, sélectionnez Désactivé (pas de normalisation) lors de la création du projet.
Nous ne recommandons PAS de sélectionner « Désactivé (pas de normalisation) » sauf si l'orthographe de la langue du projet utilise des diacritiques de manière non standard et que l'ordre dans lequel les diacritiques se produisent est important.

Pour un projet existant :

Si votre projet contient des données avec un mélange de caractères composés et décomposés (probablement dû à l'utilisation de différentes dispositions de clavier), effectuez les opérations suivantes pour forcer toutes les données à être cohérentes.

  1. Cliquez sur l'onglet de votre projet pour en faire l'onglet actif.
  2. Cliquez sur l'icône du menu de l'onglet dans votre projet, puis depuis le menu Projet, pointez sur Paramètres du projet et sélectionnez Propriétés du projet.
  3. Dans l'onglet Avancé, sélectionnez l'une des options suivantes dans la liste déroulante Normalisation.
  • Caractères composés (NFC) (pour que les données soient enregistrées en tant que caractères composés).
  • Caractères décomposés (NFD) (pour que les données soient enregistrées en tant que caractères décomposés).
  1. Cliquez sur OK.
    Paratext modifie toutes les données de votre projet selon l'option de normalisation que vous avez choisie.
    Une fois que les données du projet avec le mélange de caractères composés et décomposés ont été rendues cohérentes, demandez à tous les membres de l'équipe d'effectuer Send/Receive (Envoyer/Recevoir) du projet.

Si vous préférez autoriser Paratext à stocker les données du projet comme un mélange de caractères Composés et Décomposés, sélectionnez Désactivé (pas de normalisation) dans la liste déroulante Normalisation.
Nous ne recommandons PAS de sélectionner « Désactivé (pas de normalisation) » sauf si l'orthographe de la langue du projet utilise des diacritiques de manière non standard et que l'ordre dans lequel les diacritiques se produisent est important.

Traduit automatiquement depuis English

Bonjour anon421222,

Merci pour ces informations ! À ma connaissance, mon projet est déjà configuré en Unicode et
Caractères composés (voir la capture d'écran ci-dessous) ! À gauche se trouve la boîte de dialogue Convertir le projet qui n'affiche
pas l'option Caractères composés. Mais à droite, les Propriétés du projet semblent indiquer que
le projet est configuré en Unicode (c'est-à-dire que Unicode apparaît et que le bouton est désactivé) et Caractères composés ?
Quelqu'un de PTXPrint m'a dit de regarder la fin du journal XeTeX et, conformément à leur suggestion, j'ai trouvé
ce qui suit :

Missing character: There is no ꞌ (U+A78C) in font MarkTNR Satere! > ꞌ = U+0027
Missing character: There is no ỹ (U+1EF9) in font MarkTNR Satere! > ỹ = U+00FF
Missing character: There is no ẽ (U+1EBD) in font MarkTNR Satere! > ẽ = U+00E6
Missing character: There is no ĩ (U+0129) in font MarkTNR Satere! > ĩ = U+00F0

La langue Satere-Mawe (SAT) utilise des voyelles nasales, un y nasal et l'apostrophe droite pour la glottale.
MarkTNR Satere est la police que j'utilise, mais le numéro Unicode du caractère manquant est différent de celui du même caractère
dans la police que j'utilise (c'est-à-dire après le symbole >).

Par conséquent, les symboles rectangulaires de caractères non reconnus qui apparaissent lorsque j'imprime en utilisant PTXPrint sont les caractères
manquants ci-dessus. D'une manière ou d'une autre, la saisie dans Paratext semble ne pas utiliser la police MarkTNR Satere bien que ce soit
la police configurée dans le projet ?

Quelques personnes ont suggéré que le projet peut être converti d'une certaine manière pour que je n'aie plus anon421222 besoin d'utiliser une police
spéciale. Mais personne n'a réellement expliqué comment y parvenir ? Je suis prêt à faire le travail, mais je ne sais pas anon421222 quoi faire ! J'ai
essayé de chercher comment convertir le projet, mais il semble déjà être configuré pour Unicode et Caractères composés ?

Ci-dessous se trouve une capture d'écran de l'erreur que j'obtiens lorsque j'utilise PTXPrint pour imprimer en PDF. Les caractères manquants dans le Lévitique semblent être
la glottale, mais dans d'autres livres, ce sont les voyelles nasales qui ne sont pas reconnues ?
Votre aide est très appréciée ! Que Dieu vous bénisse !

anon165192

Traduit automatiquement depuis English
0 votes

D'après ce que vous dites ci-dessus, votre police MarkNTR Satere n'est pas conforme à Unicode. Elle a remplacé des caractères comme y tréma par y tilde et ceux-ci doivent être corrigés. Je pense qu'une simple routine de recherche/remplacement fonctionnerait.
Rechercher U+0027 Remplacer par U+A78C
Rechercher U+00FF > U+1EF9
Rechercher U+00E6 > U+1EBD
Rechercher U+00F0 > U+0129

Vous pourriez avoir d'autres points de code modifiés. Vous devez le faire pour chaque voyelle nasale et tout autre caractère spécial de votre orthographe. Ensuite, vous devriez pouvoir passer à l'utilisation de Charis SIL, mais vous devrez également changer de claviers. Si vous avez le fichier source de votre clavier, je pourrais vous aider à le modifier pour qu'il produise des caractères conformes à Unicode.

Traduit automatiquement depuis English
par (329 points)

Bonjour Lorna, je ne suis pas sûr de ce que j'ai dit qui indique que la police n'est pas conforme à Unicode ? Le changement automatique du clavier a été désactivé d'une manière ou d'une autre, ce qui signifie qu'une police standard était utilisée pour la saisie plutôt que la police que j'utilise. Lorsque j'ai activé le changement de clavier, j'ai pu rechercher et remplacer les caractères manuellement. De plus, je ne sais pas où vous pouvez rechercher et remplacer en utilisant des nombres Unicode comme vous le suggérez ? Je crains que je anon421222'sache pas comment utiliser les nombres Unicode de cette manière ? Cependant, je peux vous envoyer la police pour que vous puissiez l'examiner.
fontsetc_.zip (99,9 Ko)

Traduit automatiquement depuis English
+1 vote

Merci pour la police ! C'est utile. Ce que vous avez, c'est ce que nous appelons parfois une police modifiée ou une police « à encodage personnalisé ». Nous faisions cela beaucoup avant Unicode, car c'était la seule façon d'obtenir les caractères dont nous avions besoin. Ainsi, bien que cela vous paraisse être de l'Unicode, certains caractères ont été redéfinis par rapport à l'Unicode réel. Par conséquent, la vôtre est probablement la seule police au monde qui possède ce mappage. Si vous perdiez l'association de vos données avec cette police, personne ne saurait à quoi les caractères devraient correspondre (d'où les carrés vides)

Par exemple, le caractère Unicode ÿ (U+00FF) a été redéfini pour être un y avec une tilde. En nombres Unicode, cela serait ỹ (U+1EF9).

À ce stade, vous ne souhaitez peut-être pas passer par le processus de conversion de vos données en Unicode. Mais, si vous étiez disposé à le faire et si quelqu'un pouvait vous aider, je serais disposé à créer un fichier de mappage qui associerait vos points de code personnalisés aux points de code Unicode corrects. Je pourrais le faire en me basant sur ce que je vois dans la police.

Vous devriez effectuer la conversion des données et la mise à jour du clavier en même temps.

Pour la stabilité des données à long terme, vous devriez vraiment convertir en Unicode, mais je anon421222'sais pas à quel stade de la traduction vous en êtes.

Traduit automatiquement depuis English
par (329 points)

Bonjour Lorna,

Vous et moi sommes arrivés à la même conclusion. Je pense également que c'est le résultat d'une police modifiée. Je vous enverrai un e-mail et anon165192 hors liste pour voir ce que nous pouvons faire.

james_post

Traduit automatiquement depuis English
0 votes

Vous pouvez trouver plus de détails dans le sujet d'aide de Paratext

Mon texte de projet utilise une police « personnalisée ». Comment puis-je le convertir en Unicode ?

En référence à cet élément, Lorna propose de fournir un fichier de mappage (.map) qui pourrait être utilisé pour la conversion. Vous aurez besoin d'un clavier révisé qui produira des caractères Unicode (ou vous pourriez trouver un clavier qui produit les caractères dont vous avez besoin et l'utiliser). Après avoir basculé sur Unicode, vous aurez le choix parmi un grand nombre de polices, donc cela ne devrait pas poser de problème (sauf que la police personnalisée que vous avez utilisée ne fonctionnera probablement plus).

Traduit automatiquement depuis English
par (296 points)

Salut anon806807, merci pour cela ! Oui, Lorna et james_post communiquent avec moi et Lorna travaille sur le .map. Après conversion en Unicode, je anon421222'pense pas que j'aurai encore besoin de la police que j'ai utilisée jusqu'à présent.

Traduit automatiquement depuis English

Questions connexes

0 votes
0 réponses 54 vues
Il me semble que l'option espaces et caractères masqués (WHC) aura un impact significatif sur nos projets. Elle offre ... et peut-être par des retours de la part des développeurs.
Kent Spielmann 1,8k posée nov. 19, 2024
0 votes
2 réponses 508 vues
J'ai des nombres comme 3 000 000 dans mon texte. La vérification de l'inventaire des caractères me signale une ... le vérifier comme valide. Comment puis-je résoudre ce problème ?
anon057624 136 posée sept. 6, 2021
0 votes
6 réponses 614 vues
J'essaie de changer les caractères décomposés dans mon projet (Manya - mzj) en caractères composés. Mais lorsque j' ... vous des idées sur la manière de résoudre ces problèmes ?
anon055151 176 posée mars 22, 2021
0 votes
1 réponse 398 vues
J'ai créé un nouveau projet de translittération et j'essaie d'appliquer des modifications cohérentes pour compléter la ... à ce comportement. Je suis perplexe. Des suggestions ?
DVM 175 posée oct. 20, 2020
0 votes
2 réponses 489 vues
Un traducteur en langue vernaculaire souhaite afficher une lettre hébraïque au début de chaque section du Psaume 119. La police ... premier en-tête de section soit : א Alep John
anon084052 157 posée mai 12, 2020
Welcome to Support Bible, where you can ask questions and receive answers from other members of the community.
Finally, all of you, be like-minded, be sympathetic, love one another, be compassionate and humble.
1 Peter 3:8
3,052 questions
6,011 réponses
5,677 commentaires
2,032 utilisateurs






